Kai PDF neįdeda šrifto, HotPDF komponentas tą tekstą atvaizduoja įdiegtu Windows šriftu, parinktu per HPDFMapBaseFontToSystem: jis iškoduoja /BaseFont vardą, nukerpa stiliaus dalį, bando kelias rašybas, kol GDI patvirtina, kad šeima įdiegta, matuoja dingusius standartinio 14-eto pločius iš metrikams atitinkančių šriftų ir prieš piešdamas vienbaitus kodus paverčia Unicode. Kiekvienas tas žingsnis gyvuoja todėl, kad naivi versija tikruose failuose klysdavo. RenderLoadedPageToBitmap puslapių atvaizduotojas su įdėtomis programomis tvarkosi gerai; tai yra istorija apie šriftus, kurių faile iš viso nėra
Kodėl GDI tyliai nededo netinkamo pavidalo šrifto neįdėtam šriftui?
GDI niekada nepraneša apie dingusį šriftą: perduokite CreateFontIndirect nepažįstamą pavidalo vardą ir jis tyliai parinks pakaitalą, dažnai kitokį serifą be pastorintos puses. Ankstyvasis atvaizduotojas PDF vardą perdavinėjo beveik pažodžiui, tad TimesNewRoman,Bold, TimesNewRomanPS-BoldMT ir SegoeUI-Semibold visi nesutapdavo niekuo ir išeidavo tuo, ką GDI parinkdavo. Vardai gali būti ir blogesni. ISO 32000-1 §7.3.5 leidžia varde bet kokį baitą parašyti kaip #xx, o CJK gamintojai šriftų vardus įprastai rašo kaip pabėgtus UTF-8 arba senosios koduotės baitus; iki v2.766.69 patys pabėgimai tapdavo pavidalo vardu. HPDFMapBaseFontToSystem dabar pirmiausiai iškoduoja pabėgimus, grąžina teisėtą UTF-8 baitų seką kaip savo simbolius, o kitus aukštus baitus skaito sistemos koduotėje
Nukirpti stilių – ten, kur heuristika įkanda. Kablelis visuomet užbaigia šeimą (Arial,Bold duoda Arial), o brūkšnelis – tik tada, kai žodis po jo yra stilius: Bold, Italic, Oblique, Regular, Roman, Medium, Light, Black, Heavy, Semi, Demi, Thin, Extra, Ultra arba Condensed. Ta taisyklė MS-Mincho palieka sveiką, o Calibri-Light paverčia Calibri. Tada HotPDF bando šeimos rašybas, po to – šeimos rašybas be PSMT, MT arba PS priesagos. Nuo v2.768.18 tos rašybos dengia kiekvieną tarpų pasirinkimą vietose, kur gali prasidėti žodis: prie didžiosios raidės, kuriai prieš tai eina mažoji (MyriadPro tampa Myriad Pro), ties paskutine atkarpos didžiąja raide, kurią seka mažoji (UIGothic), ir po priekinio MS (MSPGothic) – nuo pilnai ištarpintos formos iki vardo tokio, koks parašytas; virš keturių tokių vietų bandoma tik pilnai ištarpinta ir sujungtoji rašybos. Ištarpinti aklai negalima, nes Windows kai kuriuos žodžius laiko sujungtus: SimSun įdiegtas būtent tokia rašyba, o MicrosoftYaHei, MicrosoftJhengHei ir MSPGothic priklauso Microsoft YaHei, Microsoft JhengHei ir MS PGothic. Iki v2.768.18 atvaizduotojas prieš kiekvieną vidinę didžiąją raidę dėdavo tarpą, tad MicrosoftYaHei ieškota kaip Microsoft Ya Hei ir niekada nesurasdavo. Kandidatas laikomas įdiegtu, kai CreateFontIndirect, po kurio seka GetTextFace, grąžina prašytą vardą arba, nuo v2.768.18, kai parinkto šrifto name lentelė jį išvardija kaip šeimą – pilną arba tipografinę šeimą bet kuria kalba; atsakymas talpinamas podėlyje pagal vardą, tad dokumentai su daugybe neįdiegtų šriftų daugiau nebeklausinėja Windows kiekvieno vardo kiekviename puslapyje
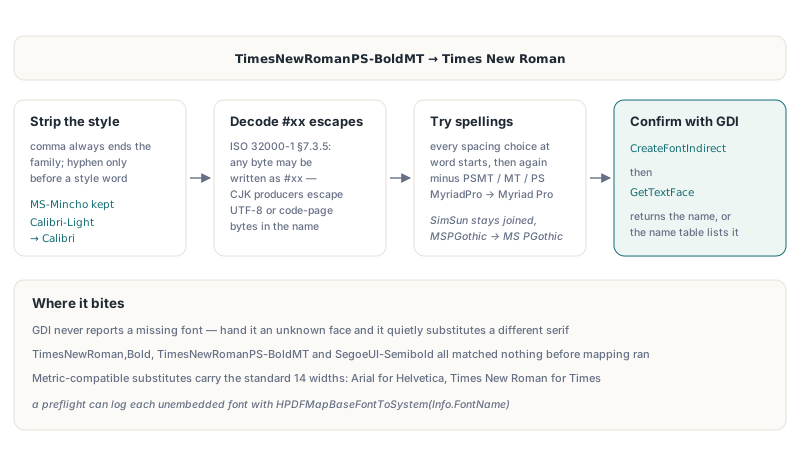
Kadangi atvaizdavimo funkcija yra vieša HPDFRenderFontMetrics unitas, išankstinės patikros ataskaita gali parodyti, su kurią įdiegtą šeimą atvaizduos kiekvienas neįdėtas šriftas, naudodama šriftų išvardijimą, kurį THotPDF jau atskleidžia pakrautiems dokumentams:
uses
  HPDFDoc, HPDFRenderFontMetrics;

procedure ListSystemFontMappings(Pdf: THotPDF; Log: TStrings);
var
  Page, I: Integer;
  Info: THPDFLoadedFontInfo;
begin
  for Page := 0 to Pdf.LoadedPageCount - 1 do
    for I := 0 to Pdf.GetLoadedFontCount(Page) - 1 do
      if Pdf.GetLoadedFontInfo(Page, I, Info) and not Info.IsEmbedded then
        Log.Add(Format('page %d  /%s  %s -> %s',
          [Page + 1, string(Info.ResourceName), string(Info.FontName),
           HPDFMapBaseFontToSystem(Info.FontName)]));
end;
Kaip HotPDF matuoja standartinio 14-eto šriftus be /Widths?
HotPDF dingusius žingsnius matuoja įdiegtu šriftu su tais pačiais metrikais, nes ISO 32000-1 §9.6.2.2 leidžia standartinio 14-eto šriftams praleisti /Widths, o biblioteka AFM lentelių nesiveža. Arial neša Helvetica metrikus, Times New Roman – Times, o Courier New – Courier, tad HPDFMeasureBaseFontWidths sukuria atitinkamą pavidalą ties lfHeight = -1000 ir kviečia GetCharWidth32W; tokiame aukštyje rezultatas jau yra 1/1000 em vienetais, kuriais naudojasi PDF pločiai. Atvaizduotojas pirmiausiai kiekvieną kodą per /Encoding, /BaseEncoding ir /Differences paverčia Unicode, pagal nutylėjimą rinkdamasis StandardEncoding. SVG eksportas ir teksto ištraukimas užkliūna dar už vienų spąstų: standartinis Type 1 šriftas visai be /Encoding pagimdydavo dekoderį be jokios kodavimo informacijos, SVG eksportas jo niekada neužregistruodavo, ir visi išmatuoti pločiai likdavo nepanaudoti. Numanytos StandardEncoding padavimas tai ištaiso, su sąlyga, kad ji pažymėta kaip iš anksto apibrėžta koduotė; nukreipus ją pro CMap vardo kelią kiekvienas kodas iškoduotų kaip 0 ir už jo eitų visi pločiai
Pastorintas, pasviręs ir vienetu paklydęs bitas šrifto aprašo vėliavėlėse
Šrifto aprašo /Flags įrašas savo bitus numeruoja nuo 1, o ne nuo 0, tad ForceBold yra 19 bitas ($40000), o Italic – 7 bitas ($40), pagal ISO 32000-1 123 lentelę. Senasis kodas tikrino $20000, kuris yra 18 bitas, SmallCap. Klaida išgyveno nuo v2.345.0 iki v2.766.53 todėl, kad /FontDescriptor beveik visuomet yra netiesioginė nuoroda, o šriftų kūrėjas skaitė tik tiesioginius objektus, tad visa vėliavėlių šaka niekada nesuveikdavo, ir tas pats apakimas ignoruodavo /Widths 12 0 R bei išdėstydavo tekstą 500 vienetų atsarginiu žingsniu. Kai v2.766.53 pradėjo spręsti netiesiogines nuorodas pro atvaizduotoją, bitą teko ištaisyti tame pačiame pakeitime, kitaip kiekvienas small-caps pavidalas staiga atvaizduotų pastorintas:
const
  // ISO 32000-1 123 lentelė bitų pozicijas skaičiuoja nuo 1
  FD_ITALIC     = $00040;  // 7 bitas
  FD_SMALLCAP   = $20000;  // 18 bitas, ne svoris
  FD_FORCEBOLD  = $40000;  // 19 bitas

procedure ApplyDescriptorFlags(Flags: Integer; var LF: TLogFont);
begin
  if (Flags and FD_FORCEBOLD) <> 0 then
    LF.lfWeight := FW_BOLD;
  if (Flags and FD_ITALIC) <> 0 then
    LF.lfItalic := 1;
end;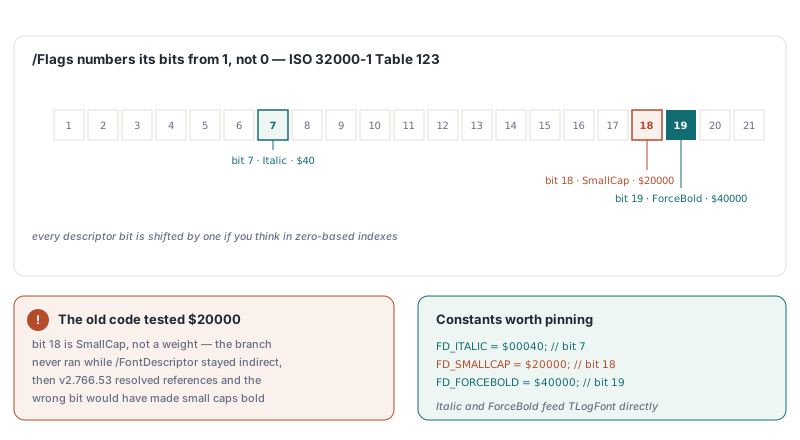
Kodėl CJK šriftai su UCS2 CMap gauna netinkamus pločius?
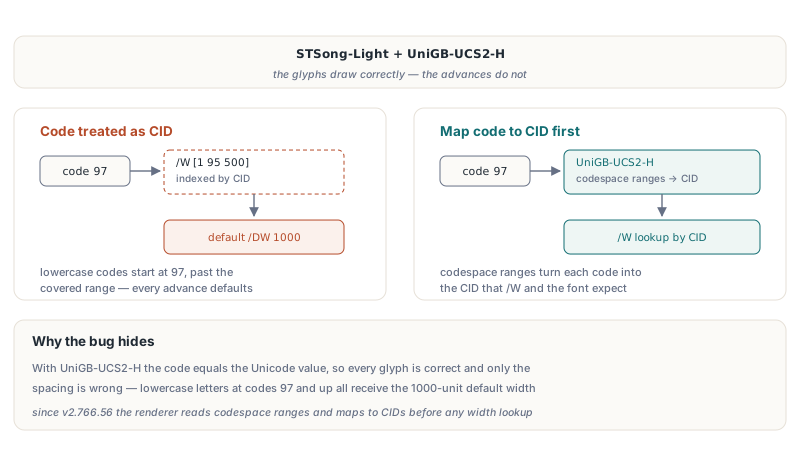
CJK tekstas su iš anksto apibrėžta UCS2 CMap piešia teisingus glifus, bet netinkamus tarpus, kai atvaizduotojas kodą traktuoja kaip CID, nes /W indeksuojamas CID, o ne simbolio kodu. Su STSong-Light ir UniGB-UCS2-H kodas atsitiktinai sutampa su Unicode reikšme, tad GDI nupiešia teisingus simbolius, o klaida slepiasi žingsniuose: mažosios raidės atkeliauja kaip kodai 97 ir aukščiau, pralenda pro /W įrašą, tokį kaip [1 95 500], ir visi gauna numatytąjį /DW plotį 1000. Nuo v2.766.56 HotPDF atvaizduotojas kodus skaito per CMap codespace diapazonus (ISO 32000-1 §9.7.6.2) ir prieš ieškodamas pločių juos susieja su CID. Naudojamos tik įtaisytosios UCS2 ir UTF16 lentelės bei įdėti CMap srautai; tapatumo aproksimacija kažkam, tokiam kaip GBK-EUC-H, tik atrodytų kaip palaikymas, kol duotų netinkamą išvestį, tad atvaizduotojas nesisvajoja
Kodėl kiniškame Windows kirtių simboliai virsta klaustukais?
Vienbaitai kodai niekada neturi pasiekti ANSI („A“) GDI funkcijų, nes GetGlyphOutlineA ir GetGlyphIndicesA baitus aiškina sistemos koduotėje, o TextOutA naudoja parinkto šrifto simbolių rinkinį. Kinų sistemoje Arial baitas $A9 (autorinių teisių ženklas Windows-1252) tapo GBK pirmuoju baitu ir atvaizdavosi kaip „?“ – į tuos spąstus tiesiai įžengė nepatarintas kontūrų kelias, pridėtas v2.766.83. v2.767.3 realizuoto šrifto paklausia jo simbolių rinkinio su GetTextCharset, per TranslateCharsetInfo tą rinkinį paverčia koduote, praleidžia baitą pro MultiByteToWideChar ir kviečia W funkcijas; simbolių šriftai vietoj to naudoja U+F000 plus kodą. Koduotės, nesutampančios su Windows-1252 – /Differences, StandardEncoding, MacRomanEncoding – į Unicode paverčiamos dar prieš tai, kai jas mato bet kuris sistemos šriftas
Kokie piešimo sistemos šriftais apribojimai?
Atvaizdavimas sistemos šriftais yra aproksimacija, ir HotPDF komponentas sąžiningai pasako, kur sustoja. Iki v2.768.18 įdiegimo patikra lygino tik vardą, kurį grąžina GetTextFace, o lokalizuotame Windows ta funkcija praneša šeimos vardą sistemos kalba, tad Microsoft YaHei kiniškame Windows arba Yu Mincho japoniškame Windows būdavo pripažįstamas dingusiu ir dedamas GDI pakaitalu; nuo v2.768.18 pavidalas, grįžtantis kitu vardu, taip pat ieškomas šrifto name lentelėje, ir tokie šriftai surandami. Metrinis atitikimas garantuotas tik Helvetica, Times ir Courier šeimoms; Symbol susieja su Symbol, o ZapfDingbats – su Wingdings, kas yra laikina priemonė, o ne atitikmuo. Išankstinė patikra aukščiau taip pat mato tik šriftus kiekvieno puslapio /Resources žodyne, o ne tuos, kurie nurodyti iš formos XObject viduje. Kai kodo vis tiek nepavyksta nupiešti, piešimo metu vykstantis neišspręstų glifų sekimas tai praneša – geresnis signalas nei miniatiūrų žiūrėjimas
Patvari pataisa slypi autorystės pusėje. Pats HotPDF rašo su FontEmbedding, pagal nutylėjimą nustatytu True, įdėdamas Arial net tada, kai kodas SetFont kviečia su Helvetica, o įdėtas tekstas eina pro įdėtų šriftų glifų atvaizduotoją vietoj visų aukščiau aprašytų spėlionių. Pigus ateinantiems failams skirtas apsaugos būdas – perspėti prieš atvaizdavimą, kai atvaizduotoji šeima nesėdi ekrano šriftų sąraše:
// VCL: Screen.Fonts išvardija įdiegtų šeimų vardus (Forms unitas)
function MissingSystemFamily(const BaseFont: AnsiString): Boolean;
begin
  Result := Screen.Fonts.IndexOf(HPDFMapBaseFontToSystem(BaseFont)) < 0;
end;
Apie pilną komponentą – įskaitant puslapių atvaizdavimą, teksto ištraukimą ir šriftų poaibių sudarymą rašymo pusėje – skaitykite HotPDF Delphi PDF komponento produkto puslapyje