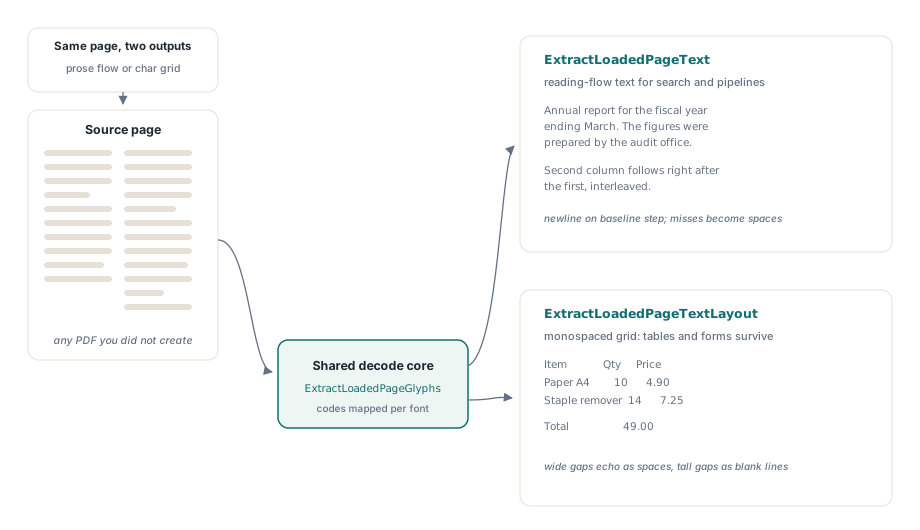
HotPDF Delphi Component ištraukia Unicode tekstą iš bet kurio PDF, kurį Delphi aplinkoje įkeliate, per du iškvietimus: ExtractLoadedPageText grąžina puslapio tekstą skaitymo eiga, o ExtractLoadedPageTextLayout (pridėtas v2.263.0) atkuria puslapio vaizdinį išdėstymą kaip paprastą tekstą, todėl stulpeliai, įtraukos ir lentelių lygiavimas išvestyje išlieka. Abu veikia su dokumentais, kurių HotPDF nekūrė, o būtent tai ir svarbu: sąskaita, kurią klientas atsiuntė paštu, ataskaita, kurią pateikė skenavimo biuras, sutartis, sukurta programos, kurios pavadinimo nebeatsimena niekas
Iki šio taško prireikė daugiau mechanikos, nei leidžia suprasti tie du parašai, nes PDF teksto nesaugo taip, kaip jį saugo tekstinis failas. Šis straipsnis pereina per abu ištraukimo režimus, o tada atkelia gaubtą virš trijų po jais esančių dalių — CMap skaitytuvo, turinio srauto interpretatoriaus ir šriftų iškodavimo atsargų grandinės — nes žinojimas, kaip veikia atvaizdis, skiria gūžtelėjimą pečiais dėl šiukšlinės išvesties nuo jos diagnozavimo
Kodėl teksto ištraukimas sunkesnis nei eilučių išskaitymas iš failo?
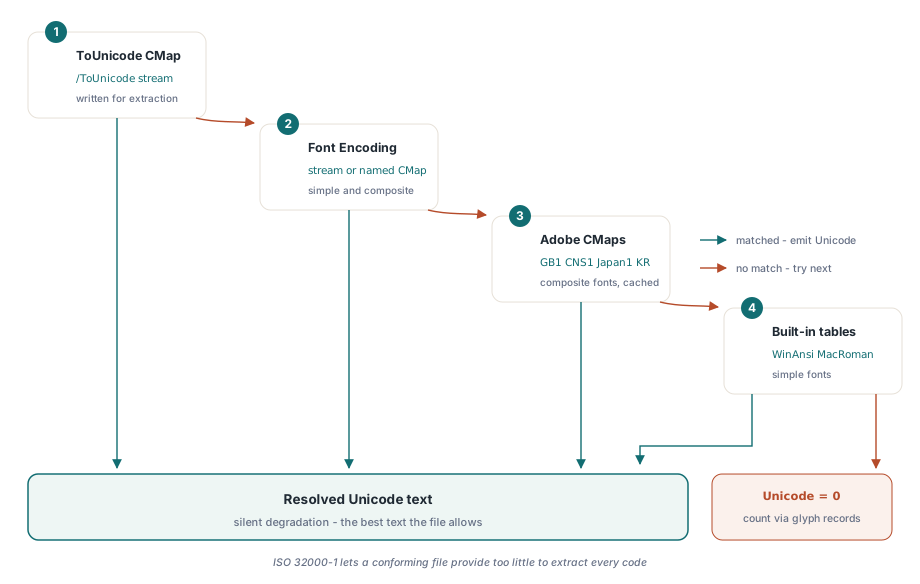
PDF turinio srautas įrašo simbolių kodus, o ne simbolius. Operatoriai Tj ir TJ (ISO 32000-1 §9.4.3) neša baitų eilutes, kurių prasmė visiškai priklauso nuo šrifto, parinkto ankstesniu Tf: baitas 0x41 gali būti raidė A pagal WinAnsi, savavališkas glifas poaibiniame šrifte arba dviejų baitų CID pusė sudėtiniame CJK šrifte. ISO 32000-1 §9.10 teksto ištraukimą apibrėžia būtent kaip šią iškodavimo problemą — kiekvieno kodo atvaizdavimą atgal į Unicode naudojant bet kokią šrifto žodyno pateiktą informaciją — ir standartas aiškiai sako, kad standartą atitinkantis failas neprivalo pateikti pakankamai informacijos tam padaryti
Būtent ta paskutinė sąlyga paaiškina kiekvieną kada nors matytą pranešimą „kodėl kopijuojant iš šio PDF gaunama nesąmonė“. Gamintojas, įterpiantis poaibinį šriftą be /ToUnicode lentelės, sukūrė failą, kuris atvaizduojamas nepriekaištingai, o ištraukiamas kaip niekai, nes kodo ir glifo atvaizdis egzistuoja, bet kodo ir Unicode atvaizdis niekada nebuvo pristatytas. Todėl bet koks sąžiningas ištraukimo API yra geriausių pastangų atsargų grandinė, o naudingas klausimas yra toks: kaip giliai ta grandinė siekia
Skaitymo eigos ištraukimas su ExtractLoadedPageText
Paieškos indeksavimui, raktažodžių gretinimui ar teksto padavimui analizės grandinei tinka būtent ExtractLoadedPageText. Parašas yra function ExtractLoadedPageText(PageIndex: Integer; out AText: UnicodeString): boolean — puslapių indeksai skaičiuojami nuo nulio, rezultatas atkeliauja kaip gimtoji Delphi UnicodeString, o funkcija grąžina False, kai puslapis neturi skaitomo turinio srauto, užuot metusi išimtį
var
  Pdf: THotPDF;
  PageCount, I: Integer;
  PageText, AllText: UnicodeString;
begin
  Pdf := THotPDF.Create(nil);
  try
    PageCount := Pdf.LoadFromFile('invoice.pdf');
    AllText := '';
    for I := 0 to PageCount - 1 do
      if Pdf.ExtractLoadedPageText(I, PageText) then
        AllText := AllText + PageText + #13#10;
    // AllText dabar laiko dokumento tekstą skaitymo eiga
  finally
    Pdf.Free;
  end;
end;
Eilučių lūžiai išvestyje kyla iš sąmoningai paprastos geometrinės taisyklės. Nuo HotPDF v2.766.79 naujos eilutės ženklas įterpiamas, kai glifo pradžia rašymo kryptimi persiriboja daugiau nei per pusę teksto aukščio – imama didesnė iš šio ir ankstesnio glifo kilimo–leidimo langelio aukščio puslapio vienetais. Iki to leidimo vertikalus poslinkis buvo lyginamas su puse šrifto dydžio, perduoto Tf, kuris dokumentuose, teksto dydį nustatančiuose per teksto matricą, dažnai būna 1, todėl pakeltas viršutinis indeksas pradėdavo naują eilutę, o pasuktas tekstas kiekvieną simbolį talpindavo atskiroje eilutėje. Žodžių tarpai nuo v2.766.76 laikosi analogiškos taisyklės: kur generatorius žodžius skiria perkeldamas teksto poziciją – TJ pataisa arba Td, – vietoj tarpo simbolio rodymo, tarpas pridedamas, kai tarpas palei bazinę liniją, liekant už ankstesnio glifo paties pločio, viršija 0,15 glifo langelio aukščio, ir niekada tarp dviejų kinų, japonų ar korėjiečių simbolių. Simboliai, kurių iškoduotuvas negali išspręsti, tampa tarpais, o ne dingsta, todėl žodžių ribos išlieka net tada, kai atskiri glifai ne. Ko šis režimas nebando daryti, tai skaitymo tvarkos grupavimo ar kelių stulpelių aptikimo: dviejų stulpelių puslapis išeina supintas turinio srauto tvarka, kuri paprastai, bet ne visada, sutampa su vaizdine tvarka
Kada verčiau rinktis išdėstymą išlaikantį ištraukimą?
ExtractLoadedPageTextLayout yra tinkamas iškvietimas visada, kai padėtis neša prasmę: lentelėse, formose, kodo sąrašuose, visur, ką ketinate lyginti, filtruoti ar analizuoti pagal stulpelius. Užuot suplojęs glifus į srautą, jis sugrupuoja juos į bazines linijas, kiekvieną liniją surikiuoja pagal X ir atkuria horizontalius bei vertikalius tarpus lygiapločio simbolių tinklelyje, kurio dydis parenkamas pagal glifų postūmio medianą ir šrifto dydį. Platūs tarpai tarp atkarpų toje pačioje bazinėje linijoje virsta tarpų sekomis; dideli tarpai tarp bazinių linijų virsta tuščiomis eilutėmis. Rezultatas skaitosi taip, kaip puslapis atrodo
var
  Grid: UnicodeString;
begin
  if Pdf.ExtractLoadedPageTextLayout(0, Grid) then
    TFile.WriteAllText('page1.txt', Grid, TEncoding.UTF8);
  // Stulpeliai, įtraukos ir lentelių lygiavimas išlieka kaip
  // tarpai ir tuščios eilutės simbolių tinklelyje
end;
Abu režimai dalijasi kiekvienu iškodavimo mechanikos baitu ir skiriasi tik tuo, kaip išdėsto iškoduotus glifus, todėl pasirinkimas nekainuoja jokio tikslumo. Rinkitės ExtractLoadedPageText, kai svarbūs tik žodžiai, ir ExtractLoadedPageTextLayout, kai svarbus išdėstymas. Kelių stulpelių skaitymo tvarkos aptikimas abiem lieka už apimties ribų — dviejų stulpelių puslapio tinklelinis pavaizdavimas parodo abu stulpelius greta, ištikimai, ir lyginimui tai kaip tik teisinga, o prozos perliejimui ne
Kaip HotPDF iškoduoja simbolių kodus į Unicode?
HotPDF Delphi Component kiekvieną simbolio kodą sprendžia per pagal prioritetą surikiuotą atsargų grandinę: pirma šrifto įterptas /ToUnicode CMap, tada /Encoding įrašas (srautas arba įvardytas CMap), tada — sudėtiniams šriftams — Adobe standartiniai CMap failai simbolių kolekcijoms, tokioms kaip Adobe-GB1, Adobe-CNS1, Adobe-Japan1 ir Adobe-KR, ir galiausiai įtaisytosios WinAnsi bei MacRoman lentelės paprastiems šriftams. Strategija, negalinti pateikti atsakymo, tyliai nusileidžia iki kitos, o ne meta išimtį, o kodas, išsėmęs visą grandinę, išsprendžiamas į 0, kad iškvietėjas galėtų suskaičiuoti nesėkmes, o ne spėlioti
/ToUnicode CMap (ISO 32000-1 §9.10.3) stovi pirmas, nes tai vienintelis atvaizdis, kurį gamintojas parašė būtent ištraukimui. Adobe standartinių CMap kelias svarbus CJK dokumentams, naudojantiems iš anksto apibrėžtus CMap, tokius kaip UniGB-UTF16-H, užuot ką nors įterpus: HotPDF kolekcijų failus pristato savo resources\CMap kataloge, vykdymo metu suranda juos vykdomojo failo atžvilgiu ir kiekvieną išanalizuotą atvaizdį talpykloje laiko po vieną procesui — verta žinoti, nes didžiausias iš jų, Adobe-GB1 atvaizdis, yra maždaug 2 MB pirminio teksto, kurio nenorite analizuoti iš naujo kiekvienam puslapiui. Jei katalogo nėra, iškoduotuvas tiesiog praleidžia disku paremtus CMap ir dirba su įterptomis lentelėmis bei įtaisytosiomis koduotėmis. Tai skaitymo pusės veidrodis formos sudarymo problemai, aptartai tekste apie sudėtingų raštų teksto formavimą su HotPDF, kur tas pats kodo ir glifo skirtumas iškyla rašymo metu
Dvi CMap sintaksės spąstos, kurias verta žinoti
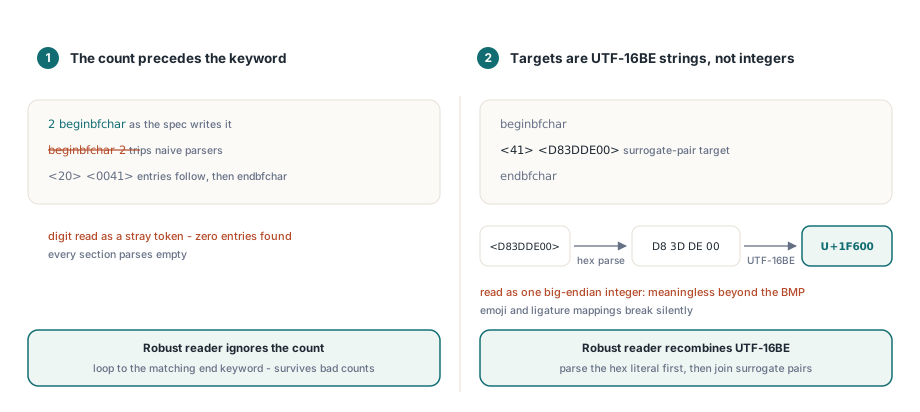
CMap failai atrodo trivialiai analizuojami, bet tokie nėra, ir dvi smulkmenos paaiškina daugumą pirmųjų bandymų nesėkmių. Pirmoji yra ta, kad įrašų skaičius eina prieš sekcijos raktažodį: sekcija skamba 2 beginbfchar, o ne beginbfchar 2. Analizatorius, laukiantis skaičiaus po raktažodžio, tą skaičių suvartoja kaip pašalinę leksemą, o paskui kiekvienoje sekcijoje randa nulį įrašų. Patvarus būdas — tas, prie kurio prisėdo HotPDF skaitytuvas — yra skaičių visai ignoruoti ir suktis cikle iki atitinkamo endbfchar arba endbfrange raktažodžio, o tai dar ir toleruoja tikrus failus, kurių skaičiai tiesiog klaidingi
Antrieji spąstai yra tai, kad bfchar ir bfrange tikslai yra UTF-16BE eilutės, o ne sveikieji skaičiai. Paskirtis <D83DDE00> reiškia U+1F600 — pakaitinę porą, kurią būtina vėl sujungti į vieną kodo tašką — o tų keturių baitų skaitymas kaip didžiojo galo sveikojo skaičiaus duoda beprasmę reikšmę kiekvienam kodo taškui už pagrindinės daugiakalbės plokštumos ribų. Jaustukai PDF failuose jau nebe egzotika, todėl iškoduotuvas, praleidžiantis pakaitinių porų sujungimą, žlunga ties failais, kuriuos jūsų naudotojai iš tikrųjų turi. HotPDF pirma išanalizuoja šešioliktainį literalą į neapdorotus baitus, o tada sujungia UTF-16BE kodo vienetus, ir tai kartu apima kelių simbolių tikslus, kuriuos pagimdo ligatūrų atvaizdžiai
Nusileidimas iki glifų lygio su ExtractLoadedPageGlyphs
Abu teksto iškvietimai pastatyti ant ExtractLoadedPageGlyphs, o po juo esantis THPDFGlyphArray prieinamas ir jūsų kodui. Kiekvienas THPDFGlyphRecord neša išspręstą Unicode kodo tašką kartu su neapdorotu simbolio kodu, kodo baitų plotį (1, 2 arba 4, nulemtą CMap codespacerange sekcijos), aktyvaus šrifto ištekliaus raktą ir dydį, naudotojo erdvės X ir Y pradžią bei horizontalų postūmį; nuo v2.766.76 jis taip pat neša GlyphEndX ir GlyphEndY – glifo paties pločio galą puslapio erdvėje be simbolių ir žodžių tarpo, nuo ko matuoja aukščiau aprašyta žodžių tarpo taisyklė. To pakanka žodžių ribų aptikimui, pozicionuotam paryškinimui ar savam išdėstymo algoritmui sukurti patiems neliečiant turinio srauto
var
  Glyphs: THPDFGlyphArray;
  I, Unresolved: Integer;
begin
  if Pdf.ExtractLoadedPageGlyphs(0, Glyphs) then
  begin
    Unresolved := 0;
    for I := 0 to High(Glyphs) do
      if Glyphs[I].Unicode = 0 then
        Inc(Unresolved);
    if Unresolved > 0 then
      ShowMessageFmt('%d of %d glyphs have no Unicode mapping',
        [Unresolved, Length(Glyphs)]);
  end;
end;
Įrašų su Unicode = 0 skaičiavimas, kaip aukščiau, yra sąžiningas būdas išmatuoti konkretaus dokumento ištraukimo kokybę prieš pasitikint tekstu toliau grandinėje. Glifų įrašai taip pat pririša kiekvieną simbolį prie pirminio operando turinio sraute, ir būtent tai ant to paties pamato leidžia HotPDF įkelto dokumento teksto paiešką ir keitimą
Kurie PDF savo teksto neatiduos?
Kai kurie failai nugali bet kokį ištraukėją, ir geriau juos aptikti, nei paleisti jų išvestį į apyvartą. Skenuoti dokumentai yra paprasčiausias atvejis: puslapis, kuris yra vienas didelis paveikslėlis, iš viso neturi teksto operatorių, todėl ištraukimas teisingai grąžina tuščią eilutę — sprendimas yra OCR, o puslapio paveikslėlių ištraukimas iš įkelto PDF yra pirmasis tos grandinės žingsnis. Poaibiniai šriftai be /ToUnicode lentelės yra sunkesnis atvejis: jei /Encoding kelias ir standartiniai CMap taip pat lieka tušti, tie glifai išsprendžiami į 0 ir teksto iškvietimuose išnyra kaip tarpai. Šifruoti dokumentai ištraukiami įprastai, jei juos įkeliate su slaptažodžiu per LoadFromFile perkrovą, tad srautai iššifruojami dar prieš interpretatoriui juos pamatant
Vieną siauresnę ribą verta pasakyti tiesiai: iškodavimo grandinė CMap ir turinio srautus skaito per HotPDF Flate kelią, todėl šriftas, kurio ToUnicode srautas naudoja neįprastą filtrą, nusileidžia iki kitos strategijos, o ne pražudo puslapį. Praktikoje FlateDecode padengia beveik viską, kas pagaminta per pastaruosius du dešimtmečius, o nusileidimas tylus pagal sumanymą — gaunate geriausią tekstą, kokį failas leidžia, o ne išimtį. Ta pati skaitymo pusės objektų mechanika, kuri čia sprendžia šriftų žodynus, taip pat maitina metaduomenų redagavimą įkeltuose dokumentuose, todėl dokumentų priėmimo grandinė gali ištraukti, apžiūrėti ir anotuoti vienu praėjimu
Teksto ištraukimas, išdėstymą išlaikantis pavaizdavimas, prieiga glifų lygiu ir ant jų pastatytos paieškos bei keitimo galimybės visos yra standartinio HotPDF Delphi komponento, skirto Delphi ir C++Builder, dalis — jokių išorinių DLL, jokių operacinės sistemos teksto tarnybų, tik Object Pascal, per kurį galite pereiti derintuvu, kai į jūsų eilę patenka keistas failas