새로 만든 PDF에서 "two-x"를 검색했는데 페이지에는 그 다섯 문자가 선명한데도 검색 결과가 0건으로 돌아올 수 있습니다. 추출된 문자열을 코드포인트로 덤프해 보면 이유가 바로 드러납니다. 하이픈은 U+00AD SOFT HYPHEN으로, 뒤따르는 공백은 U+00A0 NO-BREAK SPACE로 돌아온 것입니다. 둘 다 화면에서는 동일하게 보입니다. 차이는 ToUnicode CMap, 즉 리더가 문자 코드를 다시 Unicode로 되돌릴 때 참조하는 표에 있고, 그 근원은 두 코드포인트가 하나의 폰트 글리프를 공유하는 것입니다
평범한 문자열 도구는 이 불일치를 더 악화시킵니다. CSV 내보내기는 줄을 다르게 쪼개고, diff 도구는 모든 뷰어에서 똑같아 보이는 두 줄을 지적하고, 맞춤법 검사기는 소프트 하이픈이 섞인 "two-x"를 모르는 단어로 취급합니다. Unicode 정규화는 절반만 구해 줍니다. NFKC는 U+00A0을 평범한 공백으로 접습니다. NBSP가 호환 분해를 지니고 있기 때문입니다. 하지만 U+00AD는 분해가 전혀 없어서, 소프트 하이픈은 모든 정규화 형식을 그대로 살아남습니다
추출된 공백은 왜 U+00A0으로 돌아올까요?
추출된 공백이 U+00A0으로 변하는 이유는 ToUnicode CMap이 글리프를 키로 하고, 하나의 글리프에 두 코드포인트가 닿을 수 있기 때문입니다. Arial에서 글리프 3은 U+0020과 U+00A0을 둘 다 맡고, 하이픈 글리프는 U+002D와 U+00AD를 둘 다 맡습니다. 글리프 쪽에서 만든 CMap은 CID 0003에 대해 무언가를 말해야 하는데, FPDFText_LoadFont의 PDFium 생성기는 결국 두 가지를 말합니다. 그 CID를 U+0020으로 매핑하는 bfchar 항목 하나와, 같은 CID를 U+00A0으로 매핑하는 배열 형식 bfrange 하나입니다
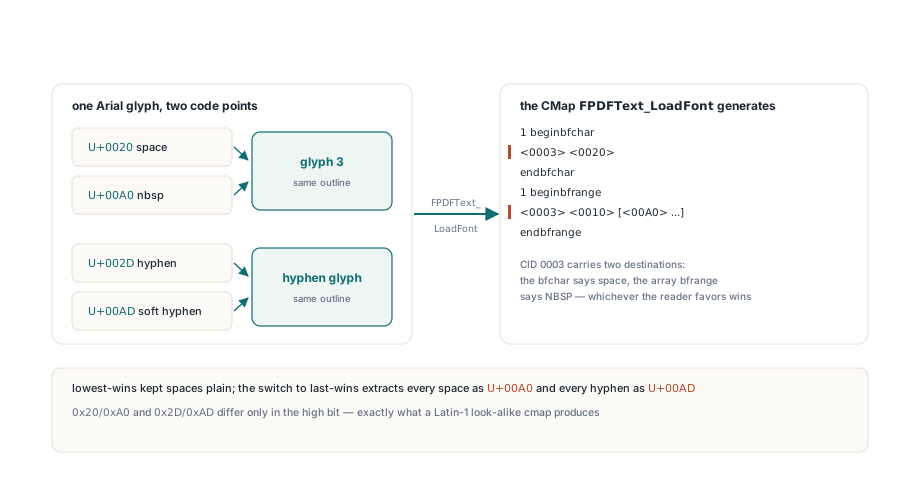
1 beginbfchar
<0003> <0020>
endbfchar
1 beginbfrange
<0003> <0010> [<00A0> ...]
endbfrange
ISO 32000-1 §9.10.3은 bfchar와 bfrange가 코드를 Unicode로 매핑하는 방식을 기술하지만, 둘이 같은 CID를 주장할 때 어느 항목이 이기는지는 말하지 않습니다. 리더들은 각자 우선순위 규칙을 택합니다. 가장 낮은 또는 첫 매핑을 유지하는 리더는 평범한 공백을 추출하고, PDFium 리더는 마지막 매핑을 유지하므로, 배열 범위가 bfchar 블록 뒤에 오는 이상 글리프 키 CMap을 통해 쓰인 모든 공백은 NBSP로, 모든 하이픈은 소프트 하이픈으로 추출됩니다. 따라서 같은 텍스트가 같은 파일에서 두 뷰어가 서로 다르게 추출할 수 있습니다
쌍에는 패턴이 있습니다. 0x20/0xA0과 0x2D/0xAD는 최상위 비트만 다른데, 폰트의 cmap이 Latin-1 닮은꼴을 이미 ASCII 문자가 쓰는 아웃라인으로 보낼 때 정확히 그런 모습이 나옵니다. 그리스 대문자 Omega(U+03A9)와 Ohm 기호(U+2126)도 Arial에서 글리프를 공유합니다. 멀쩡히 지나가던 추출 코드가 보이지 않는 문자에서 실패한다면, 디버거의 문자열 뷰를 믿지 말고 코드포인트를 출력하세요. 페이지에서 텍스트를 읽어 내는 기본은 Delphi에서 PDFium으로 PDF 문서 텍스트 추출하기에 있습니다
PDFium Component는 시스템 폰트를 코드포인트로 어떻게 키잉하는가
PDFium Component는 Unicode cmap을 지닌 시스템 폰트에 대해서는 엔진에게 그 CMap 생성을 부탁하지 않습니다. TPdf.AddText가 폰트를 필요로 하면 컴포넌트는 폰트 자체의 sfnt cmap 테이블을 읽는데, format 12 서브테이블을 선호하고 format 4로 폴백합니다. 코드포인트는 정렬되고 중복 제거된 채 돌아오고, k번째 코드포인트에 CID k+1이 배정되며 CID 0은 .notdef로 남습니다. 명시적인 CIDToGIDMap이 각 CID를 자기 글리프로 보냅니다. 그리하여 U+0020과 U+00A0은 같은 아웃라인을 그리는 서로 다른 두 CID를 얻고, 컴포넌트가 쓰는 ToUnicode CMap은 각 CID를 정확히 하나의 코드포인트에 매핑합니다
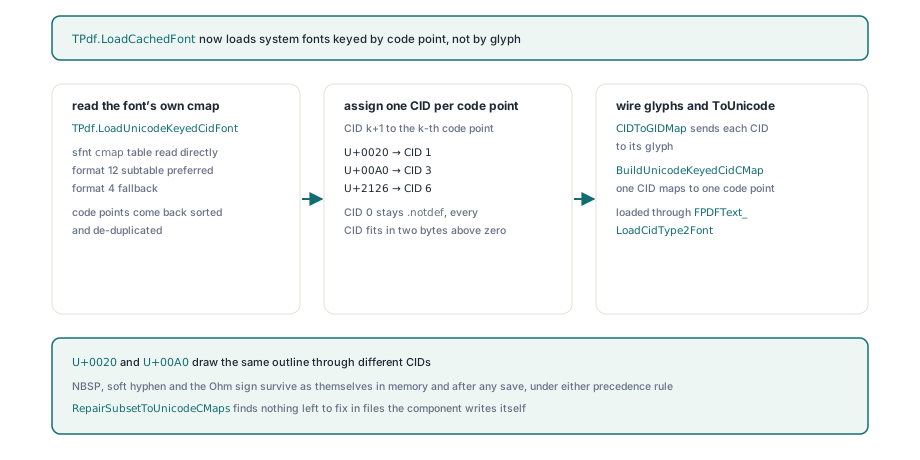
폰트는 FPDFText_LoadCidType2Font로 로드되는데, 명시적 CID-to-GID 맵을 곁들인 CID Type 2 폰트 임베딩의 글리프 수준 쓰기 뒤에 있는 같은 진입점입니다. 이후 FPDFText_SetText가 문자열을 쓸 때 역방향 조회는 문자마다 단 하나의 CID에 떨어집니다. 규칙이 고를 두 번째 매핑이 존재하지 않으므로 여기엔 리더의 우선순위 규칙이 개입할 여지가 없습니다. 저장된 파일 역시 컴포넌트 자체의 ToUnicode 스트림을 지니므로, 다시 로드한 뒤의 추출은 살아 있는 문서가 쓰던 것과 같은 일대일 표를 봅니다
비용은 더 커진 CIDToGIDMap입니다. 폰트가 커버하는 코드포인트마다 2바이트입니다. 폰트가 약 3,000개의 코드포인트를 매핑한다고 치면 맵은 대략 6KB에 이르고, 폰트마다 엔진에 넘겨집니다. 그래도 이 거래는 언제나 할 가치가 있습니다. KB 몇 개가 PDFium에서도, 첫 매핑을 유지하는 뷰어에서도, 고객이 내년에 돌릴 어떤 인덱서에서도 똑같이 읽히는 추출을 사 줍니다
아래의 왕복 테스트는 모든 골칫거리 쌍을 담은 문자열을 쓰고, 저장하지 않은 문서에서 추출한 뒤, 저장하고, 다시 로드하고, 또 추출합니다. 두 문자열 모두 입력과 정확히 일치해야 합니다. CodePoints 헬퍼는 불일치를 읽을 수 있게 만들어 줄 뿐입니다:
uses
  SysUtils, PDFium;

const
  // Space/U+00A0과 hyphen/U+00AD는 하나의 Arial 글리프를 공유하며
  // 그리스 Omega(U+03A9)와 Ohm 기호(U+2126)도 그렇다
  Sample: WString = 'two-x'#$00A0'y'#$00AD'z '#$03A9#$2126;

function CodePoints(const S: WString): string;
var
  I: Integer;
begin
  Result := '';
  for I := 1 to Length(S) do
    Result := Result + 'U+' + IntToHex(Ord(S[I]), 4) + ' ';
end;

var
  Pdf: TPdf;
  Live, Reloaded: WString;
begin
  Pdf := TPdf.Create(nil);
  try
    Pdf.CreateDocument;
    Pdf.AddPage(1, 595, 842);
    Pdf.AddText(Sample, 'Arial', 12, 72, 770);
    Live := Pdf.Text;                  // 살아 있는, 저장되지 않은 문서
    Pdf.SaveAs('codepoints.pdf');
  finally
    Pdf.Free;
  end;

  Pdf := TPdf.Create(nil);
  try
    Pdf.FileName := 'codepoints.pdf';
    Pdf.Active := True;
    Pdf.PageNumber := 1;
    Reloaded := Pdf.Text;              // 저장 후 다시 로드한 뒤
  finally
    Pdf.Free;
  end;

  if (Live <> Sample) or (Reloaded <> Sample) then
    Writeln('Mismatch: ', CodePoints(Live), '/ ', CodePoints(Reloaded));
end.
샘플 문자열에서 NBSP와 소프트 하이픈은 문서에 거의 안 들어온다 해도 빼지 마세요. ASCII만 쓰는 테스트는 글리프 키 CMap 상대로도 통과해 버립니다. 문자열 어디에도 리더가 두 매핑 사이에서 고르도록 요구하는 것이 없기 때문입니다
bfrange 항목 하나가 왜 블록 전체를 지워버릴까요?
CID 구간이 xxFF 경계를 가로지르는 bfrange 하나가 PDFium으로 하여금 그것이 앉아 있는 블록 전체를 버리게 만듭니다. ISO 32000-1 §9.10.3은 목적지의 마지막 바이트만 범위 안에서 변할 수 있게 하는데, CID 쪽에는 PDFium 파서에 짝이 되는 함정이 있습니다. 상위 CID를 (low and $FFFFFF00) or (high and $FF)로 유도하는 것입니다. CID 00FE부터 0101까지의 구간은 따라서 00FE부터 0001로, 즉 low가 high보다 큰 것으로 읽히고 블록 전체가 무효 표시됩니다. SetText는 성공하고 페이지는 올바르게 렌더되는데, 추출은 그 블록의 모든 문자에 대해 U+0000을 돌려줍니다
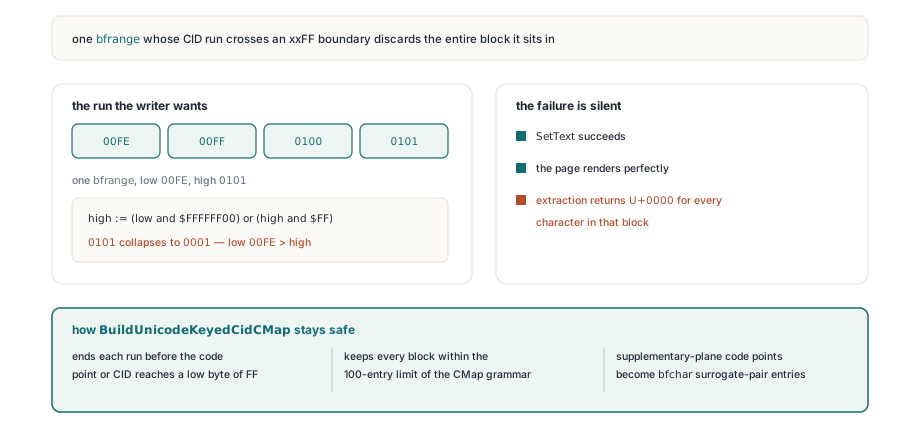
코드포인트 키 폰트가 바로 이 함정이 물리는 자리입니다. CID는 촘촘하고 연속적이라, 작성기가 연달아 오는 항목을 그냥 병합하기만 하면 코드포인트가 255개를 넘는 폰트는 00FF, 01FF 따위를 가로지르는 CID 구간을 만들어 냅니다. PDFium Component가 쓰는 CMap은 코드포인트든 CID든 낮은 바이트가 FF에 닿기 전에 구간을 끝내고, 항목들을 최대 100개짜리 블록으로 나눕니다. CMap 문법이 각 beginbfrange와 beginbfchar 섹션에 거는 한도입니다
U+FFFF 위의 코드포인트는 개별 bfchar 항목으로 쓰이며, 목적지는 UTF-16 서러게이트 쌍입니다. 범위 안에서 서러게이트 쌍을 증가시키는 것은 정의된 의미가 없기 때문입니다. 그 이야기의 서러게이트 쪽은 Delphi의 emoji, CJK, 서러게이트 쌍 처리에 있습니다. bfchar 전용 CMap은 크기가 몇 배로 뛰는 대가로 경계 문제를 완전히 우회할 것입니다. 그래서 범위가 주력 형태로 남고 분할 규칙이 그 무게를 짊어집니다
다른 도구가 만든 파일의 ToUnicode 충돌 수리하기
FPdfCompress 유닛의 RepairSubsetToUnicodeCMaps는 컴포넌트가 쓰지 않은 파일의 글리프 키 충돌을 고칩니다. TPdf.SaveAs는 비 증분 전체 저장마다 이를 실행하고, 어떤 스트림에든 직접 호출할 수도 있습니다. 두 목적지를 지닌 CID마다 bfchar 항목이 이깁니다. CID에 bfchar가 없고 쌍이 최상위 비트만 다르다면 더 작은 base-Latin 코드포인트로 정해집니다. 그 외의 충돌은 첫 매핑을 유지합니다
수리는 충돌하는 16진수 값을 동일 길이 교체로 제자리에서 고칩니다. 블록 레이아웃과 CID 커버리지, 스트림의 나머지 모든 바이트는 원래 그대로라서, CMap은 PDFium 리더가 이미 받아들인 형태를 유지합니다. 깔끔하게 다시 만든 CMap이 헥스 덤프에서는 더 정돈되어 보일 것입니다. 하지만 이미 엄격한 리더가 받아들인 스트림의 구조를 바꾸는 일이고, 어긋난 목적지 값이 몇 개뿐인데 그럴 이득은 없습니다
uses
  Classes, FPdfCompress;

var
  Source, Dest: TFileStream;
begin
  Source := TFileStream.Create('from-other-tool.pdf',
    fmOpenRead or fmShareDenyWrite);
  try
    Dest := TFileStream.Create('repaired.pdf', fmCreate);
    try
      // 동일 길이 편집만 수행; 복구 가능한 충돌이 없는 파일과
      // 크로스 레퍼런스 스트림 또는 객체 스트림 파일은 그대로 복사됨
      RepairSubsetToUnicodeCMaps(Source, Dest);
    finally
      Dest.Free;
    end;
  finally
    Source.Free;
  end;
end.
이 루틴은 클래식 크로스 레퍼런스 테이블을 다시 만들므로, 크로스 레퍼런스 스트림, 하이브리드 참조, 오브젝트 스트림을 쓰는 문서는 바이트 단위로 그대로 통과합니다. 증분 저장(saIncremental)은 설계상 수리를 건너뜁니다. 증분 리비전은 append-only를 유지해야 하기 때문입니다. 컴포넌트가 스스로 쓰는 텍스트라면 어느 쪽도 문제가 되지 않습니다. 코드포인트 키 폰트는 수리가 찾을 충돌을 애초에 만들어 내지 않습니다
코드포인트 키 경로가 적용되는 범위
코드포인트 키 경로는 Unicode cmap 서브테이블을 드러내는 모든 폰트를 커버하고, 나머지는 PDFium의 글리프 키 로딩이 처리합니다. 의지하기 전에 알아 둘 세부 사항들:
- (3,0) cmap만 지닌 Symbol 폰트와 CID 경로가 로드할 수 없는 폰트는
FPDFText_LoadFont를 거치는데, 두 코드포인트가 공유하는 글리프는 거기서 리더의 우선순위 규칙에 놓입니다 - format 4 서브테이블뿐이면 맵은 기본 다국어 평면(BMP)을 커버하고, 플랫폼 (3,10)이나 Unicode 플랫폼의 format 12 서브테이블은 보조 평면 코드포인트를 더해 줍니다
- 글리프 0과 서러게이트 코드포인트는 제외되며, 항목 수는 65535로 갑혀서 모든 CID가 0 위의 두 바이트에 들어맞습니다
- TrueType Collection은 각별한 주의가 필요합니다. GDI
GetFontData는 .ttc 전체를 돌려주고FPDFText_LoadCidType2Font에는 face index 파라미터가 없어서, 컬렉션을 그대로 넘기면 요청이 NSimSun이었는데 simsun.ttc의 face 0인 SimSun이 임베드됩니다. 컴포넌트는 패밀리 이름을 폰트의 name 테이블(nameID 1과 16)과 대조하고 요청된 face를 독립 sfnt로 넘깁니다. 파싱할 수 없는 컬렉션은 통째로 통과하며 face 0을 씁니다 - 요청한 이름의 시스템 폰트를 읽을 수 없으면
AddText는 폰트 이름을FPDFPageObj_NewTextObj에 넘겨 PDFium의 표준 폰트 가운데에서 찾습니다
인덱스에서는 보이지 않는 문자를 접고, 텍스트에는 그대로 두기
추출이 진짜 코드포인트를 돌려주면 다른 질문이 생깁니다. 저자가 일부러 입력한 NBSP나 소프트 하이픈을 검색 인덱스는 어떻게 다뤄야 할까요? 인덱싱 계층에서 접고 TPdf.Text는 그대로 두세요. 추출된 문자열은 문서가 말하는 것의 기록이고, 인덱스는 매칭을 위해 만든 유실 있는 뷰이며, 접는 규칙은 인덱스의 소관입니다
아래의 헬퍼는 여러분 고유의 코드에 추가하는 함수입니다. NBSP는 공백으로 매핑하고 소프트 하이픈은 버립니다. Unicode Standard가 말하길 소프트 하이픈은 줄이 바뀔 수 있는 자리를 표시할 뿐입니다. U+2126은 일부러 건드리지 않습니다. NFC 정규화는 Ohm 기호를 Omega로 바꾸는데, U+2126이 U+03A9로의 정준 단일 분해를 지니기 때문이고, 데이터시트 검색이 둘을 매칭해야 하는지는 추출이 아니라 제품의 결정입니다:
uses
  SysUtils, Classes, PDFium;

// 검색 인덱스용 자체 헬퍼입니다; PDFium Component 일부가 아님
function FoldForIndex(const S: string): string;
begin
  Result := StringReplace(S, #$00A0, ' ', [rfReplaceAll]);
  Result := StringReplace(Result, #$00AD, '', [rfReplaceAll]);
end;

procedure IndexDocument(const FileName: string; Lines: TStrings);
var
  Pdf: TPdf;
  P: Integer;
begin
  Pdf := TPdf.Create(nil);
  try
    Pdf.FileName := FileName;
    Pdf.Active := True;
    for P := 1 to Pdf.PageCount do
    begin
      Pdf.PageNumber := P;
      Lines.Add(FoldForIndex(Pdf.Text));   // 원본 텍스트는 Pdf.Text에 그대로
    end;
  finally
    Pdf.Free;
  end;
end;
첫 예제의 codepoints.pdf 파일에 IndexDocument를 돌리면 인덱스된 줄은 "two-x yz ΩΩ", 즉 열한 문자이며 마지막이 Ohm 기호여야 합니다. 한편 Pdf.Text는 NBSP와 소프트 하이픈을 포함해 원래 열두 문자를 여전히 그대로 돌려줍니다
코드포인트 키 폰트, CMap 수리, 텍스트 추출은 Delphi와 C++Builder, Lazarus에서 같은 페이지 모델 위에 놓여 있으며, 폰트와 텍스트 API는 Delphi용 PDFium Component 제품 페이지에 전체로 정리되어 있습니다