PDFium Component는 FPdfDocumentFontSubset 유닛의 SubsetPdfDocumentFonts로 기존 PDF에 이미 임베드된 폰트를 서브셋합니다. 이 함수는 폰트 리소스 자체가 문서가 참조할 수 있는 모든 글리프를 증명할 때만 임베드된 TrueType /FontFile2 프로그램을 더 작은 것으로 교체하며, 글리프 도메인을 증명할 수 없는 폰트는 정확히 그대로 둡니다
이걸 원하는 이유는 보통 여러분이 만들지 않은 보관함입니다. 오래된 생성기의 송장, 명세서, 보고서는 흔히 모든 파일에 완전한 Arial이나 풀 CJK 서체를 실으며, 두 페이지 문서당 수백 킬로바이트의 폰트는 수백만 문서를 넘어서면 빠르게 쌓입니다. 소스에서 다시 렌더링하는 것은 드문 선택입니다. 가진 것은 PDF이고, 유일하게 안전한 질문은 단 한 페이지도 글자를 잃지 않으면서 각 임베드된 폰트의 얼마나 뗄 수 있느냐입니다
기존 PDF 서브셋은 왜 글리프를 잃을 위험이 있을까
기존 PDF 서브셋이 글리프를 잃을 위험이 있는 이유는 후처리기가 원래 라이터가 어떤 글리프를 썼는지 모르기 때문입니다. 폰트를 임베드한 생산자는 자기 텍스트를 알았습니다. 그 뒤에 도는 도구는 그 지식을 재구성해야 하고, 놓친 글리프는 아무도 안 보는 페이지에서 빈 상자나 .notdef 모양이 됩니다. 고객이 눈치챌 때까지는요
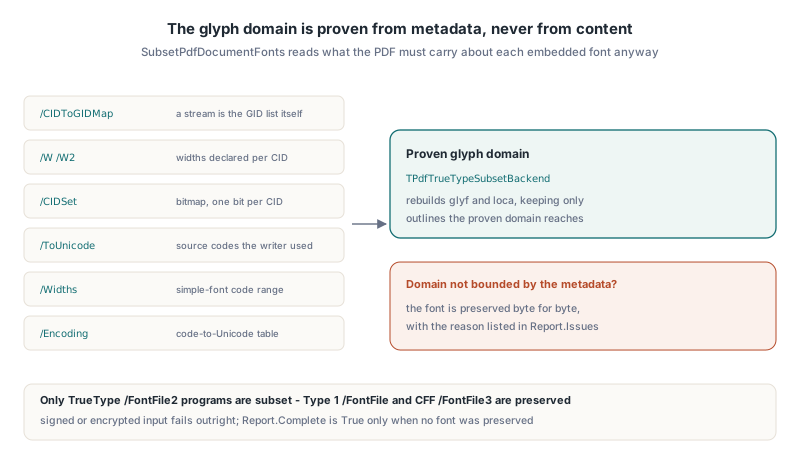
뻔한 접근은 모든 콘텐츠 스트림과 모든 Form XObject, 모든 어노테이션 appearance, 모든 필드 기본 appearance를 파싱해 각 폰트와 함께 표시된 코드를 수집하고 그 글리프들을 유지하는 것입니다. 페이지와 폼에 걸쳐 공유되는 폰트 리소스, 뷰어가 /DA에서 appearance를 재생성하는 폼 필드, 스캐너가 모델링하지 않는 연산자 수열을 가진 콘텐츠 스트림을 만날 때까지는 동작합니다. SubsetPdfDocumentFonts는 의도적으로 콘텐츠 스트림을 스캔하지 않습니다. PDF가 어차피 각 폰트에 대해 실어야 하는 메타데이터에서 글리프 도메인을 유도합니다. /CIDToGIDMap, /W와 /W2 폭 배열, /CIDSet 비트맵, /ToUnicode CMap, 단순 폰트 /Widths 배열, /Encoding입니다. 그 메타데이터가 도메인을 묶지 못하면 폰트는 그대로 둡니다
원본 글리프 ID를 유지해 콘텐츠 스트림을 그대로 두기
SubsetPdfDocumentFonts 뒤의 서브셋 백엔드인 TPdfTrueTypeSubsetBackend는 모든 원본 글리프 ID 슬롯을 유지하므로, 콘텐츠 스트림이나 CID, /CIDToGIDMap을 다시 써야 하는 일은 결코 없습니다. glyf와 loca 테이블을 재건하고, 쓰이지 않는 모든 글리프에 길이 0의 loca 범위를 주며, maxp.numGlyphs는 그대로 둡니다. 글리프 4711은 서브셋 후에도 글리프 4711입니다. 문서가 도달할 수 있을 때만 외곽선이 있을 뿐입니다
그 선택이 완성된 문서 서브셋의 가장 위험한 부분을 제거합니다. 글리프를 다시 번호 매기는 것은 그 폰트를 쓰는 모든 콘텐츠 스트림의 모든 문자열과 매핑 스트림, 글리프 ID를 캐시하는 모든 것을 다시 쓰는 것을 의미합니다. 유지된 ID는 약간의 크기를 치르는데, loca가 원본 글리프마다 항목 하나를 유지하기 때문입니다. 그러나 TrueType 프로그램의 대부분은 외곽선 데이터이고 떨어져 나가는 것이 바로 그것입니다. 합성 글리프는 구성 요소를 따라가므로, 액센트 달린 문자는 밑글자와 그것이 빚어진 액센트를 유지합니다. 순환하거나 지나치게 깊은 합성 참조는 깨진 클로저를 만드는 대신 폰트를 실패시킵니다
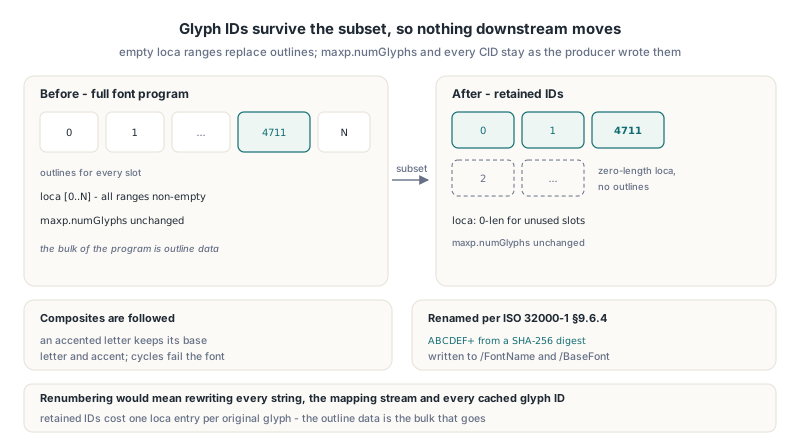
이름이 바뀐 폰트는 ISO 32000-1 §9.6.4도 따릅니다. 이것은 서브셋 폰트 이름이 대문자 여섯 개와 더하기 부호로 시작할 것을 요구합니다. 컴포넌트는 새 폰트 프로그램의 SHA-256 다이제스트에서 여섯 글자를 유도하고, 기존 ABCDEF+ 접두어를 먼저 떼고, 같은 문서의 폰트들 사이 충돌을 해석하며, 기술자 /FontName과 폰트 딕셔너리 /BaseFont, CIDFont의 Type0 부모를 포함해 새 이름을 씁니다
uses
  System.SysUtils, System.Classes, FPdfDocumentFontSubset;

procedure SubsetEmbeddedFonts(const SourceName, TargetName: string);
var
  Source, Target: TFileStream;
  Options: TPdfDocumentFontSubsetOptions;
  Report: TPdfDocumentFontSubsetReport;
  Output: TBytes;
begin
  Options := TPdfDocumentFontSubsetOptions.Default;
  Source := TFileStream.Create(SourceName, fmOpenRead or fmShareDenyWrite);
  try
    if not SubsetPdfDocumentFonts(Source, Options, Output, Report) then
      raise Exception.Create('Font subsetting failed: ' + Report.ErrorMessage);
  finally
    Source.Free;
  end;
  // 출력은 항상 완전한 PDF입니다. Report.Applied가 True면 재구축된
  // 파일이고, 그 외에는 소스의 바이트 단위 사본입니다
  Target := TFileStream.Create(TargetName, fmCreate);
  try
    if Length(Output) > 0 then
      Target.WriteBuffer(Output[0], Length(Output));
  finally
    Target.Free;
  end;
end;
SubsetPdfDocumentFonts는 CIDFont의 글리프 도메인을 어떻게 증명하나
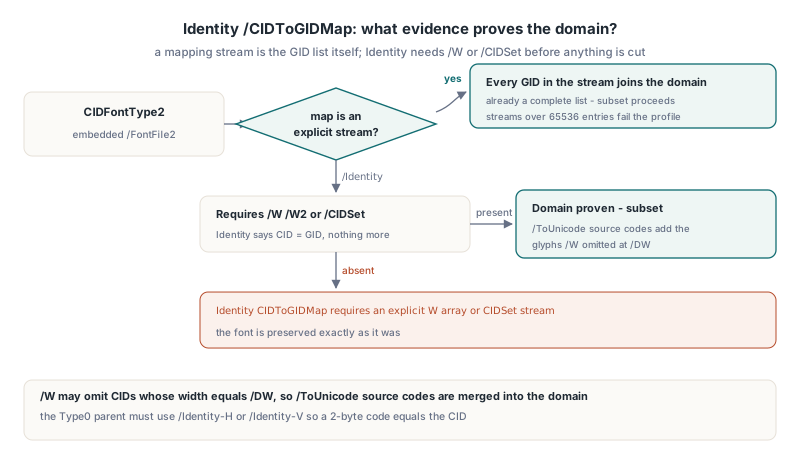
SubsetPdfDocumentFonts는 CID-to-글리프 매핑에서 CIDFontType2 폰트의 글리프 도메인을 증명하며, 매핑이 얼마나 많은 추가 증거가 필요한지 정합니다. 명시적 /CIDToGIDMap 스트림(ISO 32000-1 §9.7.4.2)은 이미 폰트가 주소 지정할 수 있는 모든 글리프의 목록이므로, 스트림의 모든 GID가 도메인에 합류합니다. 65536 항목을 넘는 매핑 스트림이나 홀수 바이트 수의 스트림은 한도 있는 프로필을 실패시키고 폰트는 보존됩니다
/CIDToGIDMap /Identity가 어려운 사례이자 현대 파일에서 가장 흔한 사례입니다. Identity는 CID가 GID와 같다고 말하지만, 문서가 어떤 CID를 쓰는지는 아무것도 말해 주지 않습니다. 따라서 컴포넌트는 1차 증거를 요구합니다. 생산자가 메트릭을 선언한 글리프를 표시하는 CID 항목을 가진 명시적 /W나 /W2 폭 배열(§9.7.4.3), 또는 폰트 기술자의 /CIDSet 스트림(§9.8.3), CID마다 한 비트, 최상위 비트 먼저인 비트맵입니다. 둘 다 없는 벌거벗은 Identity 폰트는 Identity CIDToGIDMap requires an explicit W array or CIDSet stream라는 이유로 보존됩니다
/W를 증거로 쓸 때의 함정은 /DW입니다. 생산자는 폭이 기본 폭과 같은 모든 CID를 빼도 되며, 잘 최적화된 라이터는 가장 흔한 글리프 폭에 대해 정확히 그렇게 합니다. 도메인이 /W만에서 왔다면 그 글리프들은 서브셋에서 조용히 사라질 것입니다. 그 빈틈을 메우려고 컴포넌트는 /DescendantFonts가 CIDFont를 가리키는 모든 Type0 폰트를 걸으며, 2바이트 코드가 CID가 되도록 /Encoding이 /Identity-H나 /Identity-V여야 한다고 요구하고, 그 /ToUnicode CMap(§9.10.3)의 모든 beginbfchar와 beginbfrange 항목의 소스 코드를 도메인에 병합합니다. 다른 인코딩이거나 예산 안에서 디코딩할 수 없는 /ToUnicode 스트림은 폰트를 보존합니다
단순 TrueType 폰트: Widths에서 글리프 ID까지
단일 바이트 /Subtype /TrueType 폰트는 코드 범위와 인코딩으로 증명된 뒤 폰트 프로그램 자체의 cmap으로 글리프 ID를 풀립니다. 컴포넌트는 0 <= FirstChar <= LastChar <= 255와 길이가 정확히 LastChar - FirstChar + 1인 /Widths 배열을 요구합니다. 짧거나 길거나 숫자가 아닌 배열은 코드 도메인이 증명되지 않았다는 뜻이며 폰트는 그대로 둡니다
그 범위의 각 코드와 /Differences가 이름 짓거나 /ToUnicode가 커버하는 코드는 ISO 32000-1 §9.6.6이 기술하는 방식으로 매핑됩니다. /WinAnsiEncoding, /MacRomanEncoding, /StandardEncoding 아래의 코드는 맞는 표를 거쳐 유니코드로 갑니다. /Differences 글리프 이름은 Adobe Glyph List와 uniXXXX, uXXXX 이름, 258개 표준 매킨토시 글리프 이름, 폰트 자체 post 형식 2.0 이름 테이블로 해석됩니다. 결과 값은 유니코드 (3,1), (3,10), (0,*), 매킨토시 로마자 (1,0), 그리고 F000 더하기 코드의 윈도우 심볼 (3,0)을 포함해 형식 0, 4, 6, 12 cmap 하위 테이블에서 조회됩니다
폰트에 기본 인코딩이 전혀 없으면 컴포넌트는 하나를 추측하는 대신 그럴듯한 모든 해석의 합집합을 표시합니다. 아마도 쓰이지 않는 몇 글리프가 남는데, 틀리기로 하면 이쪽이 맞는 방향입니다. 반대 사례는 엄격합니다. 증명된 글리프 ID로 매핑되지 않는 /Differences 이름은 폰트 전체를 거부합니다. 하나의 미해석 이름은 도메인이 불완전하다는 뜻이기 때문입니다
procedure ReportFontSubset(Source: TStream; Log: TStrings);
var
  Options: TPdfDocumentFontSubsetOptions;
  Report: TPdfDocumentFontSubsetReport;
  Output: TBytes;
  I: Integer;
begin
  Options := TPdfDocumentFontSubsetOptions.Default;
  Options.SubsetOptions.MinimumSavingPercent := 10;  // 폰트당
  Options.MinimumDocumentSavingPercent := 5;         // 파일 전체
  if not SubsetPdfDocumentFonts(Source, Options, Output, Report) then
  begin
    Log.Add('Rejected: ' + Report.ErrorMessage);
    Exit;
  end;
  Log.Add(Format('Fonts %d, subset %d, preserved %d, glyphs %d',
    [Report.FontCount, Report.SubsetFontCount, Report.PreservedFontCount,
     Report.GlyphCount]));
  Log.Add(Format('Font bytes %d -> %d, file bytes %d -> %d',
    [Report.OriginalFontBytes, Report.SubsetFontBytes,
     Report.SourceByteCount, Report.OutputByteCount]));
  for I := 0 to High(Report.Issues) do
    Log.Add(Format('  object %d kept: %s',
      [Report.Issues[I].ObjectNumber, Report.Issues[I].Reason]));
end;
SubsetPdfDocumentFonts는 무엇을 그대로 두나
SubsetPdfDocumentFonts는 증명할 수 없는 모든 폰트를 그대로 두고, 문서를 실패시키는 대신 각각을 객체 번호와 이유를 담아 Report.Issues에 보고합니다. Report.Complete는 폰트가 하나도 보존되지 않았을 때만 True입니다. 크기 절감을 약속하기 전에 알아 둘 가치가 있는 보존 사례들입니다:
- Type 1
/FontFile과 CFF 또는 OpenType/FontFile3프로그램,Only TrueType FontFile2 programs are supported로 보고됨 /W,/W2,/CIDSet이 없는 Identity CIDFont, 매핑 스트림도/Identity도 없는 CIDFont- 폰트 기술자 이외 어딘가에서 참조되는 폰트 프로그램,
CIDFontType2나 단순TrueType이 아닌 소비자와 공유되는 기술자 - 서브셋이
SubsetOptions.MinimumSavingPercent를 놓치는 폰트, 그리고 재구축된 파일이MinimumDocumentSavingPercent를 놓치면 모든 폰트. 그 경우Report.Applied는False이고 출력은 원본 바이트입니다
두 입력은 보존되는 대신 즉시 실패합니다. 서명된 문서와 서명 필드가 있는 문서는 거부됩니다. 폰트 객체를 교체하면 모든 서명의 바이트 범위가 무효화되기 때문입니다. 암호화된 파일에는 먼저 복호화된 소스가 필요합니다. 성공한 실행은 교체 객체를 성긴 업데이트로 쓴 뒤 고아 객체 가지치기와 리소스 중복 제거 가이드가 기술한 것과 같은 도달 가능성 패스로 파일을 재건하므로, 오래된 폰트 프로그램은 도달 불가능한 객체로 남지 않고 결과는 하나의 깨끗한 리비전입니다
saSubsetNewFonts로 저장 시점에 새 텍스트 서브셋하기
PDFium Component가 현재 세션에서 임베드하는 폰트는 별개 사례로, SubsetPdfDocumentFonts가 아니라 saSubsetNewFonts 저장 옵션이 처리합니다. saSubsetNewFonts는 PDFium FPDF_SUBSET_NEW_FONTS 플래그에 대응하며, 이것은 OpenType CFF 서체를 포함해 TPdf.AddText 같은 네이티브 호출이 시스템에서 적재한 폰트에 네이티브 HarfBuzz 서브셋터를 돌립니다. 업스트림 PDFium은 여전히 그 플래그를 실험적이라고 표시합니다. 이미 파일에 있던 폰트는 건드리지 않습니다
var
  Pdf: TPdf;
begin
  Pdf := TPdf.Create(nil);
  try
    Pdf.CreateDocument;
    Pdf.AddPage(0, 595, 842);
    Pdf.AddText('Quarterly statement', 'Arial', 14, 72, 770, clBlack, $FF, 0.0);
    if not Pdf.SaveAs('statement.pdf', saSubsetNewFonts) then
      raise Exception.Create('Save failed');
  finally
    Pdf.Free;
  end;
end;
컴포넌트의 프로브에서 Arial 텍스트를 가진 문서는 saSubsetNewFonts 아래 590 KB에서 22 KB로 떨어졌고, 저장된 파일의 텍스트 추출은 여전히 정확히 일치했습니다. COLR v0 컬러 폰트, 7.0 MB의 Segoe UI Emoji는 같은 경로로 10.5 KB까지 갔으며, PDF에는 COLR 레이어 개념이 없으므로 기본 외곽선으로 렌더됐습니다. 가변 폰트는 예외이고 블록은 서브셋터 앞에 앉습니다. GDI GetFontData는 1.85 MB Segoe UI Variable 파일에 대해 18.3 MB 대체 스트림을 돌려줬고, 텍스트 객체 생성은 어떤 서브셋팅도 시작되기 전에 실패했습니다. Delphi에서 CID Type 2 폰트 임베딩 워크스루가 그 폰트들이 먼저 거치는 임베딩 경로를 다룹니다
증명이 멈추는 곳
SubsetPdfDocumentFonts 안의 증명은 생산자가 쓴 폰트 메타데이터만큼만 강합니다. 증거가 /W뿐인 Identity CIDFont에는 여전히 사각지대가 하나 있습니다. 폭이 /DW와 같고, /ToUnicode 항목이 없고, 기술자가 /CIDSet에 나열하지 않는 글리프입니다. 그런 글리프는 리소스에서 증명할 수 없고, 컴포넌트는 의도적으로 피하는 콘텐츠 스트림 스캔 없이는 그것이 존재하는지 알 수 없습니다. /W를 압축하면서 /ToUnicode와 /CIDSet을 둘 다 생략하는 생산자는 드물지만 존재하므로, 알 수 없는 생성기의 보관함이라면 전후로 샘플을 렌더해 픽셀과 추출 텍스트를 비교하십시오
배치를 돌리기 전에 무엇을 다루는지 아는 것도 도움이 됩니다. PDFium Component로 PDF 폰트 속성 읽기의 접근이 어떤 폰트가 임베드되어 있는지 알려 주고, 드라이런의 Report.Issues가 그중 어느 것이 보존될지와 왜 그런지 알려 줍니다. 기본 옵션도 작업에 한도를 둡니다. 1024 폰트, 총 약 백만 글리프, 128 MB 소스, 고정 작업 예산이며, 긴 배치 작업을 위한 선택적 CancellationToken이 있습니다
FAQ
SubsetPdfDocumentFonts는 PDF의 텍스트나 레이아웃을 바꾸나요?
아니요. 원본 글리프 ID와 CID, 폭, 콘텐츠 스트림이 유지되므로 텍스트 추출과 렌더링은 이전과 같은 글리프를 씁니다. 도달할 수 없는 외곽선만 제거되고 폰트 이름에 새 서브셋 접두어가 붙습니다
임베드된 폰트가 서브셋되지 않은 이유는요?
Report.Issues를 읽으십시오. 보존된 각 폰트는 Identity CIDFont의 없는 /W나 /CIDSet, TrueType이 아닌 프로그램, 형태가 잘못된 /Widths 배열, 임계값 미달 절감 같은 이유를 실습니다
saSubsetNewFonts는 SubsetPdfDocumentFonts와 같은가요?
아니요. saSubsetNewFonts는 저장할 때 현재 세션에서 임베드된 폰트를 서브셋하고, SubsetPdfDocumentFonts는 기존 PDF 스트림으로 동작해 다른 생산자가 이미 임베드한 폰트를 교체합니다
문서 폰트 서브셋팅, 저장 시점 폰트 서브셋팅, 그 뒤의 고아 가지치기 패스는 모두 Delphi 및 C++Builder용 PDFium Component와 함께 제공되며, Delphi, C++Builder, Lazarus 프로젝트를 위해 PDFium을 감쌉니다