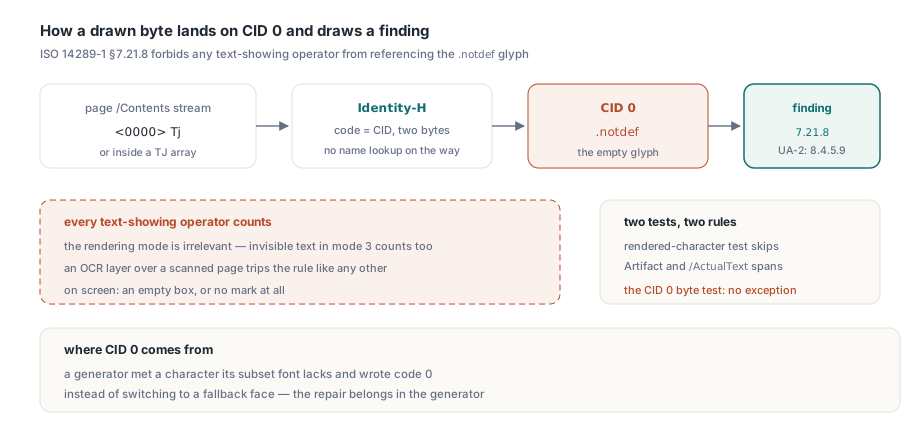
veraPDF는 태그를 단 분기 보고서에서 ISO 14289-1 §7.21.8로 실패를 선고합니다. 단 하나의 Tj 연산자가 바이트 <0000>을 보여 주는데, Identity-H 아래에서 이는 .notdef glyph인 CID 0을 뜻하죠. 그 조항과 이웃인 §7.21.6, 즉 TrueType /Differences 배열이 쓸 수 있는 glyph 이름을 제한하는 조항은, Delphi에서는 PDFium Component의 TPdf.ValidatePdfUa 결과에서 별개 플래그로 나타납니다
어느 텍스트 연산자가 .notdef glyph를 참조하는가
피연산자가 glyph 0으로 맵핑되는 텍스트 표시 연산자 전부입니다. simple font에서 .notdef는 glyph 이름입니다. CID-keyed font에서는 같은 역할이 CID 0에 속하고, ISO 32000-2 §9.7.4.2는 모든 CIDFont가 CID 0의 glyph 기술을 담기를 요구합니다. "simple font의 .notdef 문자 이름과 유사한" 것이죠. 평범한 Identity-H 인코딩에서는 문자 코드와 CID가 같은 두 바이트이므로, <0000>을 Tj로 또는 TJ 배열 안에서 보여 주는 content stream은 CID 0을 그리는 중입니다. ISO 14289-1 §7.21.8은 어떤 텍스트 표시 연산자도 그러지 못하게 금지하고, PDF/UA-2는 같은 요구를 §8.4.5.9에서 기술합니다. 텍스트 rendering 모드는 무관합니다. 모드 3의 보이지 않는 텍스트, 스캔 페이지 위의 OCR 레이어 같은 것도 세어 집니다. 화면에서의 결과는 보통 몇 포인트 폭의 빈 상자이거나 아무 표시도 아니며, 어느 쪽도 눈으로 교정하는 이에게 문자 하나가 사라졌다고 말해 주지 않습니다
흔한 원인은 subset 폰트에 없는 문자를 만난 generator가 fallback face로 갈아탔어야 할 자리에 코드 0을 적은 것입니다. 덕분에 바이트 수준 검사는 기분 좋을 만큼 정밀해집니다. 각 페이지의 /Contents가 참조하는 스트림만 디코딩하고, Type 0 폰트를 쓰는 문서에서 <0000>이 Tj나 TJ로 들어가는 것을 찾으며, 이미지와 ICC 프로필, CMap은 압축된 채로 둡니다. 페이지를 아예 찾는지 여부는 파싱 디테일 하나가 정합니다. ISO 32000-1 §7.3.5는 name 토큰을 다음 구분자에서 끝내므로, 공백 없는 /Type/Page도 유효한 페이지 딕셔너리이고, 공백 형태 /Type /Page만 찾는 검색은 그것을 건너뜁니다. Differences 배열 안에 /.notdef를 이름으로 쓰는 것 자체는 이 규칙을 걸지 않습니다. 그 슬롯에 떨어지는 코드를 보여 줄 때만 걸리죠
어느 /Differences glyph 이름이 Unicode compliant로 치는가
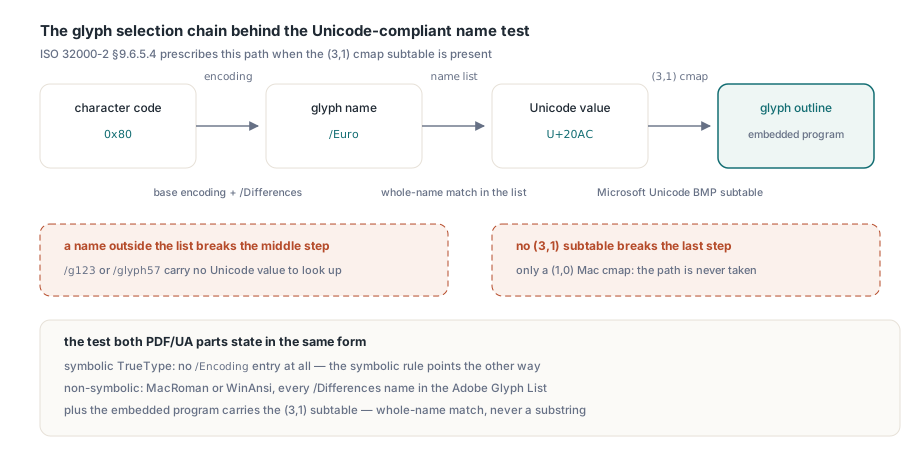
Adobe Glyph List에 실린 이름이 그렇습니다. 단, 임베디드 폰트 프로그램도 (3,1) cmap subtable을 지녀야 합니다. 배경은 ISO 32000-2 §9.6.5.4로, non-symbolic TrueType 폰트가 Differences 배열 없이 MacRomanEncoding이나 WinAnsiEncoding을 쓸 것을 권합니다. PDF/UA는 그 권고를 탈출구 하나를 달아 요구로 만들죠. 양쪽 PDF/UA part는 검사를 veraPDF가 적용하는 것과 같은 형태로 기술합니다. 폰트가 symbolic이거나, 또는 그 인코딩이 MacRoman이나 WinAnsi이며 /Differences 배열이 없거나 그 배열의 모든 이름이 Unicode compliant인 경우입니다. (3,1) 조건은 §9.6.5.4가 그 subtable(Microsoft 플랫폼, Unicode BMP)이 있을 때 정해 놓은 glyph 선택 순서에서 따라 옵니다. 문자 코드는 인코딩을 거쳐 glyph 이름으로, glyph 이름은 Adobe Glyph List를 거쳐 Unicode로, Unicode는 (3,1) subtable을 거쳐 glyph으로 갑니다. 목록 밖의 이름은 중간 단계를 끊고, subtable이 없는 폰트는 그 길을 아예 택하지 않습니다. symbolic 폰트 규칙은 반대쪽을 가리킵니다. symbolic TrueType 폰트는 /Encoding 항목을 아예 실어서는 안 됩니다
| 폰트 딕셔너리 | 결과 |
|---|---|
non-symbolic, /Encoding /WinAnsiEncoding, Differences 없음 | 통과 |
non-symbolic, WinAnsi 베이스, /Euro /bullet /.notdef의 Differences, 폰트는 (3,1) cmap 보유 | 통과 |
non-symbolic, /g123이나 /glyph57을 담은 Differences | 실패: 이름이 glyph 목록에 없음 |
| non-symbolic, 유효한 Differences, 임베디드 폰트는 (1,0) Mac cmap만 보유 | 실패: (3,1) subtable 없음 |
non-symbolic, Differences를 지닌 WinAnsi 베이스, FontFile2 미임베드 | 이 규칙으로는 결정되지 않으며, 임베드 규칙(§7.21.4)이 실패를 선고합니다 |
non-symbolic, /Encoding 항목 없음 | 실패 |
symbolic, 임의의 /Encoding 항목 | symbolic 규칙으로 실패 |
두 번째 행이 자작 glyph 목록이 틀어지는 지점입니다. veraPDF가 폰트 코드와 함께 실어 나르는 목록, font/AdobeGlyphList.txt는 4,282 항목을 지니며 첫 줄이 .notdef 0000입니다. 손으로 조립했거나 다른 곳에서 가져온 표에는 그 항목이 없을 때가 많은데, .notdef는 실제 문자를 뜻하지 않으니까요. 그런 표 위에 세운 검사기는 Differences 배열이 /.notdef를 언급하는 모든 폰트를 보고합니다. 안 쓰는 슬롯을 그것으로 채우는 subset 폰트에 정기적으로 등장하는 이름이죠. 매치는 이름 전체로 합니다. 부분 문자열 검색이라면 /grave가 목록에 있다는 이유만으로 /grav를 받아 버리겠죠. 안 쓰는 Differences 슬롯은 .notdef로 마음껏 채우세요. veraPDF를 따르는 검사기는 이를 받아 줍니다
폰트 규칙은 생산자가 적은 바이트로 판정합니다
자연스러운 지름길은 문서의 정규화된 복사본을 저장해 그것을 스캔하는 것입니다. 다시 쓴 파일이 파싱하기 쉬우니까요. 폰트 규칙에는 그게 실패합니다. PDF를 다시 직렬화하는 도구는 폰트 딕셔너리를 자유롭게 재건합니다. Differences 배열을 새 인코딩으로 접어 넣고, glyph 이름을 바꾸고, 객체 번호를 다시 매기는 일이죠. 따라서 인코딩 규칙은 생산자가 적은 바이트에 대해 검사되어야 합니다. TPdf.ValidatePdfUa는 폰트 검사를 자기가 로드한 파일이나 메모리 버퍼 위에서 돌리고, TrueType 표 디렉터리에 닿으려고 FontFile2 스트림을 곧장 디코딩합니다. 문자 수준 검사(그려진 문자가 Unicode 0으로 맵핑되는가?)는 페이지가 렌더링하는 텍스트를 쓰고 Artifact로 표시되었거나 /ActualText가 덮은 content는 건너뛰지만, CID 0 바이트 검사는 그런 예외를 두지 않습니다. 지적은 issue 집합에서 별개 값으로 도착하므로, 보고서는 어느 규칙이 발화했는지 말할 수 있습니다:
uses
  SysUtils, PDFium, FPdfPdfua;

procedure ReportFontFindings(const FileName: string);
const
  FontIssues: TPdfUaValidationIssues = [pvuaiPdfiumNotDefGlyph,
    pvuaiTrueTypeEncodingInvalid, pvuaiSymbolicTrueTypeEncoding,
    pvuaiFontNotEmbedded, pvuaiFontMissingToUnicode];
var
  Pdf: TPdf;
  Report: TPdfUaValidationResult;
  Found: TPdfUaValidationIssues;
  Coverage: TPdfUaUnicodeCoverageReport;
  I: Integer;
begin
  Pdf := TPdf.Create(nil);
  try
    Pdf.FileName := FileName;
    Pdf.Active := True;
    if not Pdf.Active then
      raise Exception.CreateFmt('Cannot open %s', [FileName]);
    Report := Pdf.ValidatePdfUa;
    Found := Report.Issues * FontIssues;
    if pvuaiPdfiumNotDefGlyph in Found then
    begin
      Writeln('Text references .notdef / CID 0 (7.21.8, 8.4.5.9)');
      // Unicode 값으로 맵핑되지 않는 렌더링된 문자를 찾습니다
      Coverage := Pdf.InspectPdfUaUnicodeCoverage;
      for I := 0 to High(Coverage.Objects) do
        if Coverage.Objects[I].MissingUnicodeCharacterCount > 0 then
          Writeln(Format('  page %d, object %d: %d character(s)',
            [Coverage.Objects[I].PageNumber,
             Coverage.Objects[I].PageObjectIndex,
             Coverage.Objects[I].MissingUnicodeCharacterCount]));
    end;
    if pvuaiTrueTypeEncodingInvalid in Found then
      Writeln('Non-symbolic TrueType encoding or Differences (7.21.6, 8.4.5.7)');
    if pvuaiSymbolicTrueTypeEncoding in Found then
      Writeln('Symbolic TrueType font carries an /Encoding entry');
    if pvuaiFontNotEmbedded in Found then
      Writeln('A font program is not embedded (7.21.4)');
    if pvuaiFontMissingToUnicode in Found then
      Writeln('A font has no usable Unicode mapping (7.21.7)');
    if Found = [] then
      Writeln('No font findings');
    // 유일한 결함이 Differences 배열의 /g123인 파일의 기대 결과:
    // 7.21.6 줄 하나
  finally
    Pdf.Free;
  end;
end;
수리는 파일을 쓴 프로그램 안에 속합니다
어느 지적도 뒤늦게 딕셔너리를 편집해 안전하게 고칠 수 없습니다. CID 0 참조는 쓰인 폰트에 그 문자의 glyph가 없었다는 뜻이므로, generator는 그 문자를 위한 fallback 폰트가 필요합니다. <0000>을 다른 코드로 다시 쓰면 엉뚱한 glyph를 그리고 거기에 잘못된 Unicode 값을 붙입니다. /g123 같은 이름을 지닌 Differences 배열은 보통 표준 이름이 없는 glyph를 지닌 폰트를 subsetting한 데서 옵니다. 깨끗한 수리는 그 face를 CID-keyed TrueType 폰트로 임베드하는 것, 즉 CID Type 2 폰트 임베딩이 쓰는 설정이며, Identity-H와 /ToUnicode CMap을 곁들입니다. 그러면 simple font 인코딩 규칙이 판 밖으로 나갑니다
§7.21.6을 없애려고 Symbolic 플래그를 세팅하는 것은 잘못된 수입니다. symbolic TrueType 폰트는 /Encoding을 아예 실어서는 안 됩니다. 각 코드가 어느 문자를 뜻하는지 screen reader에게 말해 주던 Differences 이름들은 그와 함께 사라지고, 모든 뷰어는 (3,0)이나 (1,0) subtable을 통해 날코드로 glyph를 고르게 됩니다. 플래그는 치워집니다. 텍스트의 의미도 함께 가죠
임베디드 폰트 프로그램은 (3,1) cmap을 지니는가
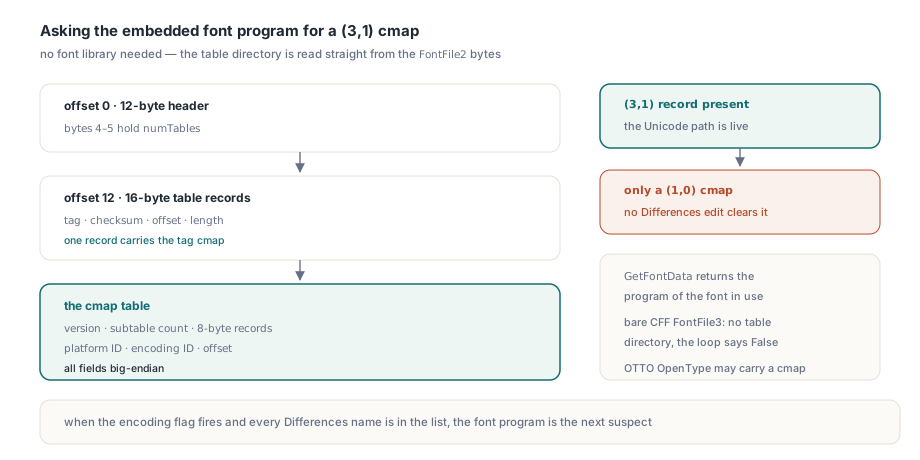
폰트 프로그램에게 직접 물으세요. 인코딩 플래그는 검사의 양쪽 절반을 함께 뒤덮어 어느 쪽이 실패했는지 말하지 못하니까요. 플래그가 발화했는데 모든 Differences 이름이 목록 안에 있다면 프로그램이 다음 용의자입니다. TrueType 파일은 12바이트 header로 시작하며 그 바이트 4–5가 표 개수를 담고, 16바이트 표 record(tag, checksum, offset, length)가 뒤따릅니다. cmap 표는 version과 subtable 개수로 시작하고, platform ID와 encoding ID, offset의 8바이트 record가 뒤따릅니다. 모두 big-endian이죠. 폰트 라이브러리는 필요 없습니다. TPdf.GetFontData는 페이지 객체가 쓰는 폰트의 임베디드 프로그램을 반환하므로, 헬퍼는 페이지의 모든 텍스트 객체에 돌릴 수 있습니다:
function BE16(const B: TBytes; P: Integer): Integer;
begin
  Result := (B[P] shl 8) or B[P + 1];
end;

function BE32(const B: TBytes; P: Integer): Cardinal;
begin
  Result := (Cardinal(B[P]) shl 24) or (Cardinal(B[P + 1]) shl 16) or
    (Cardinal(B[P + 2]) shl 8) or B[P + 3];
end;

// TrueType 프로그램이 (Platform, Encoding)의 cmap subtable을 지니면 True
function HasCmapSubtable(const Font: TBytes; Platform, Encoding: Integer): Boolean;
var
  Tables, I, Rec, CmapOfs, Count: Integer;
begin
  Result := False;
  if Length(Font) < 12 then
    Exit;
  Tables := BE16(Font, 4);
  CmapOfs := -1;
  for I := 0 to Tables - 1 do
  begin
    Rec := 12 + I * 16;
    if Rec + 16 > Length(Font) then
      Exit;
    if (Font[Rec] = Ord('c')) and (Font[Rec + 1] = Ord('m')) and
       (Font[Rec + 2] = Ord('a')) and (Font[Rec + 3] = Ord('p')) then
      CmapOfs := Integer(BE32(Font, Rec + 8));
  end;
  if (CmapOfs < 0) or (CmapOfs + 4 > Length(Font)) then
    Exit;
  Count := BE16(Font, CmapOfs + 2);
  for I := 0 to Count - 1 do
  begin
    Rec := CmapOfs + 4 + I * 8;
    if Rec + 8 > Length(Font) then
      Exit;
    if (BE16(Font, Rec) = Platform) and (BE16(Font, Rec + 2) = Encoding) then
      Exit(True);
  end;
end;

// Mac Roman (1,0) cmap만 지닌 face는 cmap(3,1)=False를 인쇄합니다
procedure ListTextFonts(Pdf: TPdf; PageNo: Integer);
var
  I: Integer;
begin
  Pdf.PageNumber := PageNo;
  for I := 0 to Pdf.ObjectCount - 1 do
    if Pdf.ObjectType[I] = otText then
      Writeln(Format('%-32s embedded=%-5s cmap(3,1)=%s', [
        string(Pdf.GetFontBaseName(I)),
        BoolToStr(Pdf.GetFontIsEmbedded(I), True),
        BoolToStr(HasCmapSubtable(Pdf.GetFontData(I), 3, 1), True)]));
end;
같은 폰트를 공유하는 텍스트 객체는 같은 줄을 되풀이해서 인쇄합니다. 여기서는 무해합니다. 맨몸 CFF 프로그램(/Type1C이나 /CIDFontType0C인 FontFile3)은 표 디렉터리가 없으므로 헬퍼는 그에 대해 False로 답하고, 규칙은 TrueType 폰트를 다루므로 그 답은 여기서 아무것도 결정하지 않습니다. CFF outline을 지닌 OpenType 폰트는 다릅니다. OTTO 태그 아래 sfnt 디렉터리를 실어 cmap을 포함할 수 있는데, 같은 루프가 그것을 찾습니다. 프로그램이 메모리에 있는 동안 그 hmtx advance 폭을 폰트 딕셔너리의 /Widths와 비교해 볼 가치도 있습니다. PDF/UA에는 별개의 폭 일관성 규칙이 있고, glyph 폭, CharSet, CIDSet 감사가 PDFlibPas 쪽에서 그것을 적용하니까요
§7.21.6 플래그 뒤의 face에 대해 HasCmapSubtable이 False를 반환한다면 그 Differences 배열을 어떻게 편집해도 지적은 치워지지 않으며, generator는 그 face를 ToUnicode CMap을 지닌 Type 0 폰트로 임베드해야 합니다. 재생성된 파일에 대해 Delphi용 PDFium Component 검증을 다시 돌리고 pvuaiTrueTypeEncodingInvalid가 Report.Issues에서 빠져 있기를 기대하세요