스캔 배치가 페이지당 JPEG 하나뿐이고 폰트도 주석도 책갈피도 없어도 PDF/raster로는 실패할 수 있습니다. ISO 23504-1은 래스터 전용 페이지 이상을 요구합니다. 트레일러 영역의 %PDF-raster-1.0 주석으로 스스로를 식별하고, XMP 메타데이터와 트레일러 /ID를 실어야 하며, 카탈로그와 Info 딕셔너리는 짧은 허용 목록 안에 머물러야 합니다. 따라서 캡처 배치 점검에는 서로 다른 두 읽기가 필요합니다. 하나는 raw 바이트 위에서, 하나는 각 페이지가 실제로 그리는 것 위에서
같은 파일의 두 가지 읽기
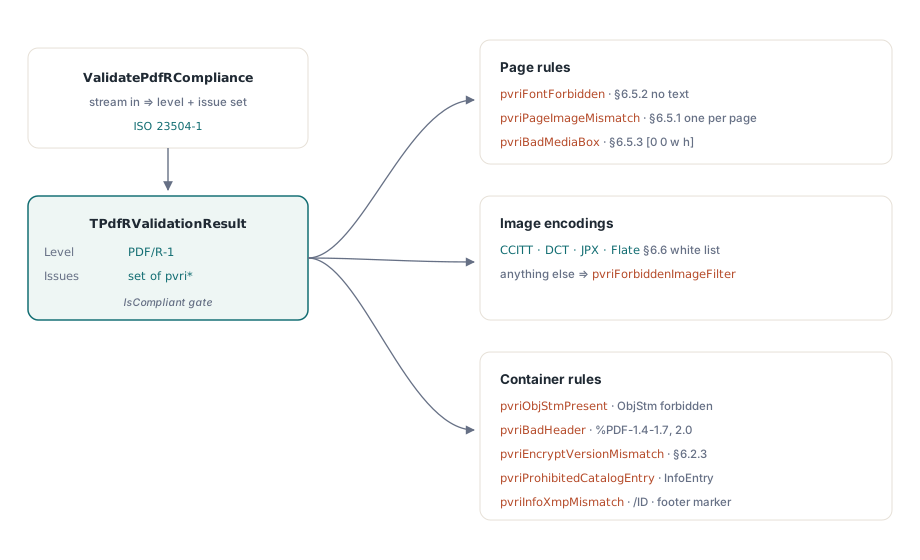
PDF/R 검증과 SaveAsPdfR는 PDFium Component의 Small Business와 Enterprise 에디션에 함께 오며, 검증은 그 선을 따라 갈라집니다. FPdfPdfr 유닛의 ValidatePdfRCompliance는 스트림을 읽어 바이트 수준 규칙을 점검합니다. 헤더 버전, 래스터 마커, 오브젝트 스트림, 카탈로그와 Info 항목, XMP, 트레일러 /ID, MediaBox 원점, 폰트 리소스, 금지된 필터 이름, 그리고 이미지 오브젝트 수가 페이지 수와 일치하는지입니다. ValidatePdfRPageFacts는 TPdfRPageFacts 레코드로 한 번에 한 페이지씩 점검합니다. 페이지가 그리는 텍스트, 경로, 폼, 셰이딩 오브젝트의 수, 단일 스트립 이미지의 위치, 픽셀 크기, 비트 깊이, 색공간, 필터 체인이 그 대상입니다
두 읽기는 하나의 열거형 TPdfRValidationIssue로 보고하고, 결합 진입점은 둘을 하나의 TPdfRValidationResult로 합칩니다. 그 Conformance 필드는 래스터 마커가 발견될 때만 prc1이 되고, IsCompliant는 수준이 prc1이고 이슈 집합이 비어 있을 때만 True를 돌려줍니다. 나머지 모든 면에서 완벽하지만 마커가 없는 파일은 prcNone을 보고하는데, 깨끗한 스캔을 처음 통과시켜 본 사람은 이것에 놀랍니다
질문은 페이지 팩트가 어디서 오는가입니다. TPdf.ValidatePdfR는 로드된 문서에서 수집하지만, 그 전에 문서를 임시 저장소로 직렬화하고 재저장 사본에 바이트 점검을 돌리므로, 마커와 카탈로그 판정은 새 저장을 기술하며 디스크의 파일과 다를 수 있습니다. FPdfBusinessWorkflows의 ValidatePdfRasterSource는 입력 스트림의 스냅샷 하나를 떠서 두 읽기를 모두 그것에 대해 돌립니다. 아카이브에 들어가기 직전의 파일에는 이 호출을 쓰세요. 판정이 아카이브되는 바이트를 참조하게 됩니다
uses
  System.Classes, System.SysUtils, System.TypInfo,
  FPdfPdfr, FPdfReport, FPdfBusinessWorkflows;

procedure CheckDeliveredScan(const FileName: string; Log: TStrings);
var
  Src: TFileStream;
  Options: TPdfRasterSourceValidationOptions;
  Report: TPdfRasterSourceValidationReport;
  Issue: TPdfRValidationIssue;
  I: Integer;
begin
  Options := TPdfRasterSourceValidationOptions.Default;
  Options.MaxInputBytes := 512 * 1024 * 1024;     // 기본 예산은 64 MiB
  Options.Validation.MinimumResolutionDpi := 200; // 우리 캡처 계약
  Src := TFileStream.Create(FileName, fmOpenRead or fmShareDenyWrite);
  try
    if not ValidatePdfRasterSource(Src, Options, Report) then
    begin
      Log.Add(Format('Check stopped (%s): %s',
        [GetEnumName(TypeInfo(TPdfRasterSourceStatus), Ord(Report.Status)),
         Report.ErrorMessage]));
      Exit;
    end;
  finally
    Src.Free;
  end;

  if Report.IsCompliant then
    Log.Add('PDF/R-1 conformant')
  else
  begin
    // Validation.Issues는 바이트 수준 이슈와 모든 페이지 이슈를 담습니다
    for Issue := Low(TPdfRValidationIssue) to High(TPdfRValidationIssue) do
      if Issue in Report.Validation.Issues then
        Log.Add('File: ' + GetEnumName(TypeInfo(TPdfRValidationIssue), Ord(Issue)));
    // PageIssues는 어느 페이지를 다시 스캔할지 말해 줍니다
    for I := 0 to Report.ProcessedPageCount - 1 do
      for Issue := Low(TPdfRValidationIssue) to High(TPdfRValidationIssue) do
        if Issue in Report.PageIssues[I] then
          Log.Add(Format('Page %d: %s', [Report.Pages[I].PageNumber,
            GetEnumName(TypeInfo(TPdfRValidationIssue), Ord(Issue))]));
  end;

  // 기계가 읽을 수 있는 판정을 아카이브 파일 곁에 남깁니다
  Log.Add(Report.ToJson(TPdfReportLimits.Default));
end;TPdfRasterSourceValidationOptions의 기본값 두 개가 스캔 배치에서 중요합니다. MaxInputBytes는 64 MiB이고 MaxPages는 1000입니다. 컬러 스캔의 긴 배치는 바이트 예산을 넘길 수 있고, 그러면 점검은 상태 prssBudgetExceeded와 False인 Complete로 끝납니다. MemoryLimitBytes는 8 MiB이며, 넘으면 스냅샷이 TemporaryDirectory로 흘러 넘치고 보고서는 SnapshotSpilled를 설정합니다. Report.IsCompliant는 Complete도 요구하므로 중간에 멈춘 점검이 통과로 읽히는 일은 없습니다
OCR 텍스트 레이어는 왜 PDF/R에 실패하는가
래스터 페이지는 스캔 이미지를 그리고 그 외에는 아무것도 그리지 않기 때문입니다. 보이지 않는 OCR 레이어는 PDF/A 워크플로에서 평범한 추가이며, PDF/R이 배제하는 두 가지를 파일에 넣습니다. 바이트 읽기가 pvriFontForbidden으로 보고하는 폰트 리소스와, 페이지 읽기가 pvriNonRasterPageContent로 보고하는 페이지 위의 텍스트 오브젝트입니다. 같은 페이지 이슈가 벡터 경로, 셰이딩, 폼 XObject에도 발화하므로, 찍어 넣은 페이지 번호나 그린 테두리 선도 숨은 텍스트와 똑같이 실패합니다
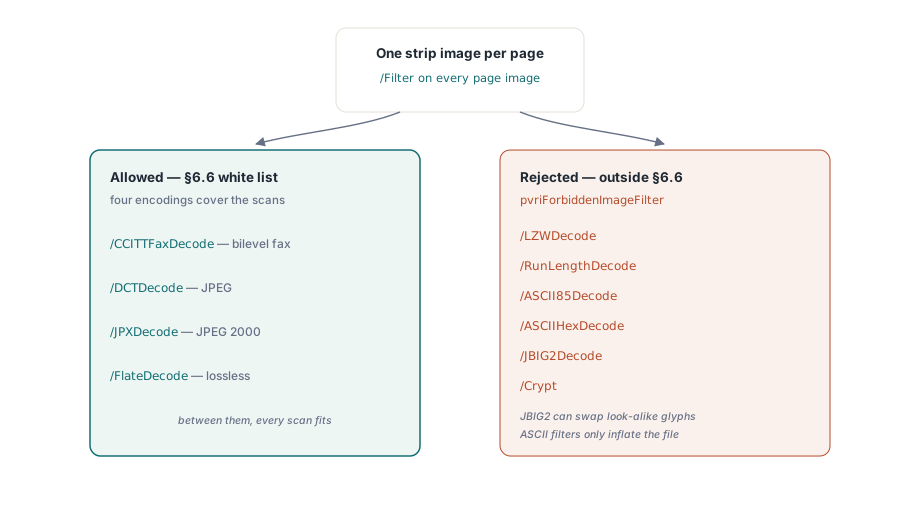
페이지-이미지 관계도 엄격합니다. 각 페이지는 정확히 하나의 스트립 이미지를 실어야 하고, pvriPageImageMismatch는 이미지가 없는 페이지에서도, 스캔이 나란히 놓인 두 이미지로 기록된 페이지에서도 발화합니다. 바이트 쪽에서 개수는 /Subtype이 /Image인 모든 오브젝트에 대해 세어지므로, 스트립에 붙은 소프트 마스크 같은 추가 이미지 오브젝트 하나로도 총수가 페이지 수를 넘습니다
기하는 두 가지 점검을 받습니다. pvriBadMediaBox는 [0 0 ...]으로 시작하지 않는 MediaBox를 보고하며, 바이트 읽기가 인라인 숫자 배열을 들여다봅니다. 그다음 페이지 읽기는 스트립의 그려진 경계를 MediaBox와 비교해 어느 변이라도 GeometryTolerancePoints, 기본값 0.5포인트 이상 어긋나면 pvriStripGeometryInvalid를 보고합니다. 이미지를 페이지의 98%로 스케일해 흰 여백을 남기는 스캐너 드라이버는 화면에는 멀쩡해 보여도 여기서 실패합니다. RequireFullPageStrip을 False로 두면 여백이 허용되는 내부 파일을 위해 커버리지 점검을 끌 수 있습니다
어떤 이미지 인코딩이 허용되는가
검증기는 네 가지 스트립 필터를 받습니다. /CCITTFaxDecode, /DCTDecode, /JPXDecode, /FlateDecode입니다. 바이트 읽기는 다른 표준 필터를 이름으로 pvriForbiddenImageFilter로 표시합니다. /LZWDecode, /RunLengthDecode, /ASCII85Decode, /ASCIIHexDecode, /JBIG2Decode, /Crypt입니다
JBIG2는 캡처 팀이 처음 맞닥뜨리는 거부입니다. PDF/A에서는 허용되고 2레벨 페이지를 아주 잘 압축하므로, PDF/A를 위해 만든 캡처 프로필이 이미 그것을 내보내고 있을 수 있습니다. 그 손실 패턴 매칭 모드는 스캔된 글리프를 닮은 글리프로 바꿔치기하는 것으로도 알려져 있는데, 스캔 양식의 숫자에 대한 문서화된 문제이며, 래스터 아카이브가 존재하는 이유 자체가 종이에 있던 것이 파일 안에 있도록 하기 위함입니다. 그 페이지들을 CCITT Group 4로 재인코딩하면 2레벨과 무손실이 유지됩니다
페이지 읽기는 한 단계 더 나아가 필터 체인을 이미지의 비트 깊이와 색공간과 함께 보고, 어긋남을 pvriImageCompressionParametersInvalid로 보고합니다:
- 필터가 둘 이상인 체인은 거부되므로 ASCII85로 감싼 Flate 이미지는 두 번 실패합니다. 바이트 쪽에서 한 번, 여기서 한 번
/CCITTFaxDecode는 1비트 DeviceGray 스트립 위에 놓여야 합니다/DCTDecode는 DeviceGray나 DeviceRGB의 8비트 또는 24비트 스트립 위에 놓여야 합니다/FlateDecode는 1비트 스트립에서 받아들여집니다. 24비트 Flate 페이지는 이 점검에 실패합니다/JPXDecode는 픽셀당 1, 8, 24비트에서 받아들여집니다
필터와 무관하게 색공간이 DeviceGray도 DeviceRGB도 아닌 스트립은 pvriImageColorInvalid를 받습니다. 따라서 ICC 기반이나 CMYK 스캔은 감싸기 전에 변환되어야 하는데, 그 일을 할 가장 싼 장소는 PDF가 하나도 쓰이기 전의 스캐너 프로필입니다
스트립 해상도는 어떻게 계산되는가
이미지가 자체 해상도를 실고 있으면 페이지 읽기가 그것을 씁니다. 없으면 유효 해상도를 픽셀과 페이지 크기에서 유도합니다. 픽셀 폭 곱하기 72 나누기 포인트 단위 MediaBox 폭이고, 높이도 같습니다. 스캐너가 2550x3300픽셀 스트립을 612x792포인트의 US Letter 페이지에 기록한다고 치면 양방향 모두 정확히 300dpi입니다. 같은 페이지가 600x776픽셀이면 가로로 약 70.6dpi가 되는데, 이는 기본 최솟값 72 아래이므로 그 페이지는 pvriImageResolutionInvalid를 받습니다
TPdfRValidationOptions의 기본 범위는 72부터 2400dpi입니다. 그 경계는 명백히 깨진 페이지만 잡습니다. 캡처 계약은 보통 특정 최솟값, 흔히 200이나 300dpi를 약속하며, 그 값이 MinimumResolutionDpi에 들어가야 합니다. 150dpi 페이지는 기본 범위를 통과하지만 그것이 바로 계약이 배제하려고 쓰인 페이지입니다. 어느 경계든 0으로 두면 그쪽 점검이 꺼집니다
ValidatePdfRPageFacts는 공개되어 있으므로 같은 규칙을 PDF가 존재하기 전에, 스캐너가 각 이미지에 대해 보고하는 것에서 바로 돌릴 수 있습니다:
uses
  FPdfPdfr;

// 스캐너 출력에서 페이지 팩트를 만듭니다; 이 헬퍼는 여러분 몫이지 라이브러리 일부가 아닙니다
function ScannerStripFacts(PixelW, PixelH: Integer;
  PageWidthPt, PageHeightPt: Single; const Filter: string;
  BitsPerPixel: LongWord; ColorSpace: Integer): TPdfRPageFacts;
begin
  Result := Default(TPdfRPageFacts);
  Result.PageNumber := 1;
  Result.MediaWidth := PageWidthPt;
  Result.MediaHeight := PageHeightPt;
  Result.ImageCount := 1;
  Result.ImageRight := PageWidthPt;   // 스트립이 페이지 전체를 덮습니다
  Result.ImageTop := PageHeightPt;
  Result.PixelWidth := PixelW;        // HorizontalDpi는 0으로 둠: 유도됨
  Result.PixelHeight := PixelH;
  Result.BitsPerPixel := BitsPerPixel;
  Result.ColorSpace := ColorSpace;    // 1 = DeviceGray, 2 = DeviceRGB
  SetLength(Result.Filters, 1);
  Result.Filters[0] := Filter;
end;

var
  Opts: TPdfRValidationOptions;
  Issues: TPdfRValidationIssues;
begin
  Opts := TPdfRValidationOptions.Default;
  Opts.MinimumResolutionDpi := 300;

  // Letter의 300 dpi 컬러 JPEG: 빈 집합
  Issues := ValidatePdfRPageFacts(
    ScannerStripFacts(2550, 3300, 612, 792, 'DCTDecode', 24, 2), Opts);

  // 같은 페이지를 24비트 Flate로 압축하면:
  // [pvriImageCompressionParametersInvalid]
  Issues := ValidatePdfRPageFacts(
    ScannerStripFacts(2550, 3300, 612, 792, 'FlateDecode', 24, 2), Opts);
end;
카탈로그, Info 딕셔너리와 XMP
필수인 /Type과 /Pages 외에 ISO 23504-1은 카탈로그에서 Version, ViewerPreferences, PageLayout, PageMode, AcroForm, Metadata만 허용합니다. 검증기는 카탈로그를 그 집합 밖의 21개 표준 키와 대조해 하나라도 나타나면 pvriProhibitedCatalogEntry를 일으키는데, 그중에는 Outlines, Names, PageLabels, OpenAction, StructTreeRoot, MarkInfo, Lang, OCProperties, OutputIntents가 있습니다. 마지막 것이 실무에서 중요합니다. PDF/A 파일은 언제나 출력 의도를 실으므로, 하나의 파일로 두 프로필을 동시에 만족시킬 수 없습니다
Info 딕셔너리는 Creator, Producer, CreationDate, ModDate를 담을 수 있고, Title, Author, Subject, Keywords, Trapped는 pvriProhibitedInfoEntry를 일으킵니다. /Metadata 스트림이 없는 카탈로그는 pvriMissingXmpMetadata를 받습니다. 스트림은 있지만 그 XMP에 xmp:CreateDate, xmp:ModifyDate, xmp:MetadataDate 중 하나라도 없으면 대신 pvriMetadataInvalid입니다. pvriInfoXmpMismatch는 Producer를 pdf:Producer와, Creator를 xmp:CreatorTool과 비교합니다. 날짜는 두 인코딩이 정당하게 다를 수 있어 비교에서 빠지고, 16진 문자열로 저장된 Info 값은 건너뛰어집니다. 전형적인 유발 사례는 XMP를 건드리지 않은 채 Info의 Producer만 다시 쓴 나중 도구입니다
남은 컨테이너 규칙은 짧습니다. 헤더는 %PDF-1.4부터 %PDF-1.7 또는 %PDF-2.0이어야 하고(pvriBadHeader), /Type /ObjStm 스트림은 pvriObjStmPresent를 일으키며, 암호화된 파일은 %PDF-2.0 헤더를 써야 합니다(pvriEncryptVersionMismatch). RequireEncryptedPdf20Profile을 켜 둔 상태에서는 암호화 딕셔너리가 /R 5 이상과 함께 /V 5나 6을 선언해야 하고, 그러지 않으면 파일이 pvriEncryptedPdf20ProfileInvalid를 받습니다
마커 쓰기
TPdfRSaveOptions는 Creator, Producer, CreationDate, ModDate, DocumentId, InstanceId를 실으며 Title, Author, Subject, Keywords를 위한 필드는 없습니다. 프로필이 그것들을 금지하기 때문입니다. StripInfoOptionalEntries와 StripCatalogOptionalEntries는 모두 기본값이 True로 소스에서 배제된 항목을 제거하고, 어느 쪽이든 False로 두면 항목이 남아 적합성을 치릅니다. TPdf.SaveAsPdfR는 빈 옵션 필드를 로드된 문서 자체의 메타데이터와 파일 식별자로 채우고, 보안을 제거한 뒤, 마커와 다듬어진 딕셔너리, XMP 패킷, 트레일러 /ID를 기록합니다
uses
  System.Classes, System.SysUtils, PDFium, FPdfPdfr;

procedure WrapScanAsPdfR(const InFile, OutFile: string; Log: TStrings);
var
  Pdf: TPdf;
  Opts: TPdfRSaveOptions;
  Written: TFileStream;
  Res: TPdfRValidationResult;
begin
  Pdf := TPdf.Create(nil);
  try
    Pdf.FileName := InFile;
    Pdf.Active := True;
    Opts := TPdfRSaveOptions.Default;
    Opts.Creator := 'Capture Station 4';   // Producer, 날짜와 ID는 소스에서 옵니다
    if not Pdf.SaveAsPdfR(OutFile, Opts) then
      raise Exception.Create('PDF/R save failed: ' + InFile);
  finally
    Pdf.Free;
  end;

  // 메모리상 문서가 아니라 실제 기록된 바이트를 확인합니다
  Written := TFileStream.Create(OutFile, fmOpenRead or fmShareDenyWrite);
  try
    Res := ValidatePdfRCompliance(Written);
    if pvriPageImageMismatch in Res.Issues then
      Log.Add('A source page still has no single strip image');
    if pvriFontForbidden in Res.Issues then
      Log.Add('The source carries fonts; rescan or drop the text layer');
  finally
    Written.Free;
  end;
end;
래핑이 바꾸는 것은 메타데이터와 식별뿐입니다. 벡터 텍스트를 그리거나 스트립 이미지가 없는 소스 페이지는 SaveAsPdfR에서 같은 페이지 콘텐츠로 나오고 같은 페이지 점검에서 실패합니다. 페이지 콘텐츠를 그대로 두는 것은 의도된 동작입니다. 스캔을 조용히 다시 렌더링하는 것은 아카이브가 보존하려던 바로 그 픽셀을 바꾸는 일이니까요. 첫 목록의 CheckDeliveredScan을 OutFile에 돌리면 페이지 읽기를 포함한 전체 판정이 나옵니다
캡처 파이프라인에서 PDF/R이 들어맞는 곳
PDF/R은 스캔 자체가 기록이고 충실도가 전부인 계약인 인도물에 어울립니다. 증거 이미징, 수표와 송금 캡처, 대형 포맷 스캐너의 도면 아카이브가 그것입니다. 문서에 검색 가능한 텍스트, 태깅, 첨부, 책갈피가 필요해지는 순간 그 문서의 자리는 PDF/A입니다. 그 기능 하나하나가 위의 배제 목록에 떨어지기 때문입니다
많은 팀이 둘 다 유지합니다. PDF/R 원본은 한 번 기록되고 결코 변하지 않으며, OCR 레이어를 실은 PDF/A 파생물이 검색을 맡습니다. 두 검증기는 독립적이므로 하나의 배치 작업이 각 파일을 그것이 주장하는 프로필에 대해 점검할 수 있습니다. 아카이브 쪽은 PDF/A 보존 규정 준수와 PDF/A 프리플라이트 검증에서, 인쇄 출력은 인쇄용 PDF/X 문서 검증에서 다룹니다
여기서 보인 PDF/R 점검은 Delphi, C++Builder, Lazarus용 PDFium Component의 Small Business와 Enterprise 에디션에 들어 있으며, PDF/A, PDF/X, PDF/E, PDF/UA 검증기와 나란히 제공됩니다. 에디션과 지원 IDE 버전은 PDFium Component 제품 페이지에 있습니다