FDF를 폼으로 가져오면 필드 값이 미묘하게 틀려 돌아옵니다. 불릿이 칼표로, 줄임표가 em 대시로 도착합니다. PDFium 컴포넌트는 그 증상 계열 전체를 PDFDocEncoding 표의 단일 행으로 추적했습니다. ISO 32000-1 부속서 D.2의 특수 문자 블록은 $7F가 아니라 $80에서 시작합니다
FDF 가져오기가 왜 이웃 문자를 반환하는가
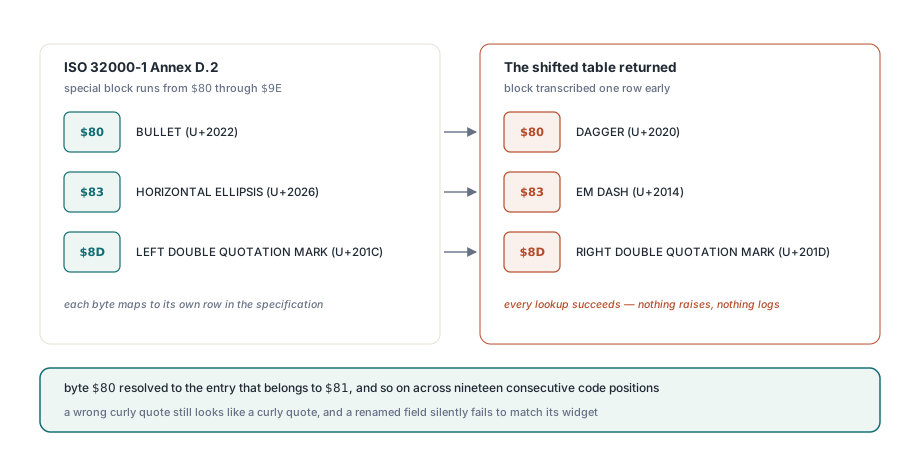
한 위치 밀린 인코딩 표도 여전히 완벽하게 유효해 보이는 표이고, 그 안의 모든 조회가 성공하기 때문입니다. 부속서 D.2가 $80부터 $9E까지에 할당한 블록이 한 행 일찍 전사되어, 바이트 $80이 $81에 속한 항목으로, 바이트 $81이 $82의 항목으로 풀렸고, 그렇게 열아홉 개의 연속 코드 위치에 걸쳐 이어졌습니다. 예외도 없고, 로그도 없고, 필드가 거부된 적도 없었습니다. TPdf.ImportFDF는 항상 그래 왔던 것과 같은 필드 수를 보고했습니다
피해는 균일하고 조용했습니다. 부속서 D.2가 BULLET (U+2022)으로 정의하는 $80을 실은 바이트는 DAGGER (U+2020)로 돌아왔습니다. 바이트 $83, HORIZONTAL ELLIPSIS (U+2026)는 EM DASH (U+2014)로 돌아왔습니다. 바이트 $8D, LEFT DOUBLE QUOTATION MARK (U+201C)는 RIGHT DOUBLE QUOTATION MARK (U+201D)로 돌아왔습니다. 아무도 눈치채지 못하는 경우입니다. 잘못된 곱슬 인용 부호도 폼 필드에서는 여전히 곱슬 인용 부호처럼 보이기 때문입니다. 필드 이름도 필드 값과 같은 운명을 겪었는데, 그것은 더 나쁩니다. 문서의 위젯과 더 이상 일치하지 않는 이름은 조용히 적용에 실패합니다
PDF 텍스트 문자열은 두 가지 서로 다른 인코딩을 지닙니다
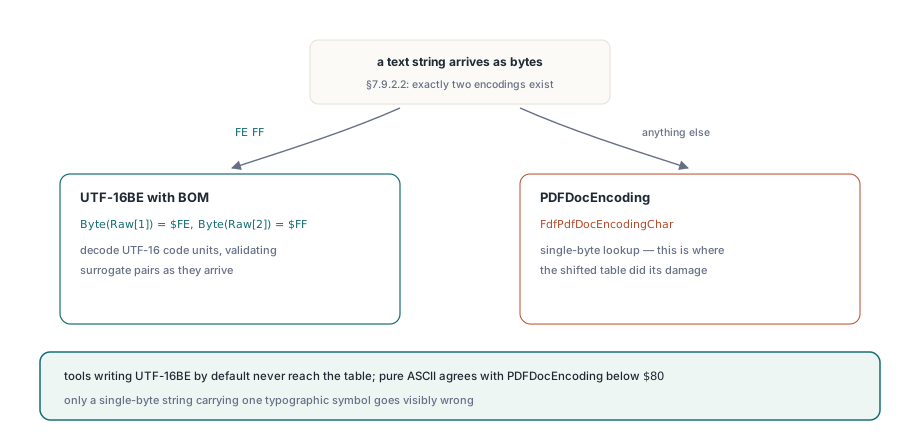
ISO 32000-1 §7.9.2.2는 텍스트 문자열 타입을 정확히 두 인코딩 중 하나로 정의하며, 사전 항목이 아니라 처음 두 바이트를 검사해 선택합니다. 바이트 순서 표시 FE FF로 시작하는 문자열은 UTF-16BE이고, 그 외의 모든 것은 PDFDocEncoding입니다. 그 하나의 분기가 완전히 다른 두 디코더 중 무엇이 실행될지 결정하며, PDFium 컴포넌트는 문자 하나를 건드리기 전에 FDF 파서 안에서 그것을 적용합니다
// FDF 텍스트 문자열: BOM이 있으면 UTF-16, 그렇지 않으면 PDFDocEncoding
if (Length(Raw) >= 2) and
   (((Byte(Raw[1]) = $FE) and (Byte(Raw[2]) = $FF)) or
    ((Byte(Raw[1]) = $FF) and (Byte(Raw[2]) = $FE))) then
begin
  BigEndian := Byte(Raw[1]) = $FE;
  // ... UTF-16 코드 유닛을 디코딩하며 서러게이트 쌍을 검증합니다
end
else
begin
  SetLength(Result, Length(Raw));
  for I := 1 to Length(Raw) do
    Result[I] := FdfPdfDocEncodingChar(Byte(Raw[I]));
end;
이것이 버그가 평범한 테스트에서 그렇게 오래 숨어 있었던 이유입니다. 기본으로 UTF-16BE를 쓰는 도구가 만든 FDF는 FdfPdfDocEncodingChar에 아예 도달하지 않으므로, 밀린 표는 잠들어 있습니다. 단일 바이트 문자열만 — 많은 FDF 생성기가 평범한 라틴 필드 이름에 대해 더 짧으므로 방출하는 바로 그것 — 표가 중요한 분기를 타고 내려갑니다. 순수 ASCII 필드 이름은 어차피 올바르게 디코딩됩니다. $80 아래에서는 PDFDocEncoding과 ASCII가 일치하기 때문입니다. 타이포그래피 기호 하나를 담은 단일 바이트 문자열이 있어야 뭔가가 눈에 보이게 잘못됩니다
고쳐진 표, 그리고 그것을 고정하는 두 앵커
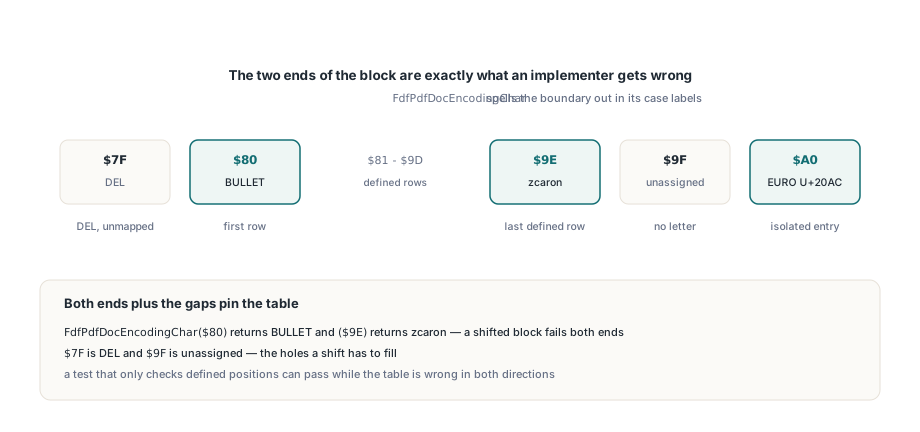
PDFium 컴포넌트는 이제 블록의 양끝이 바로 구현자가 틀리는 지점이기 때문에 FdfPdfDocEncodingChar 자체에 경계를 명시합니다. $7F는 DEL이고 PDFDocEncoding 의미가 전혀 없으며, 블록은 $80의 BULLET에서 열려 $9E의 zcaron까지 이어지고, $9F는 미할당이며, 유로 기호는 $A0에 홀로 있습니다
function FdfPdfDocEncodingChar(Value: Byte): WideChar;
begin
  case Value of
    // ISO 32000-1 부속서 D.2. 블록은 $7F가 아니라 $80에서 시작합니다: $7F는 DEL이고
    // PDFDocEncoding 의미가 없으며, 유로는 $A0에 있는데 기본 분기가
    // 그렇지 않으면 no-break space로 돌려줄 것입니다
    $7F: Result := WideChar($FFFD);
    $80: Result := WideChar($2022);   // BULLET, 블록의 첫 행
    $81: Result := WideChar($2020);   // DAGGER
    // ... $82부터 $9D까지
    $9E: Result := WideChar($017E);   // zcaron, 마지막 정의 행
    $9F: Result := WideChar($FFFD);   // 부속서 D.2에서 미할당
    $A0: Result := WideChar($20AC);   // EURO SIGN
  else
    Result := WideChar(Value);
  end;
end;
그 밀림이 그 두 끝에 한 일을 보세요. 오프바이원이 더 이상 외관상 문제가 아닌 곳이 바로 거기입니다. zcaron은 스펙에서 $9E에 있었지만 밀린 표에서는 $9D에 있었으므로, 문서 바이트 $9E는 누군가 전사한 마지막 행을 넘어 곧장 정체성 폴백으로 떨어져 문자 대신 C1 제어 문자를 반환했습니다. 그리고 유로인 $A0은 처음부터 표에 쓰인 적이 없었습니다. 정체성 분기가 그것을 U+00A0 NO-BREAK SPACE로 돌려줬고, 이 문자는 이후의 모든 검증을 살아남고, 아무것도 출력하지 않으며, 찾고 있는 필드 이름과 결코 일치하지 않습니다
전사한 인코딩 표를 테스트하는 방법
첫 행, 마지막 행, 갭을 테스트하세요. 중간에서 샘플을 뽑지 말고요. 이것은 수정에서 스펙에서 복사해 온 다른 어떤 표에도 가져갈 가치가 있는 부분입니다. 블록 중간의 스팟 체크는 블록 전체 이동이 정확히 살아남는 테스트이기 때문입니다. $8D가 왼쪽 큰따옴표를 준다는 검증은 $8C도 그럴듯한 무언가를 줄 때 아무것도 증명하지 않습니다. $80이 BULLET을 주고 $9E가 zcaron을 준다는 검증은 양끝을 고정하며, 밀린 블록은 둘을 동시에 만족할 수 없습니다
procedure CheckPdfDocEncodingAnchors;
begin
  // 부속서 D.2 특수 블록의 양끝: 블록 전체 이동이 이것들을 깨뜨립니다
  Assert(FdfPdfDocEncodingChar($80) = WideChar($2022), 'first row: BULLET');
  Assert(FdfPdfDocEncodingChar($9E) = WideChar($017E), 'last row: zcaron');
  // 스펙이 정의하지 않은 코드 위치는 문자로 디코딩되면 안 됩니다
  Assert(FdfPdfDocEncodingChar($7F) = WideChar($FFFD), '$7F is DEL, unmapped');
  Assert(FdfPdfDocEncodingChar($9F) = WideChar($FFFD), '$9F is unassigned');
  // 블록 위의 고립 항목, 통째로 빠뜨리기 쉽습니다
  Assert(FdfPdfDocEncodingChar($A0) = WideChar($20AC), 'EURO SIGN');
end;
정의되지 않은 위치는 재미없다고 건너뛰는 대신 그 자체의 어서트를 받을 자격이 있습니다. 오프바이원은 무언가를 어딘가에 놓아야 하고, 그것이 놓이는 곳은 거의 항상 스펙이 비워 둔 코드 위치입니다. 앞쪽의 $7F, 뒤쪽의 $9F입니다. 정의된 위치만 검사하는 테스트는 표가 양방향으로 잘못돼도 통과할 수 있고, 구멍을 고정하는 테스트는 첫 실행에서 밀림을 잡습니다
왕복 폼 워크플로에서 이것의 대가
기호당 한 문자를 조용히 다시 쓰는 FDF 가져오기는 실패하는 것보다 더 나쁩니다. 실패는 하류에서 표면화되고 다른 무언가처럼 보이기 때문입니다. 필드 이름이 여기서 날카로운 모서리입니다. TPdf.ImportFDF는 들어오는 이름을 열린 문서의 위젯과 대조하며, 한 문자를 잘못 디코딩한 이름은 그냥 일치하지 않습니다. 필드는 비어 있고, 반환 값은 여전히 그 필드를 파싱된 것으로 세며, 파이프라인에서 나오는 보고서는 왜인지 설명하는 로그도 없이 값 하나가 모자랍니다. PDFium 컴포넌트로 XFDF 폼 데이터와 주석 내보내기 및 가져오기에 설명된 종류의 내보내기-재가져오기 루프를 만드는 사람이라면, 루프를 신뢰하기 전에 평범한 ASCII뿐 아니라 타이포그래피 기호를 담은 필드 이름을 왕복시켜 보아야 합니다
수정의 한계에 대해 정직해질 가치도 있습니다. 표는 이제 256개 바이트 값 모두에 대해 부속서 D.2와 일치하므로 단일 바이트 FDF 문자열은 올바르게 디코딩되지만, PDFDocEncoding 자체는 라틴 레퍼토리만을 커버하고 그 이상은 없습니다. 그것 밖의 모든 것은 BOM이 있는 UTF-16BE로 도착해야 하며, 그것이 바로 §7.9.2.2가 의도하는 바입니다. 그리고 UTF-16 문자열도 Delphi 쪽에서 별도의 위험을 지닙니다. U+FFFF 너머의 코드 포인트는 하나의 WideChar가 아니라 서러게이트 쌍이 필요하며, Delphi에서 이모지와 CJK 문자가 WideChar를 깨뜨리는 이유에서 다루는 문제입니다. 더 넓은 요점은 인코딩 표를 넘어 일반화됩니다. PDF 파서는 받아들여야 할 것을 거부할 수 있고, 그것은 즉시 발견되며, 받아들이고 조용히 틀릴 수도 있고, 그것은 프로덕션에서 발견됩니다. PDF 사전 안전하게 파싱하기에 설명된 이름 토큰 함정은 두 번째 범주에 있고, 한 행 밀린 표도 마찬가지입니다. 코드 경로는 성공하고, 반환 값은 그럴듯해 보이며, 구현이 아니라 스펙을 상대로 쓰인 테스트만이 그 반대를 말합니다
TPdf의 ImportFDF, ExportFDF, ImportXFDF와 그 뒤의 FDF 및 XFDF 파서는 Delphi와 C++Builder용 표준 PDFium Component의 일부입니다