/ModDate (D:20260827093659+08'00')를 담은 Info 딕셔너리와 2026-08-27T01:36:59Z로 된 xmp:ModifyDate를 담은 XMP 패킷은 같은 초를 기술하며, PDF/A 검증기가 그 쌍을 받아들일 만한 이유는 충분하다. 그런데 문서의 Subject 문자열을 dc:subject로 복사하면 글자 하나까지 일치해도 패킷은 실패한다. ISO 19005-1 §6.7.3은 동등한 값을 특정 XMP 속성에, 특정 RDF 모양으로 담기를 요구한다
이 주제를 여는 버그 리포트는 대체로 무해해 보인다. 문서 관리 시스템이 증분 저장마다 Info 딕셔너리에 새 /ModDate를 찍고 XMP 패킷은 그대로 둔다. 몇 달 뒤 아카이브 감사가 수천 개 파일을 지목한다. 두 날짜 모두 자리에 있다. 첫 수정에서 의견이 갈렸을 뿐이고, 속성의 존재만 확인하는 점검은 그것을 못 봤다. Info 전용 API로 한 제목 편집도 같은 식으로 실패하고, 어떤 도구가 두 개의 dc:creator 항목으로 갈라 놓은 Finance; Controlling 같은 Author 문자열도 그렇다
ISO 19005-1이 Info와 XMP에 요구하는 것
ISO 19005-1의 Table 1은 여덟 Info 키를 XMP 속성과 짝 짓고, §6.7.3은 Info 키가 존재하는 이상 매핑된 XMP 속성이 동등한 값을 실어야 한다고 말한다. 없는 키는 아무것도 요구하지 않는다. PDF/A-2와 PDF/A-3은 같은 여덟 키에 같은 동등성 요구를 유지한다. PDF/A-4는 반대로 가서 Info 딕셔너리 자체를 제한한다. 카탈로그의 /PieceInfo와 나란히 있을 때만 나타날 수 있고 그때도 ModDate 외에는 아무것도 담을 수 없다. TPdf.ValidatePdfA는 이를 pvaiPdfA4InfoWithoutPieceInfo와 pvaiPdfA4InfoInvalid로 보고한다
PDFium Component에서 이 비교는 FPdfPdfa.pas의 ComparePdfAInfoAndXmp에 산다. 모든 속성을 네임스페이스 URI로 찾으므로, http://purl.org/dc/elements/1.1/을 별난 접두사에 묶은 패킷도 dc를 쓰는 패킷과 똑같이 읽힌다. 매핑된 모양은 다음과 같다:
- Title →
dc:title과 Subject →dc:description:rdf:Alt언어 대안.x-default항목만과 비교하며 언어 태그는 대소문자 구 없이 맞춰 보고,x-default가 없는 Alt는 없는 것으로 친다 - Author →
dc:creator: Info 문자열 전체를 담은 텍스트 항목 정확히 하나를 가진rdf:Seq. 세미콜론으로 갈라진 저자 목록도 단일 항목으로 남는다 - Keywords →
pdf:Keywords, Producer →pdf:Producer(네임스페이스http://ns.adobe.com/pdf/1.3/): 단순 텍스트 속성 - Creator →
xmp:CreatorTool, CreationDate →xmp:CreateDate, ModDate →xmp:ModifyDate(네임스페이스http://ns.adobe.com/xap/1.0/): 단순 텍스트 속성
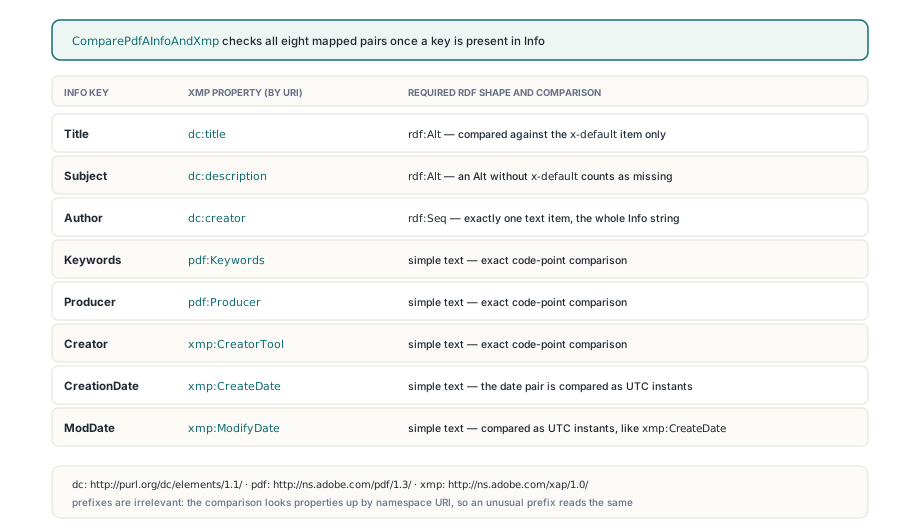
Subject 행은 손수 만든 템플릿이 가장 자주 틀리는 자리다. Dublin Core의 dc:subject는 순서 없는 키워드 가방이고, 이름이 사람을 부춙겨 Info Subject를 거기에 떨어뜨린다. 비교는 dc:description을 찾고, 아무것도 없으면 "올바른" 텍스트가 한 속성 옆에 앉아 있는 동안 Subject를 pamsXmpMissing으로 보고한다. 올바른 모양 세 줄은 이렇게 생겼다:
<dc:title><rdf:Alt><rdf:li xml:lang="x-default">Quarterly Report 2026</rdf:li></rdf:Alt></dc:title>
<dc:creator><rdf:Seq><rdf:li>Finance; Controlling</rdf:li></rdf:Seq></dc:creator>
<pdf:Producer>PDFium Component</pdf:Producer>
올바른 문자열이 여전히 비교에 실패하는 이유
올바른 문자열은 잘못된 컨테이너에 들어 있거나 코드포인트 하나만 달라도 실패한다. 텍스트 값은 정확한 유니코드 코드포인트 시퀀스로 비교된다. 잘라내기도, 대소문자 접기도, 정규화도 없이. 뒤따르는 공백 하나가 어긋남이다. 한쪽은 미리 합쳐진 é, 다른 쪽은 e에 조합 악센트를 얹은 것도 어긋난다. 화면에서는 보통 똑같이 렌더링되는데도
모양 오류에는 자기 상태가 있다. 평문 텍스트로 쓰인 dc:title, rdf:Bag으로 선언된 dc:creator, 항목 둘을 가진 dc:creator Seq는 모두 pamsValueMismatch가 아니라 pamsXmpTypeMismatch를 내놓는다. 보고서가 "도구가 RDF 구조를 잘못 골랐다"와 "도구가 다른 텍스트를 썼다"를 구분할 수 있다는 뜻이다. 두 문제는 파이프라인의 다른 지점에서 나오는 게 보통이고, 엉뚱한 쪽을 고치면 오후 하나가 날아간다
Info 쪽은 늘 PDFium 자신의 PDFDocEncoding과 UTF-16BE 문자열 디코딩, FPDF_GetMetaText 경로에서 나오며 TPdf.GetMetadata가 쓰는 바로 그 길이다. 바이트 순서 표식이나 이스케이프된 8진수 시퀀스를 가진 문자열도 엔진이 읽는 방식 그대로 읽힌다. XMP 쪽은 그것을 만든 바이트만큼만 깨끗하다. 잘못된 코드 페이지로 조립한 패킷은 어떤 비교도 용서하지 않을 깨진 문자를 싣고 있을 수 있다. 그래서 Free Pascal 아래에서 XMP 메타데이터를 망치는 코드 페이지 함정이 같은 체크리스트에 올라 있다
PDF 날짜와 XMP 날짜는 언제 같은가
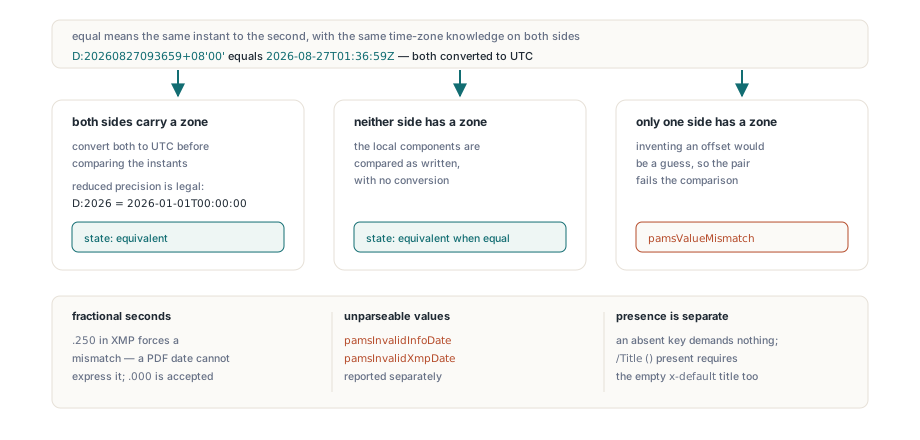
PDF 날짜와 XMP 날짜는 초 단위까지 같은 시각을 기술하고 양쪽의 시간대 지식이 같을 때 같다. 두 파서 모두 합법적인 축약 정밀도를 받으므로 D:2026과 2026은 둘 다 2026년 1월 1일 자정을 뜻한다. 양쪽 값이 모두 시간대를 실으면 각각 먼저 UTC로 변환된다. D:20260827093659+08'00'은 2026-08-27T01:36:59Z와 같다. 어느 쪽도 시간대가 없으면 지역 구성요소들이 쓰인 그대로 비교된다
한쪽에만 시간대가 있으면 결과는 pamsValueMismatch다. 시간대 없는 값에 오프셋을 지어 내는 것은 추측이고, 우연히 서버 시간대와 맞아떨어진 추측은 한 기계에서는 통과하고 다른 기계에서는 실패한다. XMP의 .250 같은 0이 아닌 소수 초도 어긋남을 강제한다. PDF 날짜에는 그것을 표현할 방법이 없기 때문이다. .000은 받아들여진다. 아예 파싱되지 않는 값은 pamsInvalidInfoDate나 pamsInvalidXmpDate로 보고된다
두 날짜 문법은 호환되지 않으며 파서들은 각자 자기 쪽을 고수한다. PDF 쪽에서는 오프셋 분을 둘러싼 작은따옴표가 선택 사항이고 Z가 받아들여진다. XMP 쪽 오프셋에는 콜론이 필요하다. 2026-08-27T09:36:59+08:00은 파싱되지만 +0800은 pamsInvalidXmpDate다. XMP 시간은 T가 나타나는 순간부터 최소한 시와 분을 필요로 하고, 14시간을 넘는 오프셋은 양쪽에서 거부된다. 날짜 파싱 전에는 주위 공백이 잘려 나오는데, 텍스트 필드에는 주어지지 않는 배려다
존재에는 자체 규칙이 있다. TPdfAMetadataValues.Present는 활성 trailer의 /Info 딕셔너리를 훑어 채워지는 집합이며, "키 없음"을 "키가 있지만 빈 문자열"과 갈라 놓는다. 없는 키는 pamsNotRequired를 낸다. /Title ()은 존재하는 것이므로 패킷도 빈 x-default 제목을 실어야 한다
파일을 만지기 전에 필드별 리포트 읽기
TPdf.InspectPdfAMetadata는 필드마다 TPdfAMetadataComparison 하나씩을 지닌 TPdfAMetadataReport를 돌려준다. 항목마다 Info 값, XMP 값, TPdfAMetadataState가 들어 있으므로 실패를 필드별로 설명할 수 있다. MismatchFields는 실패 집합을 모으고, HasXmpPacket은 패킷이 발견됐는지를 말하며, XmpParseError는 패킷이 있지만 읽을 수 없을 때 파서 메시지를 싣는다. 그 마지막 경우에는 패킷에서 아무것도 읽지 못했으므로 존재하는 모든 필드가 pamsXmpMissing을 보고한다
uses
  System.SysUtils, PDFium, FPdfPdfa;

const
  FieldNames: array[TPdfAMetadataField] of string = (
    'Title', 'Author', 'Subject', 'Keywords',
    'Creator', 'Producer', 'CreationDate', 'ModDate');
  StateNames: array[TPdfAMetadataState] of string = (
    'not required', 'equivalent', 'XMP missing', 'XMP type mismatch',
    'value mismatch', 'invalid Info date', 'invalid XMP date');

procedure ReportMetadata(Pdf: TPdf);
var
  Report: TPdfAMetadataReport;
  Item: TPdfAMetadataComparison;
begin
  Report := Pdf.InspectPdfAMetadata;
  if Report.XmpParseError <> '' then
    Writeln('XMP packet unreadable: ', Report.XmpParseError)
  else if not Report.HasXmpPacket then
    Writeln('No XMP packet at all');
  for Item in Report.Comparisons do
    if not Item.IsEquivalent then
      Writeln(Format('%-12s %-18s Info="%s" XMP="%s"',
        [FieldNames[Item.Field], StateNames[Item.State],
         Item.InfoValue, Item.XmpValue]));
end;TPdf.ValidatePdfA는 같은 비교를 자기 이슈 집합에 흡수한다. PDFium Component로 PDF/A 프리플라이트 검증하기에서 다룬 바이트 수준 스캔은 패킷에 두 날짜 속성이 모두 없을 때 pvaiMissingXmpDates를, Info가 CreationDate나 ModDate를 싣고 있지만 패킷에 맞는 날짜 속성이 없을 때 pvaiInfoXmpDateMismatch를 보고한다. 거기에 더해 ValidatePdfA는 전체 값 비교를 돌리고, 패킷이 존재하지만 Info와 어긋날 때마다 — 읽을 수 없는 패킷 포함 — pvaiInfoXmpValueMismatch를 더한다. 패킷이 아예 없는 문서는 pvaiMissingXmpMetadata 하나로만 보고되므로, 하나의 결함이 두 번 나타나는 일은 없다. 스트림 수준의 ValidatePdfACompliance 함수는 바이트 수준 스캔만 돌린다
function MetadataGateOk(Pdf: TPdf): Boolean;
var
  Res: TPdfAValidationResult;
begin
  Res := Pdf.ValidatePdfA;
  if pvaiMissingXmpMetadata in Res.Issues then
    Writeln('No usable XMP packet: rebuild the file with SaveAsPdfA');
  if pvaiInfoXmpDateMismatch in Res.Issues then
    Writeln('Info has a date property the XMP packet lacks entirely');
  if pvaiInfoXmpValueMismatch in Res.Issues then
    Writeln('Mapped values disagree: run InspectPdfAMetadata for details');
  Result := Res.IsCompliant;
end;
NormalizePdfAMetadata가 다시 쓰는 것과 멈추는 곳
TPdf.NormalizePdfAMetadata는 Info 딕셔너리를 진실의 원천으로 취급하고 MismatchFields에 들어간 필드의 XMP 속성만 다시 쓴다. Title과 Subject는 x-default 항목으로 들어 가고 다른 언어 대안은 온전히 남는다. Author는 항목 하나짜리 rdf:Seq가 된다. 시간대 있는 Info 날짜는 Z 접미사를 단 정규 UTC XMP 날짜로 쓰이고, 시간대 없는 날짜는 지역 구성요소를 유지한다. 알 수 없는 네임스페이스, 무관한 속성, 없는 Info 키를 위한 XMP 속성은 건드리지 않고, 속성을 되돌려 쓸 때 기존 접두사 바인딩을 재사용한다
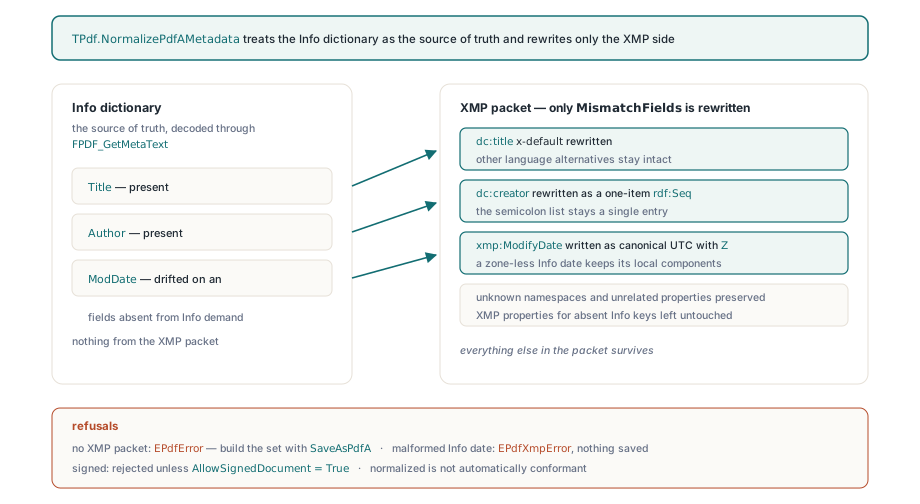
Info를 권위로 삼는 데는 실전 파일에서 드러나는 비용이 있다. "Finance"와 "Controlling"을 두 사람으로 나열하던 dc:creator Seq는 Finance; Controlling을 읽는 항목 하나로 교체되고, 잘못된 컨테이너에 저장됐던 dc:title은 x-default만 담은 새 Alt로 다시 만들어진다. 옛 컨테이너가 담았던 것은 사라진다. 여기서는 그 손실이 받아들여진다. Table 1은 정확히 하나의 creator 항목만 허용하고, Info 문자열은 이미 전체 목록을 한 덩어리로 담고 있으며, 더 풍부한 목록이 필요하면 원본 패킷이 소스 파일에 아직 있다
거절은 의도적이다. XMP 패킷이 없으면 메서드는 EPdfError를 던진다. 완전한 PDF/A 식별과 메타데이터 집합을 만드는 일은 PDFium Component로 PDF/A 아카이브 파일 만들기에서 다루는 SaveAsPdfA의 몫이다. 읽을 수 없는 패킷이나 잘못된 Info 날짜는 무엇이 쓰이기 전에 EPdfXmpError를 던진다. 그럴듯해 보이는 잘못된 날짜가 XMP에 들어 가는 것은 출력이 없는 것보다 나쁘다. 서명된 문서는 호출자가 AllowSignedDocument = True를 넘기지 않으면 EPdfError를 던진다. 출력은 새 메타데이터를 증분 업데이트로 덧붙인 완전한 저장이므로 서명된 바이트가 그대로 운반되지는 않는다
그 저장 경로에는 결과가 하나 더 있다. NormalizePdfAMetadata는 모든 필드가 이미 일치해도 새 파일을 쓴다. 아무것도 동기화하지 않아도 끝은 저장이기 때문이다. 먼저 InspectPdfAMetadata를 돌리고 일치하는 파일은 건너뛰어라. 수천 개의 변하지 않은 아카이브를 다시 쓰는 야간 잡이 얻는 것은 새 파일 타임스탬프뿐이다. 파일 오버로드는 임시 파일을 거쳐 대상을 원자적으로 교체한다. 소스 파일은 문서가 로드되어 있는 동안 열려 있으므로 출력에는 다른 경로를 주어라
uses
  System.SysUtils, PDFium, FPdfPdfa, FPdfXmp;

procedure NormalizeArchive(const Source, Target: string);
var
  Pdf: TPdf;
  Report: TPdfAMetadataReport;
begin
  Pdf := TPdf.Create(nil);
  try
    Pdf.FileName := Source;
    Pdf.Active := True;
    Report := Pdf.InspectPdfAMetadata;
    if Report.IsEquivalent then
      Exit;                      // 이미 일치. 파일은 그대로 둔다
    if not Report.HasXmpPacket then
      raise Exception.Create('No XMP packet: convert with SaveAsPdfA instead');
    try
      if not Pdf.NormalizePdfAMetadata(Target) then
        raise Exception.Create('Normalized save failed');
    except
      on E: EPdfXmpError do      // 잘못된 Info 날짜 또는 읽을 수 없는 패킷
        raise Exception.CreateFmt('Cannot normalize %s: %s', [Source, E.Message]);
      on E: EPdfError do         // AllowSignedDocument 없이 서명된 입력
        raise Exception.CreateFmt('Skipped %s: %s', [Source, E.Message]);
    end;
  finally
    Pdf.Free;
  end;
end;
동등성은 ISO 19005-1의 한 조항일 뿐이다. 정규화된 파일은 폰트, 색, 투명도와 나머지 모든 PDF/A 검사를 여전히 통과해야 하므로, 문서가 장기 보관소로 떠나기 전에는 ValidatePdfA가 게이트로 남는다
문서를 열지 않고 패킷 비교하기
ComparePdfAInfoAndXmp와 SynchronizePdfAInfoToXmp는 PDF를 열지 않고 TPdfXmpPacket으로 동작하는 FPdfPdfa의 평범한 함수다. 문서가 존재하기 전에 템플릿으로 XMP를 채우는 단위 테스트와 파이프라인에 알맞다. SynchronizePdfAInfoToXmp는 다시 쓴 필드 집합을 돌려주고 nil 패킷을 받으면 EPdfXmpError를 던진다
함정은 단 하나, Present다. Default(TPdfAMetadataValues)로 초기화된 레코드는 빈 집합을 가지고, 모든 필드는 pamsNotRequired를 보고하며, 어떤 값을 채워 넣었든 비교는 통과한다. 레코드의 문자열 필드들은 값을 운반한다. 표준이 실제로 요구하는 것이 어느 것인지는 Present만이 결정한다
uses
  System.SysUtils, System.IOUtils, FPdfPdfa, FPdfXmp;

procedure AlignTemplate(const TemplateFile: string);
var
  Info: TPdfAMetadataValues;
  Packet: TPdfXmpPacket;
  Changed: TPdfAMetadataFields;
begin
  Info := Default(TPdfAMetadataValues);
  Info.Title := 'Quarterly Report 2026';
  Info.Author := 'Finance; Controlling';
  Info.ModDate := 'D:20260827093659+08''00''';
  // Present가 어떤 필드가 필수인지 결정한다. 값만으로는 무시된다
  Info.Present := [pamfTitle, pamfAuthor, pamfModDate];

  Packet := TPdfXmpPacket.Parse(TFile.ReadAllText(TemplateFile, TEncoding.UTF8));
  try
    Changed := SynchronizePdfAInfoToXmp(Info, Packet);
    // 어긋난 xmp:ModifyDate는 2026-08-27T01:36:59Z가 되고,
    // 어긋난 dc:creator는 항목 하나짜리 rdf:Seq가 된다
    if Changed <> [] then
      TFile.WriteAllBytes(TemplateFile, Packet.ToUtf8);
  finally
    Packet.Free;
  end;
end;
그 뒤 같은 템플릿을 ComparePdfAInfoAndXmp로 돌리면 빈 MismatchFields가 나와야 한다. 템플릿을 재생성하는 빌드 단계에 값싼 단정문이 된다
다른 시스템이 계속 편집하는 아카이브는 한 번에 한 필드씩 흘러간다. 필드별 리포트가 어느 것이 움직였는지 보여 준다. InspectPdfAMetadata, NormalizePdfAMetadata와 PDF/A 검증·변환 도구의 나머지는 Delphi와 C++Builder용 PDFium Component에 들어 있다