40페이지짜리 PDF에서 3페이지를 복사하는 데 2분이 걸린다면 그것은 성능 튜닝 문제가 아닙니다. 잘못된 API 경로가 쓰이고 있다는 신호입니다. HotPDF Delphi Component 위에서 만든 페이지 복사 코드에서 이 타이밍을 처음 봤을 때, 제 직감은 문서 구조를 먼저 보고 코드를 나중에 보는 것이었습니다. 그 순서가 거꾸로였다는 게 밝혀졌습니다
실제로 느렸던 점
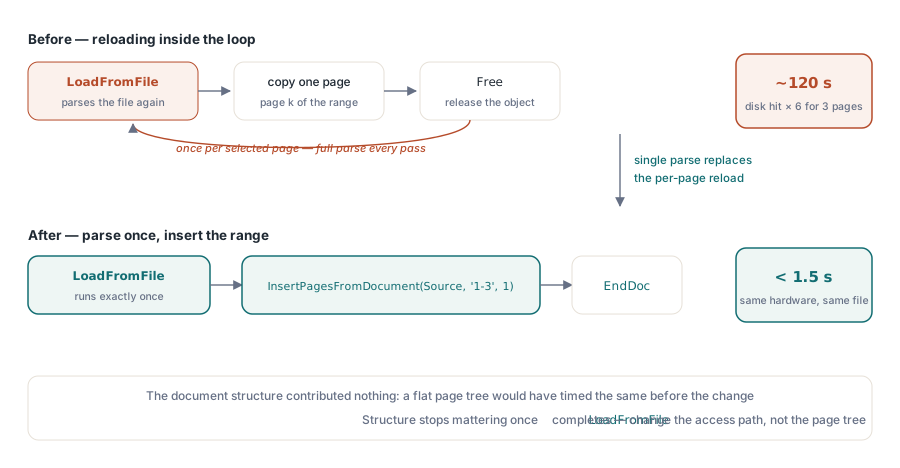
문제의 PDF는 단일 평면 배열 대신 다중 중간 /Pages 노드를 가진, 간단치 않은 페이지 트리를 지닌 40페이지짜리 참조 문서였습니다. 문제의 코드는 LoadFromFile을 호출한 다음 BeginDoc으로 새 문서를 빌드하고, 선택한 페이지 번호를 돌면서 매 반복마다 소스 문서를 디스크에서 다시 로드해 페이지를 가져오고 있었습니다. 원하는 페이지 수만큼 전체 파싱 비용을 곱하는 셈입니다. 아무도 반복 사이에 파일을 열어 둘 필요가 있는지 확인하지 않았기 때문에, 12MB 파일이 3페이지 추출에 디스크를 여섯 번 치게 됐습니다
두 번째 원인은 코드에서 보이지 않았습니다. HotPDF의 LoadFromFile은 편집 API가 일하는 인메모리 객체 모델을 빌드합니다. 수정하려는 문서에는 그것이 옳은 동작이지만, 페이지 수와 일부 페이지만 원한다면 필요 이상의 작업입니다. 구조에 대한 읽기 전용 접근에는 DAOpenFileReadOnly가 전체 객체 트리의 역직렬화를 피해 주며, 이미지 리소스가 큰 압축 파일에서 이것이 빛을 발합니다
둘 다 한 가지 작업용으로 설계된 API를 골라 다른 작업에 쓰는 데서 옵니다
페이지 추출에 ExtractPagesToFile 사용하기
로드한 HotPDF 문서에서 페이지 범위를 새 파일로 복사하는 올바른 경로는 소스에 LoadFromFile을 호출한 뒤 ExtractPagesToFile를 호출하는 것입니다. 소스를 한 번 로드하면, 이 호출이 대상 문서를 만들고 선택한 페이지를 거기에 복사해 디스크에 기록까지 해 줍니다. 전부 이미 메모리에 있는 복사본에서 이뤄집니다:
procedure ExtractPages(const SourceFile, DestFile: string;
  const PageRange: string);
var
  Source: THotPDF;
begin
  Source := THotPDF.Create(nil);
  try
    // 소스를 한 번 로드: 전체 파싱은 여기서, 오직 여기서만 일어납니다
    if Source.LoadFromFile(SourceFile) <= 0 then
      raise Exception.Create('Source PDF has no pages');

    // 요청된 범위('1-3', '1,5,7-9')를 새 파일에 곧바로 기록합니다
    Source.ExtractPagesToFile(DestFile, PageRange);
  finally
    Source.Free;
  end;
end;
PageRange 매개변수는 명령줄 샘플과 같은 형식을 받습니다. '1-3'이나 '1,5,7-9'처럼 페이지 번호나 범위를 쉼표로 나열한 목록입니다. 페이지는 1 기반입니다. ExtractPagesToFile는 선택된 각 페이지를 그것이 참조하는 content stream과 resource까지 함께 복사하므로, 40페이지 문서에서 3페이지 추출의 작업 집합은 작게 유지됩니다
2분이 걸리던 같은 12MB 파일에서의 타이밍: 이 패턴으로는 약 1.3초입니다. 대부분의 시간은 단 한 번의 LoadFromFile 호출입니다. 객체 테이블이 처음 한 번 해결되고 나면 문서 구조는 무관합니다
LoadFromFile이 과할 때: 직접 파일 API (Direct File API)
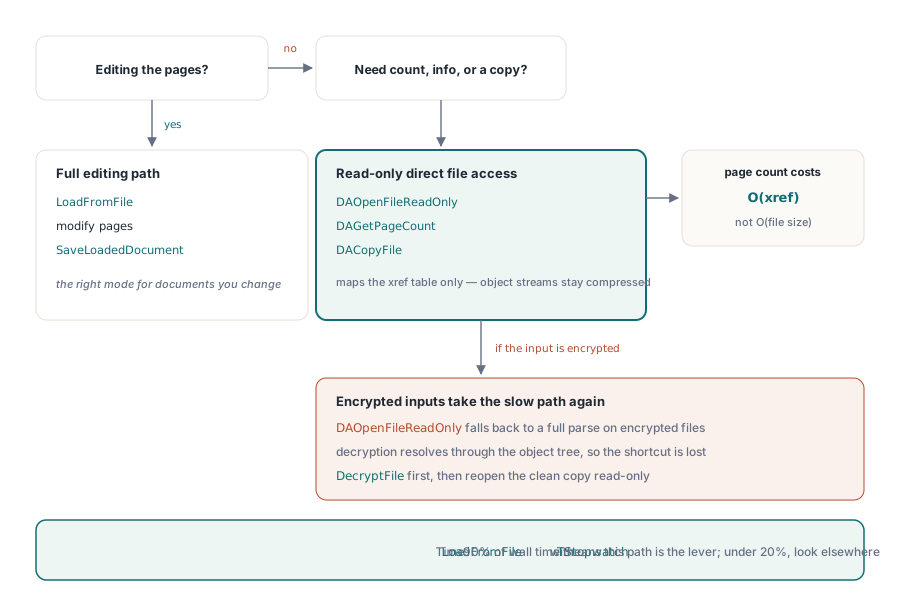
페이지 수를 계산하거나, 문서 정보를 검사하거나, 내용을 건드리지 않고 파일을 복사하기만 하면 되는 경우 직접 파일 API는 전체 파싱을 완전히 우회합니다. DAOpenFileReadOnly는 객체 스트림을 압축 해제하지 않고 상호 참조 테이블을 매핑하므로 페이지 계산은 O(파일 크기)가 아닌 O(xref 크기)가 됩니다:
procedure InspectPDF(const FileName: string);
var
  Pdf: THotPDF;
  Handle, PageCount: Integer;
begin
  Pdf := THotPDF.Create(nil);
  try
    Handle := Pdf.DAOpenFileReadOnly(FileName, '');
    if Handle <= 0 then
      Exit;
    try
      PageCount := Pdf.DAGetPageCount(Handle);
      Writeln('Pages: ', PageCount);

      // DACopyFile은 재직렬화 없는 바이트 보존 복사입니다
      Pdf.DACopyFile(FileName, 'archive-copy.pdf');
    finally
      Pdf.DACloseFile(Handle);
    end;
  finally
    Pdf.Free;
  end;
end;
주의 사항: DAOpenFileReadOnly는 암호 매개변수를 허용하지만 암호화된 입력에 대해서는 전체 파싱으로 돌아갑니다. 암호 해독에는 암호화 딕셔너리를 해결하기 위한 객체 트리가 필요하기 때문입니다. 소스 파일이 암호화되어 있다면, 먼저 DecryptFile로 해독하여 암호화되지 않은 복사본을 얻은 다음, 직접 파일 API로 그것을 엽니다. 파일 수준의 DecryptFile 함수는 표준 암호화를 위한 직접적인 AES-256 재작성 경로를 취하며 전체 인메모리 객체 모델을 빌드하지 않기 때문에 대용량 파일의 경우 LoadFromFile 후 SaveLoadedDocument를 호출하는 것보다 빠릅니다
대규모 일괄 처리 중의 메모리
루프에서 수십 개의 파일을 처리하는 일괄 작업에는 루프 내부에서 THotPDF를 생성하고, LoadFromFile을 호출하고, 작업을 수행하고, Free를 호출하는 정확해 보이는 패턴이 있지만 메모리가 누적됩니다. 이는 구조적으로 괜찮습니다. 문제는 내부 작업이 스크래치(임시) 객체를 할당하고, 예외를 포착하고, 오류 경로에서 이러한 스크래치 객체를 활성 상태로 남겨둘 때입니다. 델파이의 메모리 관리자는 압축을 하지 않으므로 일괄 실행에서 수백 개의 오류 경로 누출이 발생하면 메모리를 다른 모든 것의 할당을 느리게 할 만큼 높게 밀어 올릴 수 있습니다
해결책은 특이한 것이 아닙니다. 모든 THotPDF와 PDF 작업에 참여하는 모든 중간 TStream 또는 TBitmap은 Free가 마지막 문장인 try/finally 블록에 속해야 합니다. 초기화가 중간에 실패할 때 finally 분기가 if Assigned(x) then x.Free를 안전하게 사용할 수 있도록 try 전에 로컬 포인터를 nil로 설정하십시오. 이것은 표준 델파이 소유권 규칙이며 이 문제 부류에 대한 전체 내용입니다
일괄(batch) 컨텍스트에서 알아 둘 한 가지 더: AddImage는 이미지를 만들고 있는 문서에 등록하고, HotPDF는 EndDoc이 그 파일을 끝낼 때 그 등록을 해제합니다. 레지스트리는 LoadFromFile이 아니라 BeginDoc/EndDoc 주기를 따르므로, 일괄 작업의 깨끗한 패턴은 문서당 THotPDF 인스턴스 하나입니다. 만들고, 일하고, 저장하고, 해제합니다
아무 것도 변경하기 전에 측정하기
이러한 패턴에 손을 뻗기 전에 먼저 측정하십시오. System.Diagnostics의 델파이 TStopwatch는 QueryPerformanceCounter를 포장하며 파일 I/O의 실시간(wall-clock) 프로파일링에 충분히 정확합니다. LoadFromFile만 포장하여 시간이 얼마나 걸리는지 확인하십시오. 총 시간의 90%라면 직접 파일 API가 해결책이거나 동일한 파일을 구문 분석하는 횟수를 줄이는 것입니다. 20% 미만인 경우 병목 현상은 다른 곳에 있으며 잘못된 대상을 쫓고 있는 것입니다
이 글을 시작하게 만든 2분짜리 추출은 결국 전부 반복 로드 패턴 탓이었습니다. 문서 구조는 아무 기여도 하지 않았습니다. 평면 페이지 트리였어도 똑같이 돌았을 겁니다. 단일 LoadFromFile 뒤에 ExtractPagesToFile 호출 하나로 바꾸자, 다른 것은 하나도 건드리지 않고 같은 하드웨어에서 약 1.3초로 내려왔습니다
여기에 표시된 페이지 조작 API는 Delphi 및 C++Builder용 HotPDF Delphi Component의 일부입니다