여덟 시트짜리 XLSX 패키지를 여덟 개의 워커 스레드로 파싱하는 Delphi 로더도 CPU 그래프가 한 코어를 조금 넘는 수준에 머물 수 있고, 스레드 수를 2에서 8까지 바꿔 가며 재봐도 스톱워치는 거의 제자리입니다. 스레드를 둘로 나누면 오히려 단순 직렬 루프보다 느려지기까지 합니다. 파싱 코드는 자체 락을 잡지 않고 시트들도 데이터를 공유하지 않으므로, 대기는 소스 어디에도 언급되지 않는 곳에서 일어납니다. 바로 메모리 매니저 안입니다. 그 워커 각각이 요소 이름, 속성 값, 셀마다 메모리 매니저를 부릅니다
스레드 수는 누구나 가장 먼저 만지는 손잡이지만, 할당이 병목인 코드에서는 거의 아무것도 움직이지 않습니다. 곡선을 움직이는 것은 셀 하나가 치르는 힙 할당 횟수입니다
HotXLS가 Open을 세 단계로 나누는 방법
HotXLS는 기본적으로 멀티 시트 XLSX 패키지의 워크시트를 워커 스레드에서 파싱합니다. TXLSXWorkbook.ParallelParse의 초기값은 True이고 ParallelParseThreads의 초기값은 0인데, 0은 운영체제가 보고하는 논리 프로세서당 워커 하나를 뜻하며, 파싱할 시트 수를 넘지는 않습니다. Open의 세 단계 중 이 워커에서 도는 것은 하나뿐입니다. Phase A는 직렬입니다. 워크북 파트, 공유 문자열, 스타일을 읽고, 모든 시트를 이름과 표시 여부와 함께 만들며, 각 시트의 관계 파일을 파싱해 하이퍼링크와 테이블 대상을 미리 확정합니다. 워커가 시작하는 시점에는 그것이 참조하는 조회 테이블이 모두 완성되어 있고 오직 읽기만 일어납니다
Phase B는 각 워크시트를 워커에게 넘깁니다. 워커들은 공유 카운터에서 인터락 증가로 시트 인덱스를 가져가므로, 큰 시트 하나와 작은 시트 일곱 개로 이루어진 워크북도 스케줄러 없이 스스로 균형을 맞춥니다. 작은 시트를 끝낸 워커는 그냥 다음 인덱스를 가져가면 됩니다. 아무렇게나 공유할 수 없는 부분은 ZIP 컨테이너입니다. deflate 스트림은 이전 블록의 상태를 다음 블록이 이어받으므로, 두 스레드가 같은 디컴프레서를 함께 전진시킬 수는 없습니다. 그래서 각 워커는 자기 시트 항목 위에 자기만의 디컴프레서를 열고 XML을 자기 리더로 곧장 흘려보냅니다. 공유 자원은 파일 핸들 하나뿐이고, 그 주위의 락은 압축 바이트의 seek-and-read 한 번을 커버합니다. 압축 해제와 파싱은 모두 병렬로 돌고, 어떤 워크시트의 XML도 완전히 풀린 채로 메모리에 들어 있는 일은 없습니다. 파싱이 끝나면 워커는 자기 항목을 끝까지 읽어 ZIP 크기와 CRC 검사가 여전히 돌게 합니다
Phase C는 단일 스레드로 돌아가 시트에 매달린 나머지 부분, 즉 메모와 스레드된 메모, 드로잉과 차트, 테이블, 프린터 설정을 처리합니다. 대부분의 워크북에서 이것들은 셀 XML에 비하면 작은 편입니다
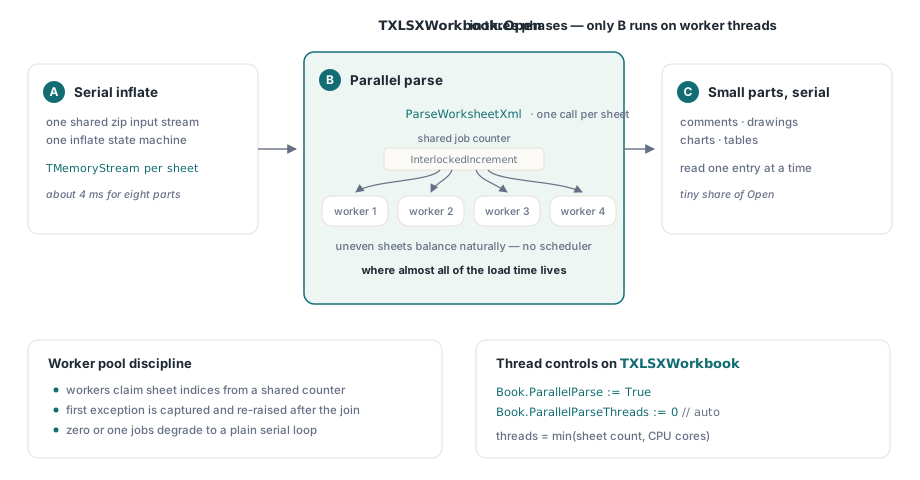
오류는 호출 스레드로 돌아옵니다. 파싱 중 어떤 시트가 예외를 던지면 풀은 새 인덱스를 나눠주는 것을 멈추고 아직 도는 워커들을 기다린 뒤, 가장 번호가 낮은 실패 시트의 예외를 Open에서 다시 던지므로 보고가 시트 순서를 따르고 호출자는 워커 스레드에서 새어 나오는 예외를 다룰 일이 없습니다. RecoveryMode를 True로 두면 파싱에 실패한 시트는 건너뛰어지고 Diagnostics에 경고가 남으며 나머지 시트는 정상적으로 로드됩니다. ParallelParse를 False로 두면 같은 파서가 시트를 하나씩 돌며 동일한 결과를 만듭니다
var
  Book: TXLSXWorkbook;
begin
  Book := TXLSXWorkbook.Create;
  try
    // 두 값 모두 기본값입니다; 코드 리뷰에서 선택이
    // 보이도록 명시적으로 적어 둡니다
    Book.ParallelParse := True;
    Book.ParallelParseThreads := 0;  // 0 = 논리 CPU당 워커 하나, 시트 수가 상한
    Book.RecoveryMode := False;      // 파싱에 실패한 시트는 Open에서 raise
    if Book.Open('quarterly-ledger.xlsx') <> 1 then
      raise Exception.Create('open failed');
    // 모든 시트가 여기서 완전히 로드된 상태; 평소처럼 셀을 읽으면 됩니다
  finally
    Book.Free;
  end;
end;
스레드를 늘리면 할당이 많은 파서가 왜 더 느려질까요?
워크시트 파싱은 대부분 소형 할당이고, Delphi의 기본 메모리 매니저는 이에 대해 스레드들이 차례를 기다리게 만듭니다. 순진한 XML 리더는 요소 이름마다 문자열을 하나, 속성 이름과 값마다 또 하나씩 만들고, 셀마다 Variant 하나와 텍스트용 문자열 하나를 만듭니다. 기본 메모리 매니저는 소형 블록을 크기별 풀로 나눠 보관하고 각 풀을 락으로 지킵니다. 락이 잡혀 있는 것을 발견한 스레드는 백오프했다가 잠시 잠들고 재시도합니다. 여덟 워커가 같은 몇 가지 자잘한 크기를 동시에 청하면 같은 풀에서 계속 부딪히고, 소스상으로는 독립적으로 보이는 스레드들이 결국 한 번에 하나씩 돌게 됩니다
도입부의 두 증상이 모두 설명됩니다. 잠자는 스레드는 CPU를 태우지 않으므로 CPU 시간이 벽시계 시간에 가깝게 유지되고, 곡선의 기울기를 정하는 것은 코어가 아니라 풀 락이므로 스레드 스윕도 평평합니다. 스레드 둘이 하나에게 지는 경우도 가능합니다. 할당마다 코어 사이에서 락을 주고받는 비용이 들기 때문입니다. 직렬 루프는 애초에 경합이 없습니다
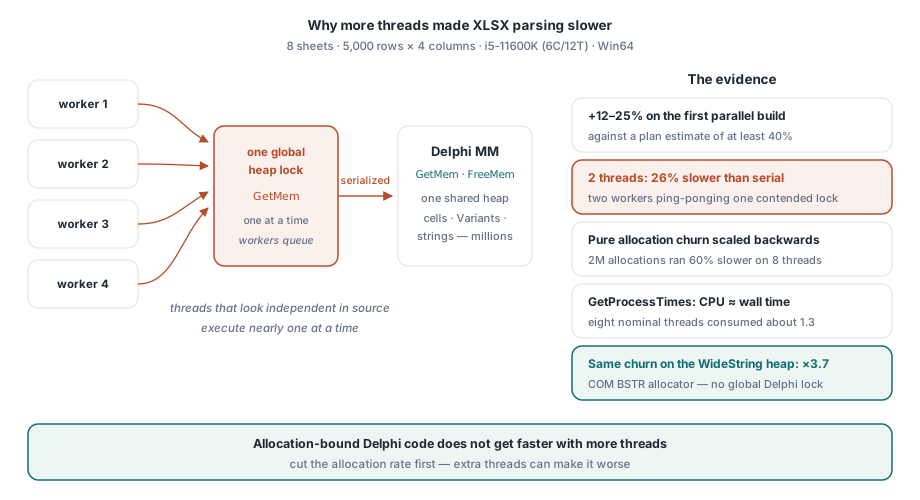
한 가지 문자열 타입은 Windows에서 이 경합 밖에 있습니다. WideString은 COM BSTR로, Delphi 메모리 매니저가 아니라 시스템의 OLE 문자열 할당자가 할당합니다. 그래서 WideString 트래픽은 Delphi 풀에서 줄을 서지 않습니다. HotXLS는 셀 텍스트를 WideString으로 저장하는데, 직렬 경로 때보다 병렬 로드에서 이 선택이 더 큰 빛을 봅니다
내 워크북에서 직접 경합 측정하기
로드가 할당 병목인지는 두 숫자로 판단합니다. 워커 수를 올릴 때 벽시계 시간이 어떻게 변하는지, 그리고 같은 구간에서 프로세스가 얼마나 CPU를 소모했는지입니다. 여덟 워커가 명목상 바쁜 동안에도 CPU 시간 나누기 벽시계 시간이 1.0 근처라면 그것들은 파싱이 아니라 줄 서고 있는 것입니다. 아래 스윕은 같은 파일을 워커 1개부터 8개까지 열어 두 수치를 모두 출력합니다. 여러분의 테스트 프로젝트에 붙이는 측정 하네스이고, HotXLS에서 오는 것은 TXLSXWorkbook 멤버뿐입니다
uses
  Winapi.Windows, System.SysUtils, System.Math, System.Diagnostics;

// 여러분 자신의 헬퍼: 이 프로세스의 user + kernel CPU 시간, 밀리초
function ProcessCpuMs: Int64;
var
  Created, Exited, Kernel, User: TFileTime;
begin
  GetProcessTimes(GetCurrentProcess, Created, Exited, Kernel, User);
  Result := (Int64(Kernel) + Int64(User)) div 10000;  // 100 ns 틱을 ms로
end;

procedure SweepThreads(const FileName: string);
var
  N: Integer;
  Book: TXLSXWorkbook;
  SW: TStopwatch;
  Cpu0, Cpu: Int64;
begin
  for N := 1 to 8 do
  begin
    Book := TXLSXWorkbook.Create;
    try
      Book.ParallelParseThreads := N;  // 1은 그냥 직렬 루프
      Cpu0 := ProcessCpuMs;
      SW := TStopwatch.StartNew;
      if Book.Open(FileName) <> 1 then
        raise Exception.CreateFmt('open failed: %s', [FileName]);
      SW.Stop;
      Cpu := ProcessCpuMs - Cpu0;
      Writeln(Format('%d workers: %d ms wall, CPU/wall %.2f',
        [N, SW.ElapsedMilliseconds, Cpu / Max(Int64(1), SW.ElapsedMilliseconds)]));
    finally
      Book.Free;
    end;
  end;
end;
스윕은 여러 번 돌려서 워커 수마다 가장 좋은 수치를 남기세요. 첫 실행은 차가운 디스크 캐시 비용까지 지불합니다. 벽시계 곡선이 평평하고 CPU/wall이 1 근처면 메모리 매니저가 천장입니다. 벽시계 시간은 계속 떨어지고 CPU/wall이 워커 수를 향해 오르면 파일은 파싱 병목이고 워커를 더 쓰는 것이 값어치를 합니다
평평한 곡선이면 다음 질문으로 넘어갑니다. 어떤 할당이 범인인가? 크기별 호출 횟수를 세는 메모리 매니저 래퍼면 프로파일러 없이도 몇 분 안에 답이 나옵니다. 아래 버전은 GetMem만 세고 FreeMem과 ReallocMem은 원래 매니저로 돌려두는데, 트래픽의 출처를 파악하기에는 이 정도면 충분합니다
// 여러분의 테스트 하네스에 붙이는 진단 코드; HotXLS의 일부가 아님
var
  OldMM, NewMM: TMemoryManagerEx;
  AllocCount, TinyCount: Int64;

function CountingGetMem(Size: NativeInt): Pointer;
begin
  AtomicIncrement(AllocCount);
  if Size <= 32 then
    AtomicIncrement(TinyCount);  // 주목할 만한 소형 블록 churn
  Result := OldMM.GetMem(Size);
end;

procedure InstallCounter;
begin
  GetMemoryManager(OldMM);
  NewMM := OldMM;
  NewMM.GetMem := CountingGetMem;
  SetMemoryManager(NewMM);
end;

procedure RemoveCounter;
begin
  SetMemoryManager(OldMM);
end;
카운터는 Open 직전에 설치하고 직후에 제거한 뒤, AllocCount를 파일의 셀 개수로 나눕니다. 이 셀당 수치를 빌드마다 추적하면 되고, 32바이트 이하 블록의 비중이 짧은 문자열이 지배하는지를 보여줍니다. 셀 객체 풀을 만들기 전에 확인하세요. 셀 객체 하나가 할당 하나지만, 그 셀을 파싱하는 동안 만들어지는 수명 짧은 문자열들이 그 몇 배는 쉽게 넘습니다
워크시트 XML에 할당이 숨는 곳
<c r="B7" s="3" t="s"><v>42</v></c> 같은 셀은 디스크에서는 아주 작아 보입니다. 그래도 순진한 리더는 이것을 새 문자열의 행진으로 바꿔 놓습니다. 요소 이름 c와 v, 속성 이름 세 개, 속성 값 세 개, 텍스트 콘텐츠입니다. 각 UTF-8 토큰을 RTL로 변환하면 최종 WideString이 생기기 전에 중간 UnicodeString이 하나 더 생깁니다. 이 문자열들은 셀보다 오래 살지 못하고, 하나하나가 메모리 매니저를 한 번씩 통과합니다
HotXLS의 XML 리더는 가장 큰 두 출처를 노립니다. 워크시트 XML의 요소 이름은 극히 좁은 어휘(row, c, v, f, is)에서 나오므로, 리더는 이미 만난 이름의 짧은 캐시를 유지하고 새 이름의 raw 바이트를 그 캐시와 비교해, 일치하면 캐시된 문자열을 돌려줍니다. 캐시 사본은 의도적으로 AnsiString입니다. AnsiString은 참조 카운트로 관리되므로 캐시 인스턴스를 넘겨주는 것은 카운터 증가 한 번이고 할당은 전혀 없습니다. WideString 이름 캐시는 아무 이득이 없습니다. WideString은 참조 카운트가 없어 대입할 때마다 새 시스템 할당이 일어납니다
속성 이름, 속성 값, 셀 텍스트는 다른 경로를 갑니다. 리더는 스캔 버퍼에서 UTF-8을 두 패스로 곧장 디코딩합니다. 첫 패스는 UTF-16 코드 유닛 수를 세고, 둘째 패스가 딱 그 길이로 한 번 할당한 WideString을 채웁니다. 토큰당 할당 한 번이고, 그마저 Delphi 풀이 아니라 시스템 문자열 할당자로 갑니다. A 같은 문자 참조와 미리 정의된 엔티티는 디코딩이 시작되기 전에 스캐너가 해석하므로, 디코더가 보는 것은 항상 순수 UTF-8입니다. 유효하지 않은 UTF-8 바이트 시퀀스에 대해서는, 디코더가 RTL 변환이라면 버리거나 치환했을 바이트를 하나씩 그대로 통과시키므로 손상된 파일도 나쁜 지점 주변의 읽을 수 있는 ASCII는 살아 남습니다. 유효한 입력은 어느 쪽으로든 같은 텍스트로 디코딩됩니다
두 기법 모두 여러분의 Delphi 파싱 코드에 그대로 이식됩니다. 문자열 캐싱은 문자열 타입이 참조 카운트 방식일 때만 할당을 아껴 주고, 대상 타입으로 곧장 디코딩하면 편리한 RTL 변환 함수가 호출마다 만들어 내는 임시 객체가 사라집니다
어떤 워크북이 이득을 보고, 어떤 설정을 고를까
병렬 파싱은 워크시트 단위로 동작하므로 워크북의 모양이 결정권자입니다. 비슷한 크기의 시트 여러 개가 최상의 조건입니다. 지역별, 월별로 템플릿 워크시트를 복제해 만든 파일들도 여기에 듭니다. 거대한 시트 하나짜리 워크북은 ParallelParseThreads가 뭐라 하든 워커 하나에서 파싱됩니다. 이런 모양에는 스트리밍 다이렉트 리더가 더 어울립니다. 워크북 전체를 메모리에 만들지 않으니까요. 메모, 차트, 드로잉에 쓰이는 시간은 직렬 Phase C에 그대로 남습니다. 파싱할 시트가 0개 또는 1개인 파일은 풀을 건너뛰고 그냥 직렬 루프로 돕니다
일부 시트만 필요하다면 Open을 부르기 전에 SelectedSheets에 이름을 나열합니다. 나머지 시트도 이름과 표시 여부와 함께 만들어지긴 하지만 셀은 없으며, 워커들이 그 위를 지나가고, 사용자가 나중에 열면 LoadSheet가 그때 채워 넣습니다
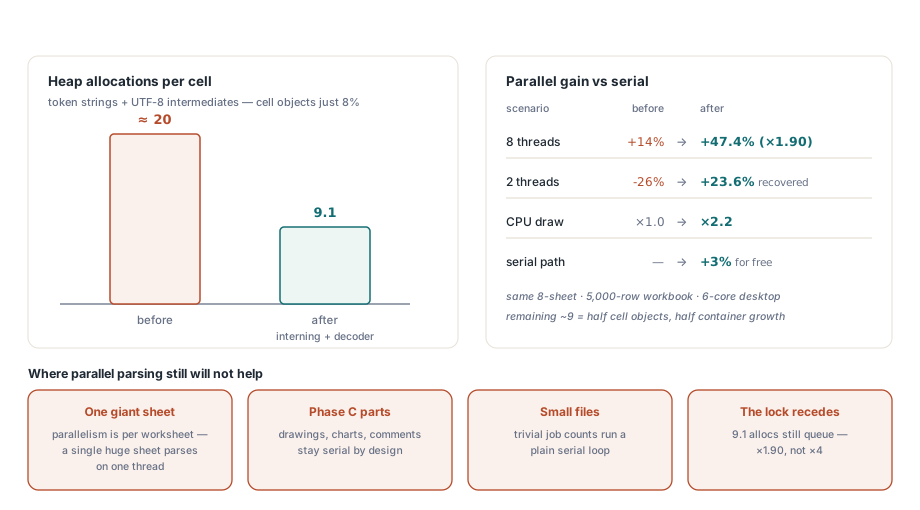
한 번에 워크북 하나를 여는 데스크톱 도구와 배치 잡에는 ParallelParse를 켜 두세요. 그쪽이 더 안전한 기본값입니다. 결과는 직렬 경로와 일치하고, 스레딩 문제가 생기면 속성 하나로 끌 수 있습니다. 이미 여러 워크북을 동시에 여는 서버는 이야기가 다릅니다. 요청 스레드들도 할당을 하고 있으므로 파싱 워커가 늘어날수록 같은 메모리 매니저 풀의 경쟁자가 늘어납니다. 그런 서버에서는 ParallelParseThreads를 2로 두고, 위 스윕을 그 서버에서 평소 부하 상태로 돌려서 추가 워커가 값어치를 하는지 확인한 후에만 올리세요. 셀당 할당을 줄이면 천장이 높아질 뿐 없어지지는 않습니다. 셀 객체와 컨테이너 성장은 여전히 Delphi 풀을 거치므로, 여덟 워커의 이득이 8배에는 크게 못 미치는 이유입니다. 스타일 재사용부터 벌크 행 콜백까지 로드-저장 도구의 나머지는 Delphi 대용량 워크북 성능 가이드를 보세요
워커 풀, ParallelParse와 ParallelParseThreads 스위치, 할당이 가벼운 XML 리더는 모두 HotXLS Delphi Excel Component에 들어 있습니다. 이 컴포넌트는 머신에 Excel이 설치되어 있지 않아도 Delphi와 C++Builder 코드에서 XLS, XLSX, ODS를 직접 읽고 씁니다