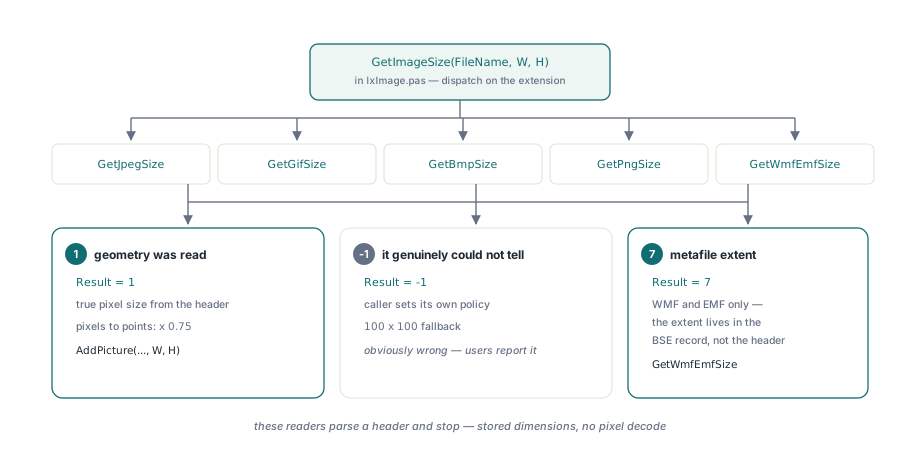
HotXLS는 그리기 지오메트리를 기록하기 전에 이미지 파일 자체의 헤더에서 그림의 실제 픽셀 크기를 읽습니다. lxImage.pas의 GetImageSize는 파일 확장자에 따라 GetJpegSize, GetGifSize, GetBmpSize, GetPngSize, GetWmfEmfSize로 분기하고, 0.75 배율로 픽셀을 포인트로 변환하며, 정말로 알 수 없을 때는 -1을 반환합니다
마지막 조항이 가장 오래 걸린 부분입니다. 실패할 수 없는 크기 리더는 거짓말하는 크기 리더이고, 이미지 지오메트리에 대한 거짓말은 삽입 시점에는 드러나지 않습니다. 몇 주 뒤 누군가 통합 문서를 열고 회사 로고가 찌그러진 사각형으로 보일 때야 표면 위로 올라옵니다
그림이 드로잉에 들어가기 전에 실제 지오메트리가 필요한 이유
스프레드시트 형식은 이미지가 아니라 범위(extent)를 저장하기 때문입니다. AddPicture나 Images.AddFromFile이 그림을 배치하면 드로잉 부분은 셰이프에 명시적인 너비와 높이를 기록합니다. DrawingML에서는 ECMA-376 Part 1 §20.4에 따라 EMU(English Metric Unit) 단위로 된 a:ext 요소의 cx와 cy 속성이 그것입니다. 그 레코드에는 "이미지의 자연 크기를 사용하라"는 말이 없으므로 자연 크기는 어딘가에서 가져와야 하고, 그 정보가 존재하는 유일한 곳은 이미지 바이트입니다. 3배로 틀리면 통합 문서를 여는 모든 애플리케이션에서 그림이 영원히 3배로 늘어납니다. 그 픽셀 크기를 EMU로 변환하는 것은 별개 주제로, EMU 단위와 스케일링 문서에서 다룹니다. 이 글은 그 이전 단계, 즉 픽셀 숫자를 얻는 부분에 관한 것입니다. 리더가 실패했을 때의 폴백은 100×100이고, 그 숫자는 의도적으로 분명히 틀렸습니다. 그럴듯한 크기를 추측한 것이 아니라 "아무도 이 파일을 읽지 못했다"는 표식이며, 그럴듯해 보이는 틀린 숫자보다 훨씬 낫습니다. 사용자가 즉시 신고하기 때문입니다
GIF: 한 번도 파싱되지 않던 디스크립터
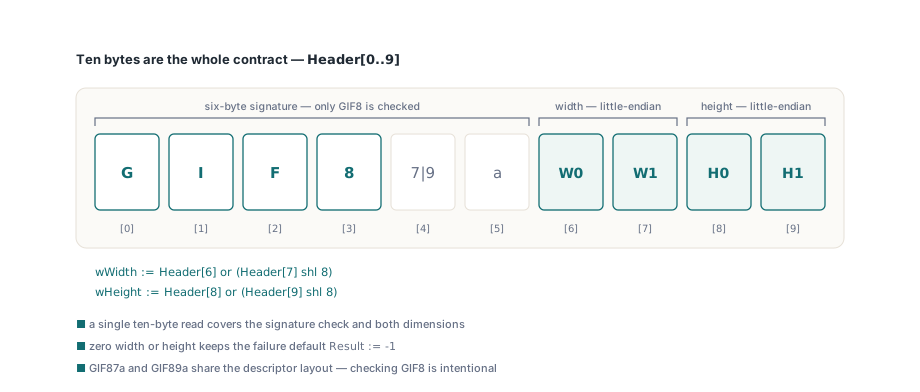
GetGifSize는 새로 추가됐고, 그 전에는 워크시트에 삽입되는 모든 GIF가 정확히 100×100으로 나왔습니다. GIF 분기가 아예 없어서 확장자가 GetImageSize의 기본 분기에 떨어져 -1을 반환했기 때문입니다. 이는 이 집합에서 가장 파싱하기 쉬운 헤더라서, 누락이 살짝 부끄럽고 고치기도 매우 쉽습니다. GIF89a 스펙은 6바이트 시그니처 바로 뒤에 Logical Screen Descriptor를 두며, §18은 그 첫 두 필드를 논리 화면 너비와 높이로 정의합니다. 각각 리틀엔디언으로 저장되는 부호 없는 16비트 값입니다. 파일 기준으로 너비는 바이트 6과 7, 높이는 바이트 8과 9이므로, 10바이트 읽기 한 번이 시그니처 검사와 두 치수를 모두 처리합니다
function GetGifSize(const AFileName: WideString; var AWidth, AHeight: Double): Integer;
var
  f: TWFileStream;
  Header: array [0.. 9] of Byte;
  wWidth, wHeight: Word;
begin
  Result:= - 1;
  AWidth:= 100;
  AHeight:= 100;
  f:= TWFileStream.Create(AFileName, fmOpenRead);
  try
    // 시그니처 "GIF8", 이어서 오프셋 6과 8에 리틀엔디언 워드로 저장된
    // 너비와 높이를 담은 Logical Screen Descriptor
    if (f.Read(Header[0], SizeOf(Header))= SizeOf(Header))and
      (Header[0]= Ord('G'))and (Header[1]= Ord('I'))and
      (Header[2]= Ord('F'))and (Header[3]= Ord('8')) then
    begin
      wWidth:= Header[6]or (Header[7] shl 8);
      wHeight:= Header[8]or (Header[9] shl 8);
      if (wWidth> 0)and (wHeight> 0) then
      begin
        AWidth:= wWidth* 0.75;
        AHeight:= wHeight* 0.75;
        Result:= 1;
      end;
    end;
  finally
    f.Free;
  end;
end;
구조를 눈여겨보세요. 실패 값이 먼저 할당되고, 성공 경로만이 그것들을 덮어씁니다. lxImage.pas의 모든 리더가 이 순서를 따르는데, "이 파일을 읽지 못했다"를 매 조기 종료마다 기억해야 하는 상태가 아니라 기본값으로 만들기 때문입니다. 전체 GIF87a나 GIF89a 문자열 대신 GIF8만 검사하는 것은 의도적입니다. 두 리비전의 디스크립터 레이아웃이 동일하므로, 지오메트리를 읽을 수 있는 파일을 거부할 이득이 없습니다
BMP 헤더 크기 12가 실제로 바꾸는 것
GetBmpSize는 오프셋 14의 4바이트를 DIB 헤더 크기로 읽고 값에 따라 분기합니다. 헤더 크기가 12인 BMP는 다른 모든 BMP와 완전히 다른 필드 폭으로 치수를 저장하기 때문입니다. [MS-WMF] §2.2.2는 그 계열을 정리합니다. BITMAPCOREHEADER는 12바이트로 16비트 너비와 높이를 담고, BITMAPINFOHEADER, BITMAPV4HEADER, BITMAPV5HEADER는 모두 32비트 부호 있는 biWidth와 biHeight로 시작합니다. 파일에 2바이트밖에 없는 곳에서 4바이트를 읽는 것은 큰 소리로 실패하지 않습니다. 플레인 수와 비트 깊이를 숫자의 상위 절반으로 끌어들여 폭이 수십만 픽셀인 비트맵으로 보고합니다. 같은 헤더의 두 번째 함정은 biHeight의 부호입니다. 음수 값은 음수 높이를 뜻하지 않고, DIB 행이 bottom-up 대신 top-down으로 저장된다는 뜻이며, 이는 지오메트리와 무관한 픽셀 순서에 관한 진술입니다
  f.Seek(14, soFromBeginning);
  if f.Read(HeaderSize, 4)= 4 then
  begin
    if HeaderSize= 12 then
    begin
      // BITMAPCOREHEADER는 16비트 치수를 저장합니다
      if (f.Read(wWidth, 2)= 2)and (f.Read(wHeight, 2)= 2) then
      begin
        lWidth:= wWidth;
        lHeight:= wHeight;
        Result:= 1;
      end;
    end
    else if (f.Read(lWidth, 4)= 4)and (f.Read(lHeight, 4)= 4) then
      Result:= 1;
  end;
  // ...
  // 음수 biHeight는 top-down DIB 표시일 뿐이며, 크기는 절댓값입니다
  if (Result= 1)and (lWidth> 0)and (lHeight<> 0) then
  begin
    AWidth:= lWidth* 0.75;
    AHeight:= Abs(lHeight)* 0.75;
  end
  else
    Result:= - 1;
마지막 가드(guard)는 자세히 읽을 가치가 있습니다. 높이는 > 0이 아니라 <> 0으로 검사합니다. 음수는 합법이고 0은 합법이 아니기 때문이며, Abs는 변환 시점에만 적용됩니다. 너비에는 대응하는 경우가 없습니다. 음수 biWidth는 형식에서 정의되지 않으므로 손상된 파일로 취급해 -1로 강등합니다. 대신 원시 음수 값을 위로 넘기면 드로잉 레코드에 음수 범위가 생기고, 통합 문서를 여는 애플리케이션에 따라 클램프되거나 무시되거나 뒤집힌 셰이프로 렌더링됩니다
JPEG: 실제 프레임 헤더인 마커는 무엇인가
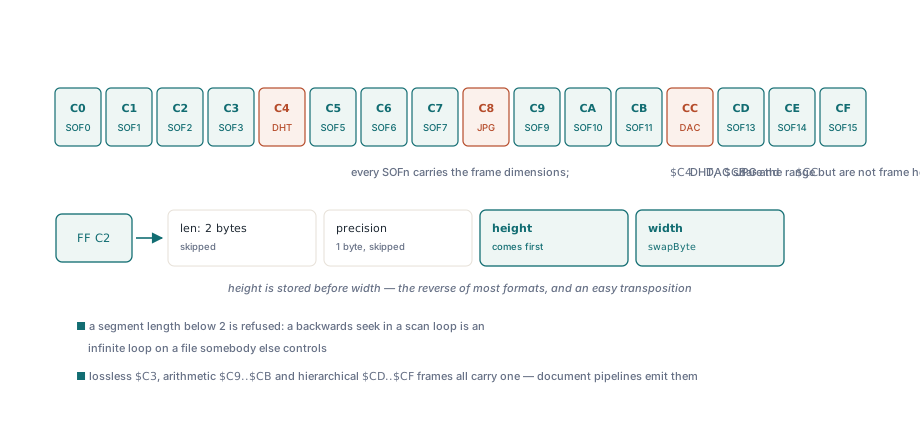
GetJpegSize는 마커 집합 [$C0..$C3, $C5..$C7, $C9..$CB, $CD..$CF]를 받아들이고, 그 범위의 세 갭이 바로 핵심입니다. ITU-T T.81 §B.2.2는 프레임 헤더를 SOFn으로 정의하며, 프레임 헤더에는 흔한 프레임 타입뿐 아니라 모든 프레임 타입의 줄 수와 줄당 샘플 수가 들어 있습니다. 같은 숫자 범위 안에 있지만 프레임 헤더가 아닌 마커는 $C4(DHT, 허프만 테이블 정의), $C8(JPG, 예약됨), $CC(DAC, 산술 코딩 컨디셔닝 정의)입니다. baseline, extended sequential, progressive — $C0, $C1, $C2 — 만 인식하는 리더는 카메라나 스크린샷 도구가 만드는 거의 모든 JPEG에서 동작하다가, 문서 워크플로에 중요한 것들에서는 조용히 실패합니다. lossless JPEG($C3), 산술 코딩 변형($C9~$CB), 계층형 프레임 타입($CD~$CF)이 모두 프레임 헤더를 지나쳐 파일 끝까지 읽고 폴백에 빠집니다. 의료 영상과 스캔 문서 파이프라인은 정확히 그런 파일을 생산합니다
// 모든 SOFn 마커는 프레임 치수를 담습니다. $C4 (DHT), $C8 (JPG)
// 그리고 $CC (DAC)는 범위를 공유하지만 프레임 헤더가 아닙니다
if Seg in [$C0.. $C3, $C5.. $C7, $C9.. $CB, $CD.. $CF] then
begin
  ReadLen:= f.Read(Dummy[0], 3);
  ReadLen:= f.Read(wHeight, 2);
  wHeight:= swapByte(wHeight);
  ReadLen:= f.Read(wWidth, 2);
  wWidth:= swapByte(wWidth);
  found:= True;
  Break;
end
그 일곱 줄에 담긴 세부 사항 두 가지. 건너뛰는 세 바이트는 세그먼트 길이 워드와 샘플 정밀도 바이트라서, 읽기는 줄 수에 정확히 맞습니다. JPEG는 너비보다 높이를 먼저 저장하는데, 이는 대부분의 형식과 반대라 뒤바꿔 쓰기 쉽습니다. 그리고 JPEG는 전체가 빅엔디언이라 값이 swapByte를 거치는데, GetPngSize가 32비트 IHDR 값을 lswapByte로 처리하는 것과 같은 이유입니다. 세그먼트 탐색에도 자체 가드가 있습니다. 마커가 파라미터 없는 것이 아니면 리더는 2바이트 길이를 읽어 바이트 스왑하고, 값이 2보다 작으면 시크를 거부합니다. 자기 필드보다 짧은 길이는 뒤로 시크로 이어지고, 스캔 루프의 뒤로 시크는 남이 통제하는 파일에서 무한 루프가 됩니다
그럴듯한 숫자보다 -1을 반환하는 이유
다섯 리더에 공통된 실마리는 GetImageSize가 두 가지가 아니라 세 가지 결과를 구분한다는 점입니다. 1은 파일에서 지오메트리를 읽었다는 뜻입니다. -1은 읽지 못했다는 뜻이고 호출자는 기본값을 사용해야 합니다. 7은 GetWmfEmfSize가 반환하며 완전히 다른 의미입니다. WMF나 EMF는 파일 헤더의 고정 오프셋이 아니라 통합 문서 자체의 그림 레코드에 범위를 담으므로, AddPicture에게 메타파일 BSE 레코드에서 크기를 가져오라고 지시합니다. 메타파일 처리 전반은 bounded EMF 및 WMF 디코더 문서에서 다룹니다. GetJpegSize는 그 구분이 추론이 아니라 명시적 플래그를 필요로 하는 이유를 보여줍니다. 스캔 루프는 세 가지로 종료됩니다. 프레임 헤더를 찾았거나, 파일 끝에 도달했거나, 손상된 세그먼트 길이에서 빠져나온 경우이며, 첫 번째만 wWidth와 wHeight를 할당합니다. found 불리언이 없으면 나머지 두 경로는 그 로컬 변수에 우연히 들어 있던 값을 변환해 성공으로 위로 넘겨줄 것입니다. 초기화되지 않은 로컬 변수는 자주 0이고, 0은 여기서 최악의 답입니다. 이후의 모든 유효성 검사를 통과해 아무도 선택하거나 삭제할 수 없는 투명한 그림이 됩니다
var
  W, H: Double;
begin
  case GetImageSize(FileName, W, H) of
    1: Sheet.AddPicture(FileName, Row, Col, W, H);
    7: Sheet.AddPicture(FileName, Row, Col);  // 메타파일: 크기는 BSE 레코드에서
  else
    // W와 H는 100 x 100입니다. 플레이스홀더를 받아들이는 대신 정책을 결정하세요
    LogWarning('unreadable image geometry: ' + FileName);
  end;
end;
정직한 한계가 있는 곳
이 리더들은 의도적으로 헤더만 파싱하고 멈춥니다. 픽셀을 디코딩하지 않으므로 저장된 치수만 보고하며, 저장된 치수가 전부가 아닌 경우도 있습니다. 프레임이 논리 화면보다 작은 애니메이션 GIF는 여전히 논리 화면을 보고하는데, 레이아웃에는 맞지만 뷰어가 보여주는 것과 다를 수 있습니다. 90도 회전을 지정하는 EXIF 방향 태그가 있는 JPEG는 회전 전 프레임 치수를 보고하므로, 폰으로 찍은 세로 사진이 가로로 나올 수 있습니다. 정사각형이 아닌 픽셀 종횡비의 DIB는 원시 픽셀 수를 보고하고, 0.75 배율은 전체가 96 DPI를 가정합니다. 그 어느 것도 헤더 읽기의 버그가 아니고, 이미지를 디코딩하지 않고는 고칠 수 없으며, 그것은 이 레이어의 역할이 아닙니다. 문서화된 경계입니다. 파이프라인이 폰 사진을 처리한다면 방향 태그를 직접 읽어 AddPicture를 호출하기 전에 값을 바꿔 넣으세요. 그림 배치, 앵커링, 드로잉 객체 모델에 관한 나머지는 charts, images, drawings 문서에서 다룹니다
HotXLS는 Excel 설치 없이 Delphi와 C++Builder에서 XLS, XLSX, ODS, CSV를 네이티브로 읽고 쓰며, 그림 삽입은 모든 형식에서 이 헤더 경로를 거칩니다. 형식 지원과 라이선스 세부 사항은 HotXLS Delphi 스프레드시트 컴포넌트 제품 페이지에 있습니다