PDF가 폰트를 임베드하지 않았을 때, HotPDF 컴포넌트는 HPDFMapBaseFontToSystem이 고른 설치된 Windows 폰트로 그 텍스트를 렌더링합니다. /BaseFont 이름을 디코딩하고, 스타일 부분을 잘라 내고, GDI가 패밀리가 설치됐음을 확인할 때까지 여러 철자를 시도하며, 빠진 standard 14 너비를 메트릭 호환 폰트에서 재고, 그리기 전에 1바이트 코드를 Unicode로 변환합니다. 그 단계 각각은 나이브한 버전이 실전 파일에서 실패했기 때문에 존재합니다. RenderLoadedPageToBitmap 페이지 렌더러는 임베드된 프로그램은 잘 처리합니다. 이 글은 파일 안에 아예 없는 폰트들의 이야기입니다
GDI는 임베드 안 된 폰트에 왜 조용히 엉뚱한 서체를 그릴까?
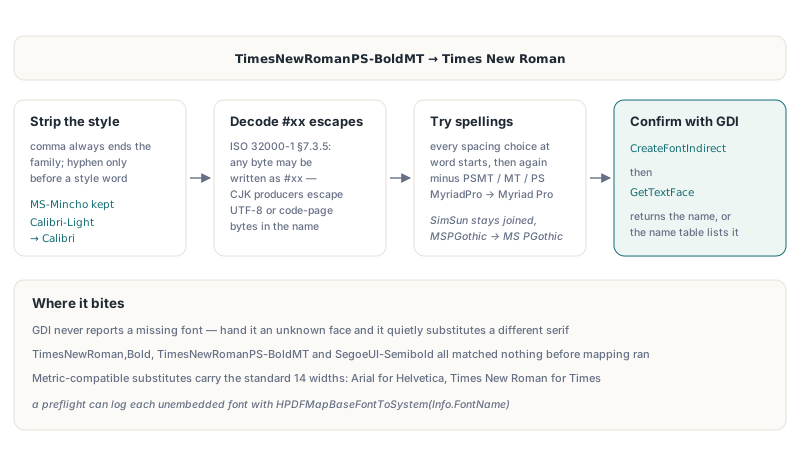
GDI는 없는 폰트를 보고한 적이 없습니다. 모르는 서체 이름을 CreateFontIndirect에 건네면 조용히 대체체를 고르는데, 흔히 bold 굵기 없는 다른 세리프입니다. 초기 렌더러는 PDF 이름을 거의 그대로 넘겼으므로, TimesNewRoman,Bold, TimesNewRomanPS-BoldMT, SegoeUI-Semibold는 전부 아무것도 매치하지 못하고 GDI가 고른 대로 나왔습니다. 이름은 그보다 더 나쁠 수 있습니다. ISO 32000-1 §7.3.5는 name이 임의의 바이트를 #xx로 쓰는 것을 허용하고, CJK 생산자는 폰트 이름을 이스케이프된 UTF-8이나 레거시 코드 페이지 바이트로 늘 적습니다. v2.766.69 전에는 그 이스케이프 자체가 서체 이름이 되었습니다. HPDFMapBaseFontToSystem은 이제 이스케이프를 먼저 디코딩하고, 유효한 UTF-8 바이트열은 문자로 반환하며, 그 외의 high 바이트는 시스템 코드 페이지로 읽습니다
스타일을 자르는 곳에서 휴리스틱이 물어 뜯습니다. 콤마는 항상 패밀리를 끝내지만(Arial,Bold는 Arial을 줌), 하이픈은 뒤의 단어가 스타일일 때만 그렇습니다. Bold, Italic, Oblique, Regular, Roman, Medium, Light, Black, Heavy, Semi, Demi, Thin, Extra, Ultra, Condensed 중 하나일 때입니다. 이 규칙은 Calibri-Light를 Calibri로 바꾸면서 MS-Mincho는 온전히 유지합니다. HotPDF는 그다음 패밀리의 철자들, 이어서 PSMT, MT, PS 접미사를 뗀 패밀리의 철자들을 시도합니다. v2.768.18부터 그 철자들은 단어가 시작될 수 있는 자리의 모든 공백 선택을 다룹니다. 소문자 뒤의 대문자 앞(MyriadPro는 Myriad Pro가 됨), 소문자가 뒤따르는 대문자 연쇄의 마지막 대문자에서(UIGothic), 선행 MS 뒤에서(MSPGothic), 완전 분리형부터 쓰인 그대로의 이름까지입니다. 그런 자리가 넷을 넘으면 완전 분리형과 붙인 이름만 시도됩니다. 공백을 맹목적으로 넣을 수는 없습니다. Windows는 일부 단어를 붙여 놓습니다. SimSun은 정확히 그 철자로 설치되어 있는 반면, MicrosoftYaHei, MicrosoftJhengHei, MSPGothic은 Microsoft YaHei, Microsoft JhengHei, MS PGothic에 속합니다. v2.768.18 전의 매퍼는 안쪽 대문자마다 공백을 넣었으므로, MicrosoftYaHei는 Microsoft Ya Hei로 조회되어 끝내 발견되지 않았습니다. 후보는 CreateFontIndirect 뒤의 GetTextFace가 요청한 이름을 반환할 때 설치된 것으로 칩니다. v2.768.18부터는 선택된 폰트의 name 테이블이 그것을 임의 언어의 family, full 또는 typographic family 이름으로 나열할 때도 그렇습니다. 답은 이름별로 캐시되므로, 설치되지 않은 폰트가 많은 문서가 매 페이지마다 각 이름으로 Windows를 헤집는 일은 없습니다
매핑 함수는 HPDFRenderFontMetrics 유닛에서 공개되어 있으므로, 프리플라이트 리포트는 THotPDF가 불러온 문서용으로 이미 노출하는 폰트 열거를 써서 각 비임베드 폰트가 어떤 설치된 패밀리로 렌더링될지 보여 줄 수 있습니다:
uses
  HPDFDoc, HPDFRenderFontMetrics;

procedure ListSystemFontMappings(Pdf: THotPDF; Log: TStrings);
var
  Page, I: Integer;
  Info: THPDFLoadedFontInfo;
begin
  for Page := 0 to Pdf.LoadedPageCount - 1 do
    for I := 0 to Pdf.GetLoadedFontCount(Page) - 1 do
      if Pdf.GetLoadedFontInfo(Page, I, Info) and not Info.IsEmbedded then
        Log.Add(Format('page %d  /%s  %s -> %s',
          [Page + 1, string(Info.ResourceName), string(Info.FontName),
           HPDFMapBaseFontToSystem(Info.FontName)]));
end;
HotPDF는 /Widths가 없는 standard 14 폰트를 어떻게 재나?
HotPDF는 빠진 어드밴스를 같은 메트릭을 가진 설치된 폰트에서 잽니다. ISO 32000-1 §9.6.2.2가 standard 14 폰트가 /Widths를 생략하는 것을 허용하고 라이브러리는 AFM 테이블을 실어 나르지 않기 때문입니다. Arial은 Helvetica 메트릭을, Times New Roman은 Times를, Courier New는 Courier를 실으므로, HPDFMeasureBaseFontWidths는 lfHeight = -1000으로 맞는 서체를 만들고 GetCharWidth32W를 부릅니다. 그 높이에서 결과는 이미 PDF 너비가 쓰는 1/1000 em 유닛입니다. 렌더러는 먼저 각 코드를 /Encoding, /BaseEncoding, /Differences를 거쳐 Unicode로 바꾸며, 디폴트는 StandardEncoding입니다. SVG 내보내기와 텍스트 추출에는 함정이 하나 더 있었습니다. /Encoding이 아예 없는 standard Type 1 폰트는 인코딩 정보가 없는 디코더를 만들어 SVG 내보내기는 그것을 등록하지 않았고, 잰 너비는 전부 쓰이지 않았습니다. 암묵적인 StandardEncoding을 공급하면 고쳐지는데, 미리 정의된 인코딩으로 표시되어야 합니다. CMap 이름 경로로 돌리면 모든 코드가 0으로 디코딩되고 모든 너비가 그 뒤를 따릅니다
Bold, italic, 그리고 폰트 디스크립터 플래그의 off-by-one
폰트 디스크립터의 /Flags 엔트리는 비트를 0이 아니라 1부터 번호 매기므로, ISO 32000-1 Table 123에 따르면 ForceBold는 비트 19($40000), Italic은 비트 7($40)입니다. 옛 코드는 비트 18인 SmallCap인 $20000을 검사했습니다. 이 실수는 v2.345.0에서 v2.766.53까지 살아남았습니다. /FontDescriptor는 거의 항상 간접 참조인데 폰트 빌더는 직접 오브젝트만 읽었으니, 플래그 분기 전체가 한 번도 돌지 않았고, 같은 실명은 /Widths 12 0 R을 무시해 텍스트를 500유닛 폴백 어드밴스로 배치했습니다. v2.766.53이 간접 참조를 렌더러를 통해 해석하기 시작하자 비트는 같은 변경에서 고쳐져야 했습니다. 그렇지 않으면 모든 small-caps 서체가 갑자기 bold로 렌더링되었을 테니까요:
const
  // ISO 32000-1 Table 123은 비트 위치를 1부터 셈
  FD_ITALIC     = $00040;  // bit 7
  FD_SMALLCAP   = $20000;  // bit 18, 굵기 아님
  FD_FORCEBOLD  = $40000;  // bit 19

procedure ApplyDescriptorFlags(Flags: Integer; var LF: TLogFont);
begin
  if (Flags and FD_FORCEBOLD) <> 0 then
    LF.lfWeight := FW_BOLD;
  if (Flags and FD_ITALIC) <> 0 then
    LF.lfItalic := 1;
end;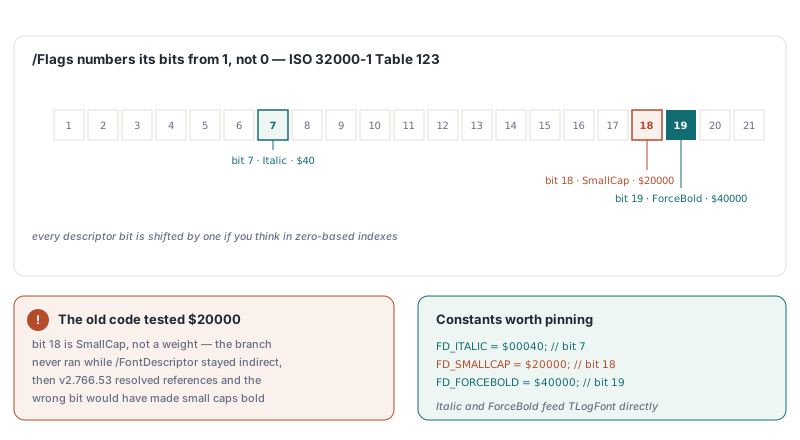
UCS2 CMap을 가진 CJK 폰트는 왜 너비가 틀릴까?
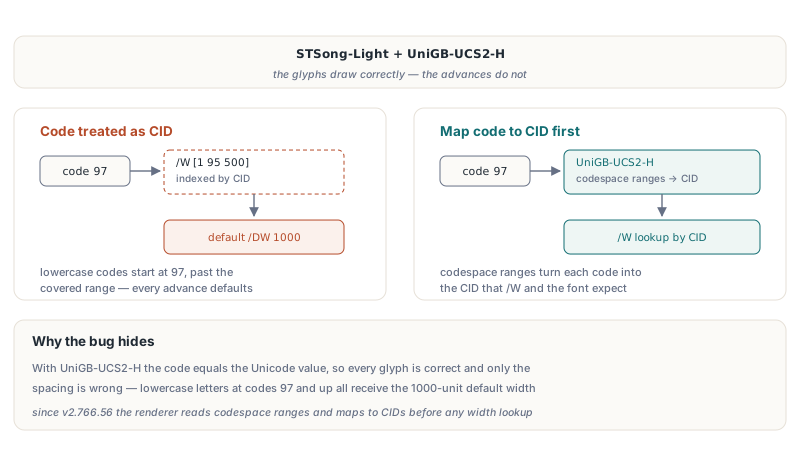
미리 정의된 UCS2 CMap을 가진 CJK 텍스트는 렌더러가 코드를 CID로 다룰 때 올바른 글리프를 엉뚱한 간격으로 그립니다. /W는 문자 코드가 아니라 CID로 인덱스되기 때문입니다. STSong-Light와 UniGB-UCS2-H에서는 코드가 우연히 Unicode 값과 같아 GDI가 올바른 문자를 그리고 버그는 어드밴스에 숩니다. 소문자는 코드 97 이상으로 도착해 [1 95 500] 같은 /W 엔트리 밖으로 빠지고, 전부 디폴트 너비 /DW 1000을 받습니다. v2.766.56부터 HotPDF 렌더러는 코드를 CMap codespace 범위(ISO 32000-1 §9.7.6.2)로 읽고 너비를 조회하기 전에 CID로 매핑합니다. 내장 UCS2와 UTF16 테이블, 임베드된 CMap 스트림만 쓰입니다. GBK-EUC-H 같은 것에 대한 identity 근사는 틀린 출력을 내면서 지원되는 것처럼만 보일 테니, 렌더러는 흉내를 내지 않습니다
중국어 Windows에서 악센트 문자가 왜 물음표로 변할까?
1바이트 코드는 절대 ANSI("A") GDI 함수에 닿아서는 안 됩니다. GetGlyphOutlineA와 GetGlyphIndicesA는 바이트를 시스템 코드 페이지로 해석하는 반면 TextOutA는 선택된 폰트 문자 집합을 쓰기 때문입니다. 중국어 시스템에서 Arial 바이트 $A9(Windows-1252의 저작권 기호)는 GBK 리드 바이트가 되어 "?"로 렌더링되었고, v2.766.83에 추가된 언힌트 아웃라인 경로가 그 함정에 곧장 빠졌습니다. v2.767.3은 GetTextCharset으로 구현된 폰트의 문자 집합을 물어, TranslateCharsetInfo로 코드 페이지로 바꾸고, 바이트를 MultiByteToWideChar에 통과시켜 W 함수를 부릅니다. 심볼 폰트는 대신 U+F000에 코드를 더해 씁니다. Windows-1252와 어긋나는 인코딩, 그러니까 /Differences, StandardEncoding, MacRomanEncoding은 어떤 시스템 폰트가 보기 전에 Unicode로 매핑됩니다
시스템 폰트로 그리기의 한계는?
시스템 폰트 렌더링은 근사이고, HotPDF 컴포넌트는 어디서 멈추는지 정직합니다. v2.768.18 전의 설치 검사는 GetTextFace가 반환하는 이름만 비교했는데, 지역화된 Windows에서 그 함수는 패밀리 이름을 시스템 언어로 보고합니다. 그래서 중국어 Windows의 Microsoft YaHei나 일본어 Windows의 Yu Mincho는 없는 것으로 판정되어 GDI 대체체로 그려졌습니다. v2.768.18부터 다른 이름으로 돌아오는 서체도 폰트의 name 테이블에서 조회되고, 그런 폰트는 발견됩니다. 메트릭 호환은 Helvetica, Times, Courier 패밀리에만 보장됩니다. Symbol은 Symbol로, ZapfDingbats는 Wingdings로 매핑되는데, 이는 매치가 아니라 임시방편입니다. 위의 프리플라이트는 각 페이지의 /Resources 딕셔너리 안의 폰트만 보며, form XObject 안쪽에서 참조되는 폰트는 보지 않습니다. 코드를 여전히 그릴 수 없을 때 그리기 시점 미해결 glyph 추적이 보고하는데, 썸네일을 눈으로 대는 것보다 나은 신호입니다
지속적인 수정은 저작 쪽에 있습니다. HotPDF 자신은 FontEmbedding이 디폴트로 True인 채 쓰므로, 코드가 Helvetica로 SetFont를 불러도 임베드된 Arial을 대신 넣고, 임베드된 텍스트는 위의 어떤 추측도 거치지 않고 임베드 폰트 glyph 렌더러로 갑니다. 들어오는 파일을 위한 값싼 가드는 매핑된 패밀리가 스크린 폰트 목록에 없으면 렌더링 전에 경고하는 것입니다:
// VCL: Screen.Fonts는 설치된 패밀리 이름을 나열(Forms 유닛)
function MissingSystemFamily(const BaseFont: AnsiString): Boolean;
begin
  Result := Screen.Fonts.IndexOf(HPDFMapBaseFontToSystem(BaseFont)) < 0;
end;
페이지 렌더링, 텍스트 추출, 쓰기 쪽의 폰트 서브셋팅을 포함한 전체 컴포넌트는 HotPDF Delphi PDF component 제품 페이지를 보세요