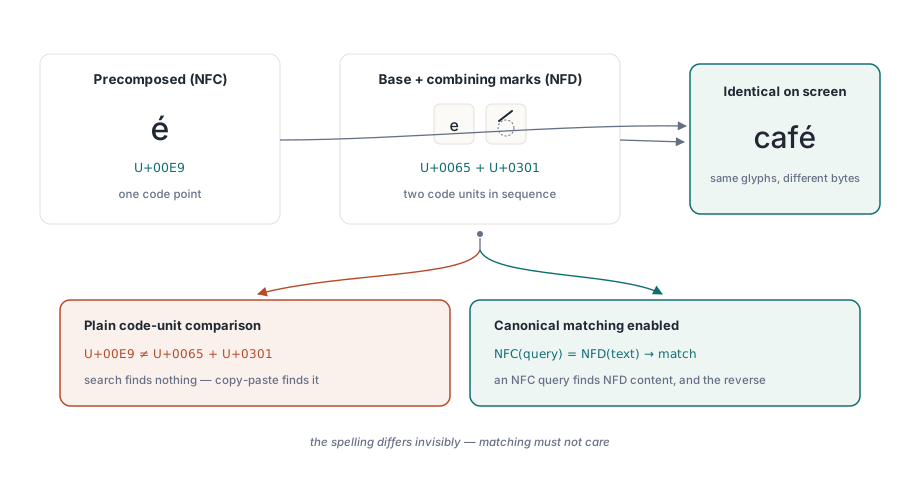
사용자가 검색 상자에 Müller를 입력하고 아무것도 얻지 못한 뒤, PDF에서 같은 이름을 복사해 상자에 다시 붙여 넣으면 갑자기 히트가 나옵니다. 두 문자열을 디버거에서 확인하면 Length가 입력한 쪽은 6, 붙여 넣은 쪽은 7을 돌려줍니다. 입력된 단어는 단일 사전 합성 ü인 U+00FC를 담고, 문서는 평범한 u 뒤에 U+0308 COMBINING DIAERESIS를 저장합니다. 둘은 같은 글리프로 렌더링되지만 코드 단위 비교는 결코 같다고 말하지 않습니다
똑같아 보이는 문자열이 왜 같지 않다고 비교되는가?
유니코드는 같은 추상 문자에 대해 하나 이상의 인코딩을 의도적으로 허용하고 그 인코딩들을 정준 동치(canonical equivalent)라고 부릅니다. 유니코드 표준 부록 #15는 검색에 관련된 두 정규 형식을 정의합니다. 사전 합성 코드 포인트를 선호하는 NFC과, 모든 사전 합성 문자를 기본 글자와 그 결합 기호들로 고정된 순서로 갈라놓는 NFD입니다. 발음 기호를 단 라틴 문자는 두 형태 모두로 존재하고, 한글 음절도 마찬가지입니다. 하나의 사전 합성 음절로 나타나거나 둘 또는 셋의 조합용 자모 열로 나타날 수 있습니다
어느 형태가 PDF에 들어가는지는 그것을 만든 소프트웨어와 실행된 플랫폼, 때로는 폰트의 ToUnicode 맵이 어떻게 만들어졌는지에 달려 있습니다. 한 머신에서 입력되고 다른 머신에서 편집된 문서는 같은 페이지에 두 형태를 섞어 둘 수 있습니다. 검색하는 사람에게는 그 어떤 것도 보이지 않습니다. 키보드와 입력기는 보통 NFC를 만들어 내므로, 파일 속의 분해된 콘텐츠는 그 사람 쪽에서 검색 불가능한 것이 됩니다
자명한 편법은 이 문제를 대소문자 통합과 같은 바구니에 던져 넣는 것입니다. 양쪽을 소문자로 만들고 발음 기호를 벗겨 비교하는 것이죠. 구조적인 이유로 그것은 깨집니다. 대소문자 통합과 발음 기호 제거는 코드 단위 수준에서 일대일이므로, 변환된 텍스트는 원본과 길이가 정확히 같고 변환본의 17번 위치에서의 매치는 추출 텍스트의 17번 위치에서의 매치입니다. 정규화는 길이를 바꿉니다. 사전 합성 문자 하나는 둘이나 셋의 코드 단위가 되고, 분해된 열은 다시 하나로 접히며, 한글 음절은 자모로 늘어납니다. 그 변환 뒤에 돌아오는 위치들은 더 이상 여러분이 추출한 텍스트를 가리키지 않습니다
PDF Library for Delphi에서 soCanonicalEquivalent로 검색하기
PDF Library for Delphi에서 TPDFlibSearchOptions의 soCanonicalEquivalent 멤버는 SearchText가 쿼리와 페이지 텍스트의 정준 분해를 비교하게 만들어, NFC 쿼리가 NFD 콘텐츠를, NFD 쿼리가 NFC 콘텐츠를 찾게 합니다. 이 옵션은 집합의 일원이므로 별도의 API 없이 soWholeWord, soCaseSensitive, soWildcards, soDiacriticInsensitive와 조합됩니다:
uses
  SysUtils, Math, PDFlibrary;

var
  Lib: TPDFlib;
  Hits: array of TPDFlibSearchHit;
  Found, Stored, I: Integer;
  Slice: WideString;
begin
  Lib := TPDFlib.Create;
  try
    Lib.LoadFromFile('contracts.pdf', '');
    Lib.SearchContextChars := 24;      // ContextBefore / ContextAfter를 채웁니다
    SetLength(Hits, 500);

    Found := Lib.SearchText('Bäcker',
      [soCanonicalEquivalent, soWholeWord, soGraphemeClusters],
      '', Hits);                       // 빈 페이지 범위 = 모든 페이지

    // Found는 모든 히트를 세며, 처음 Length(Hits)개만 복사되었습니다
    Stored := Min(Found, Length(Hits));
    for I := 0 to Stored - 1 do
    begin
      Slice := Copy(Hits[I].MatchText, Hits[I].MatchStart,
        Hits[I].MatchLength);
      Writeln(Format('page %d: [%s] %d code units, ...%s|%s|%s...',
        [Hits[I].Page, Slice, Hits[I].MatchLength,
         Hits[I].ContextBefore, Slice, Hits[I].ContextAfter]));
    end;
  finally
    Lib.Free;
  end;
end;
그 루프에는 사람들이 걸려 넘어지는 디테일이 둘 있습니다. SearchText는 버퍼가 더 작아도 히트 총수를 돌려주므로, 큰 문서에서 Found - 1까지 반복하면 500짜리 배열의 끝을 지나쳐 걸어 나갑니다. Min으로 잘라 내거나, 각 히트를 콜백에 넘겨 주고 버퍼 자체가 필요 없는 SearchTextEach로 옮겨 가세요. 그리고 MatchText는 매치를 담은 텍스트 블록 전체이며 MatchStart는 그 안의 1 기반 인덱스이므로, 매치된 단어 자체는 위에 보인 Copy입니다
Bäcker를 분해된 형태로 저장하는 파일에 돌리면 출력되는 길이는 7이고 NFC 파일에서는 6입니다. 같은 쿼리, 같은 옵션 집합입니다. 슬라이스는 언제나 문서에 앉아 있는 그대로의 텍스트입니다
히트는 원본 텍스트의 어디에 떨어지는가
정규화된 검색을 예/아니오 이상의 용도에 쓸 수 있게 만드는 것이 바로 마지막 성질입니다. PDF Library for Delphi는 정규화기가 만들어 내는 모든 코드 단위에 대해 그것이 나온 원본 UTF-16 범위의 시작과 끝을 기록합니다. 재귀적 분해는 부모의 범위를 물려받고, 합성은 입력들의 범위를 합치며, 매치가 발견되면 검색은 사상된 구간에서 가장 작은 시작과 가장 큰 끝을 훑습니다
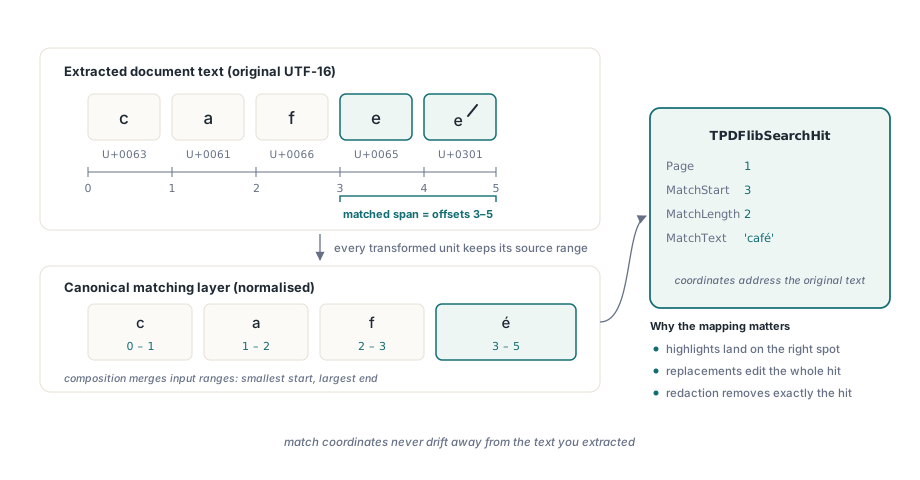
그 결과 MatchStart, MatchLength, ContextBefore, ContextAfter, 그리고 두 교체 진입점은 호출자가 이미 갖고 있는 추출 텍스트를 주소합니다. "이 블록 안에 히트가 있다"고만 말하고 정확히 어디인지 말하지 못하는 검색은 결과 개수로는 쓸 만하지만 그 외의 모든 것에 틀립니다. 하이라이트는 발음 기호 글자마다 한두 글자씩 표류하고, 교체는 엉뚱한 텍스트 구간을 다시 씁니다
정규화기는 라이브러리 안에 실려 옵니다. Unicode 15.1의 정준 분해와 합성, 정준 결합 클래스에 대한 컴팩트한 테이블을 갖고 있고, 한글에는 테이블 항목 대신 알고리즘 규칙을 적용하며, NFD 동안 결합 기호들을 안정적으로 재배열합니다. 외부 데이터 파일을 로드하지 않고 운영체제의 정규화 호출도 하지 않으므로, Windows 서비스와 Linux 데몬, Free Pascal 빌드가 같은 파일에 대해 동일한 히트를 돌려줍니다. Windows에서는 OS가 그 일을 해 줄 수 있음에도 우리는 이 방식을 선호합니다. 한 서버에서 만들어진 검색 색인이 다른 서버에서 조회될 때, 두 머신이 서로 다른 유니코드 버전을 돌린다는 이유로 어긋나서는 안 되기 때문입니다
옵션은 기본적으로 꺼져 있고 그 기본값은 합리적입니다. NFD 텍스트와 위치 맵을 만드는 데는 시간이 들고, ASCII뿐인 인보이스를 향한 검색은 결코 그것을 필요로 하지 않습니다. soCanonicalEquivalent가 설정되면 각 텍스트 블록은 변환된 사본 두 개, 결합 기호를 남긴 것과 남기지 않은 것을 유지하므로, 같은 블록을 향한 배치 쿼리는 정규화를 한 번만 치릅니다. 평범한 대소문자 통합은 더 값싼 일대일 경로에 머뭅니다
히트가 문자 한가운데서 끝나면 무엇이 잘못되는가
정준 동치는 "이것이 같은 텍스트인가"에는 답하지만 히트가 어디서 멈추어도 되는지에 대해서는 아무 말도 하지 않습니다. 분해된 café를 soCanonicalEquivalent만으로 cafe로 검색하면 처음 네 코드 단위가 일치하고, 뒤따르는 결합 악센트는 히트 바깥에 남습니다. soWholeWord는 이를 잡지 못합니다. 그 단어 문자들은 식별자 규칙(ASCII 글자, 숫자, 밑줄)을 따르고 결합 기호는 경계로 셉니다. 하이라이트는 cafe를 덮고, 교체는 그다음에 오는 무엇 위에 떠 있는 흘러나온 악센트를 남깁니다
같은 일이 라틴 악센트를 훨씬 넘어서 일어납니다. 깃발 이모지는 지역 표시 코드 포인트 두 개입니다. 가족 이모지는 폭 없는 결합자(ZWJ)로 이어진 여러 사람입니다. 데바나가리 결합 문자는 자음과 비라마, 또 다른 자음이고, 베트남어 모음은 브레브나 곡절을 이미 얹고 있던 것 위에 성조 기호를 얹을 수 있습니다. 기본 다국어 평면 밖의 것은 UTF-16에서 서러게이트 쌍이며, 그것을 반토막 내면 수많은 텍스트 파이프라인이 U+FFFD로 바꿔 버리는 짝 없는 서러게이트가 만들어집니다
soGraphemeClusters는 모든 히트의 양 끝이, literal이든 와일드카드든, 유니코드 표준 부록 #29가 정의한 확장 그래핌 클러스터 경계 위에 떨어지도록 요구합니다. 이 세분화는 CR/LF 짝짓기와 제어 문자, 한글 음절 타입, Extend와 SpacingMark, Prepend, 이모지 ZWJ 열, 지역 표시 쌍, 인도어 결합 분리를 커버하며 서러게이트 쌍 안에 경계를 두지 않습니다. 플래그가 켜지면 cafe는 분해된 café와 더 이상 전혀 일치하지 않습니다. 악센트를 무시하는 매칭이 실제로 원하는 것이라면 soDiacriticInsensitive를 추가하세요
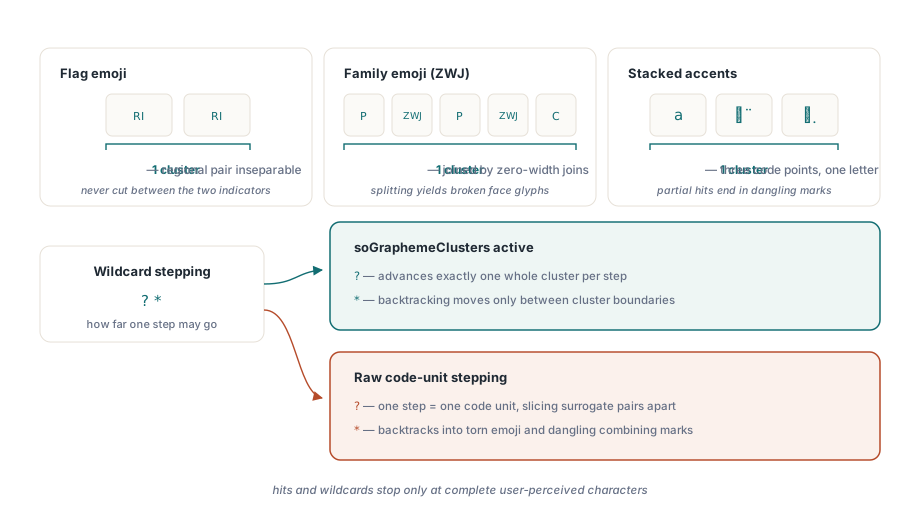
와일드카드가 그 플래그가 결과를 가장 눈에 띄게 바꾸는 자리입니다. soCanonicalEquivalent 아래에서는 페이지 텍스트가 NFD로 비교되므로 côté는 파일이 어떻게 저장했든 c o U+0302 t e U+0301이 됩니다. soGraphemeClusters가 없으면 c?té의 ?는 정확히 하나의 코드 단위, 그러니까 o를 먹고 t를 기대했다가 U+0302를 만납니다. 히트 없음. 플래그가 있으면 ?는 온전한 클러스터 하나를 전진하고 *의 백트래킹도 클러스터 경계 사이에서만 움직입니다:
// "?"는 사용자가 인식하는 문자 하나를 진행하므로 côté와 일치하고
// PDF가 사전 합성이든 분해든 그것을 저장했든 마찬가지입니다
Found := Lib.SearchText('c?té',
  [soWildcards, soCanonicalEquivalent, soGraphemeClusters], '', Hits);

// 교체는 같은 클러스터 안전 범위를 쓰므로 이모지를 반토막 내거나
// 고아가 된 악센트를 남겨 두는 일이 없습니다
Replaced := Lib.SearchAndReplaceTextInContent('naïve', 'plain',
  [soCanonicalEquivalent, soGraphemeClusters], '1-20');
if Replaced = 0 then
  Writeln(Lib.GetLastUnicodeReplacementDiagnostics)
else
Lib.SaveToFile('contracts-edited.pdf');SearchAndReplaceTextInContent는 페이지 콘텐츠 안의 텍스트를 다시 쓰고 교체한 매치 수를 돌려줍니다. 0을 돌려줄 때 GetLastUnicodeReplacementDiagnostics가 이유를 말해 줍니다. 예컨대 매치를 그것을 그린 콘텐츠로 되사상하지 못했다는 식입니다. 다른 진입점인 SearchAndReplaceText는 같은 옵션 집합을 받으며 교체를 매치된 블록 위에 그리는 방식으로 처리합니다
작업 부하별 옵션 집합 고르기
세 가지 조합이 대부분의 애플리케이션을 커버합니다. 문서 뷰어 안의 최종 사용자 검색 상자에는 soCanonicalEquivalent에 soDiacriticInsensitive를 더세요. 두 인코딩 형태가 모두 일치하고 악센트가 있는 철자와 없는 철자도 일치하는데, 수년간 웹 검색에 익숙해진 사람들이 기대하는 것이 바로 그것입니다. 오탐 한 번이 누군가의 오후를 통째로 삼키는 법무나 컴플라이언스 검토에는 soCanonicalEquivalent에 soCaseSensitive와 soWholeWord를 쓰고 악센트 통합은 꺼 두세요. 파일이 우연히 어떤 인코딩을 썼는지는 무시하면서 동치는 정확하게 유지됩니다
문서를 바꾸는 어떤 것이든 soGraphemeClusters를 매번 더하세요. 취향에 맡기지 않을 유일한 지점입니다. 한 코드 단위 짧은 범위를 돌려주는 검색은 결과를 읽는 사람을 오도할 뿐이지만, 같은 범위를 쓰는 교체나 제거는 그 실수를 파일에 기록하고 페이지가 인쇄되거나 다시 추출되기 전까지는 아무도 눈치채지 못합니다. 내용을 덮는 것이 아니라 파괴해야 하는 제거는 그 자체로 별개의 주제이며 진짜 레닥션과 콘텐츠 제거가 다룹니다
여러 용어가 같은 문서를 향할 때는 SearchTextBatch를 선호하세요. 페이지의 텍스트 블록이 메모리에 있는 동안 비어 있지 않은 모든 쿼리를 평가하므로, 각 페이지는 한 번만 추출되고 각 블록은 한 번만 정규화되며, 쿼리마다 자신의 옵션 집합을 갖습니다:
var
  Queries: array[0..2] of TPDFlibSearchQuery;
  BatchHits: array of TPDFlibSearchBatchHit;
  Count, I: Integer;
begin
  Queries[0].Query := 'Müller';
  Queries[0].Options := [soCanonicalEquivalent, soDiacriticInsensitive];
  Queries[1].Query := '서울';                // 한글: 파일에는 NFC이거나 자모일 수 있습니다
  Queries[1].Options := [soCanonicalEquivalent, soGraphemeClusters];
  Queries[2].Query := 'Nguyễn';
  Queries[2].Options := [soCanonicalEquivalent, soCaseSensitive,
    soWholeWord, soGraphemeClusters];

  SetLength(BatchHits, 2000);
  Count := Min(Lib.SearchTextBatch(Queries, '', BatchHits),
    Length(BatchHits));
  for I := 0 to Count - 1 do
    Writeln(Format('query %d -> page %d',
      [BatchHits[I].QueryIndex, BatchHits[I].Hit.Page]));
end;
히트는 페이지, 그다음 블록, 그다음 쿼리 순으로 돌아오며 QueryIndex는 넘긴 배열에서의 0 기반 위치입니다. 미리 크기를 정할 수 없는 결과 집합에는 콜백 형태의 SearchTextBatchEach가 있습니다. 텍스트 블록이 애초에 어떻게 추출되는지는 텍스트 검색과 페이지 요소 열거에 묘사되어 있습니다
정준 동치가 선택이 아닌 필수가 되는 문자 체계
한글에서는 정준 동치가 이름이 애초에 발견되는지를 결정합니다. 사전 합성 음절과 분해된 자모가 실제 문서에 모두 등장하기 때문입니다. 베트남어는 브레브나 곡절을 이미 얹고 있을 수 있는 모음 위에 성조 기호를 포개 놓으므로 합성 형태가 작성기에 전적으로 좌우됩니다. 데바나가리, 벵골어, 그 밖의 인도 계열 문자에서는 결합 규칙이 히트 경계가 독자가 알아볼 수 있는 자리에 떨어지는지를 결정합니다. 일본어와 중국어는 검색 쪽에서는 비교적 쉽지만 레이아웃 쪽은 그렇지 않으며, 일본어와 중국어의 세로쓰기가 이를 다룹니다
권하는 바는 뻣뻣합니다. 코퍼스에 영어 이외의 언어가 조금이라도 들어 있다면 soCanonicalEquivalent를 먼저 켜고, 여러분의 문서에서 시간을 재어 그 비용이 받아들일 수 없다는 결론이 나면 그때 끄세요. 그 옵션이 막아 주는 실패는 바로 사용자들이 가장 많이 검색하는 이름들 위에 떨어집니다
같은 유니코드 인식 엔진이 Delphi, C++Builder, Free Pascal에서 검색, 추출, 교체, 레닥션을 움직입니다. 옵션 집합과 배치 API, 텍스트 도구 모음의 나머지는 PDF Library for Delphi 제품 페이지에 정리되어 있습니다