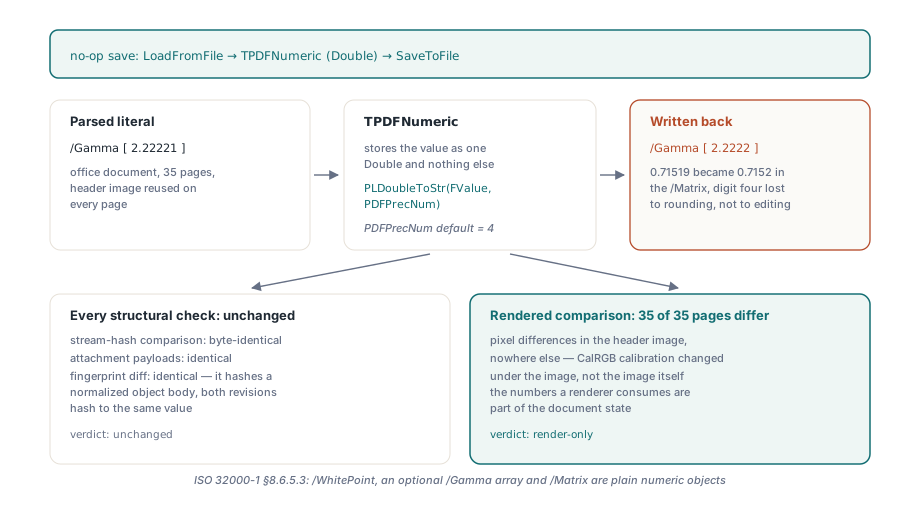
캘리브레이션된 PDF를 로드하고 아무것도 바꾸지 않은 채 새 이름으로 저장한 뒤 색 공간 딕셔너리를 diff해 보세요. /Gamma [2.22221 2.22221 2.22221]이 들어가서 /Gamma [2.2222 2.2222 2.2222]가 나옵니다. 라이터가 손댈 필요가 없던 숫자의 형식을 다시 잡아 버렸고, 페이지는 이제 아주 조금 다른 색으로 렌더링됩니다. 처방은 파싱한 모든 소수를 두 가지로 동시에 다루는 것입니다. 산술용 값이자 출력용 리터럴로요. 그리고 누군가 실제로 새 값을 대입하기 전까지는 리터럴을 계속 내보내는 것입니다
no-op 저장이 CalRGB 색을 움직일 수 있는 이유
픽셀이 움직이는 이유는 이미지 바이트는 그대로인데 렌더러에게 조금 다른 캘리브레이션 데이터가 건네지기 때문입니다. ISO 32000-1 §8.6.5.3은 CalRGB 색 공간을 필수 /WhitePoint, 선택적 세 원소 /Gamma 배열, 선택적 아홉 원소 /Matrix로 정의하며, 이들은 모두 색 공간 딕셔너리 안의 평범한 숫자 객체입니다. 이것들을 Double과 소수점 네 자리로 고정된 포매터에 통과시키면 2.22221은 2.2222가 되고 0.71519 행렬 원소는 0.7152가 됩니다. gamma 값은 그 공간을 통과하는 모든 픽셀의 모든 컴포넌트에 적용되는 지수이므로, 변화는 그 공간이 쓰이는 모든 곳에서 드러납니다
35페이지에 재사용되는 머리글 이미지를 위해 CalRGB 공간 하나를 선언한 파일이라면 35개 머리글 전부가 틀어진 색으로 렌더링되고 그 페이지들의 다른 것은 하나도 바뀌지 않습니다. 사람들이 먼저 떠올리는 검사들은 깨끗하게 통과합니다. 디코딩한 스트림 바이트의 해시는 이미지 데이터를 비교하는데, 이미지 데이터는 실제로 동일합니다. 손상은 딕셔너리 안에 있습니다. 수정 레벨 글이 설명하는 리비전 diff는 정규화된 객체 본문을 지문으로 삼으므로, 두 리비전은 거기서도 같은 값으로 해시됩니다. 이것을 잡는 것은 렌더링 비교입니다. 다른 소프트웨어가 만든 PDF를 다시 쓰는 모든 파이프라인이라면, 저희라면 페이지별 렌더 비교를 모든 구조 검사보다 앞에 두겠습니다
PDF 실수는 어떤 모습이 허용되나
ISO 32000-1 §7.3.3은 실수를 소수 문자열로 정의합니다. 선택적 부호, 숫자들, 마침점, 더 많은 숫자들입니다. 진법 표기는 없고 지수 형식도 없습니다. 구현 한계를 나열하는 Annex C는 소수부에서 대략 유효 십진 다섯 자리가 지켜질 것을 기대합니다. 따라서 기본 출력 정밀도 네 자리는 이미 스펙이 리더에게 지키라고 하는 것보다 한 자리 아래이고, 다섯 자리를 쓴 파일은 아무 잘못도 없습니다
0 근처에서 순진한 포매터는 자릿수 손실보다 나쁜 짓을 합니다. Double을 N자리로 찍는 흔한 방법은 10^N을 곱해 정수로 반올림한 뒤 자릿수를 쓰는 것인데, 그 정수가 0이면 출력도 0입니다. 여기에 0.00001 0 0 1 0 0 cm의 첫 피연산자를 네 자리로 넘기면 결과는 0 0 0 1 0 0 cm, 즉 그 아래 그려지는 모든 것을 사라지게 만드는 특이 행렬입니다. /Matrix 원소 -0.000012345도 같은 길을 갑니다
Delphi용 PDF Library(PDFlibPas)가 Double을 직접 포맷해야 할 때는 정밀도 단계보다 작은 0이 아닌 값에 대해 0을 쓰는 대신 요청된 유효 숫자 개수를 지킵니다. 네 자리에서 0.00001은 0.00001로, 0.0000123은 0.0000123으로 쓰이고, 대략 5E-16보다 작은 크기만 여전히 0으로 나옵니다. 새로 쓰는 숫자가 정상을 유지하는 장치입니다. 재포맷이 필요 없던 파싱 숫자는 다른 문제고, 라이브러리의 답은 아예 재포맷하지 않는 것입니다
PDFlibPas가 파싱한 리터럴을 지키는 방법
TPDFStructure.Decode는 토큰화하는 모든 표준 실수, 즉 소수점이 있고 지수 표시가 없는 토큰의 소스 텍스트를 변환된 Double 바로 옆에 보관합니다. TPDFNumeric.Output은 그 텍스트가 있으면 언제든 되쓰고, 없을 때만 Double을 구조체의 PDFPrecNum으로 포맷합니다. TPDFNumeric.SetTo는 텍스트를 버립니다. 편집된 숫자는 새 숫자이고 현재 출력 정밀도를 따라야 하기 때문입니다
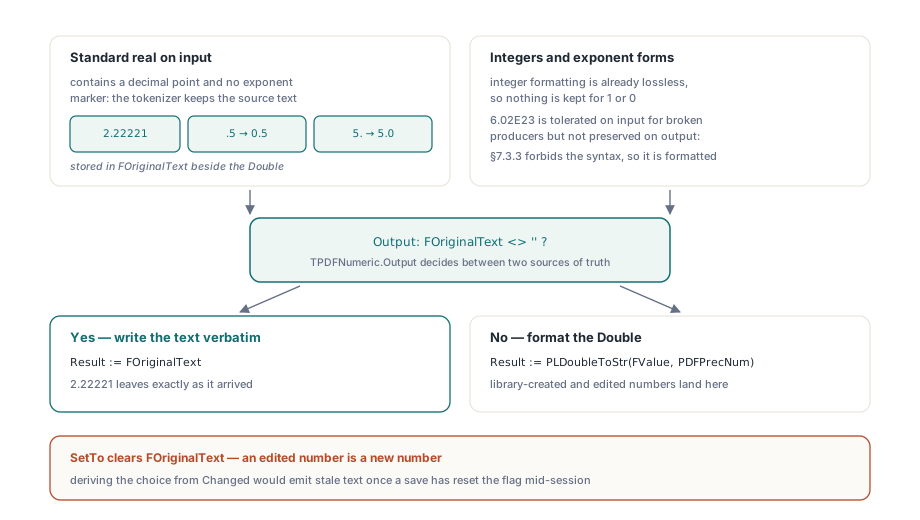
리셋을 SetTo에 묶은 것은 의도적입니다. 유혹적인 지름길은 객체의 Changed 플래그가 서 있지 않으면 원본 텍스트를 내보내는 것인데, 그 플래그는 모든 객체에 이미 있습니다. 하지만 저장 파이프라인은 객체를 쓰고 나면 Changed를 지우므로, 같은 세션에서 편집, 저장, 재편집된 값은 두 번째 저장에서 낡은 리터럴을 다시 내보내기 시작합니다. 텍스트를 대입 자체 안에서 비우면 리터럴과 값이 어긋날 수 없습니다
경계 몇 개는 의도적입니다. 정수는 텍스트로 보관하지 않습니다. 정수 포맷은 이미 무손실이기 때문입니다. 6.02E23 같은 지수 형식은 어차피 그렇게 쓰는 생산자를 위해 입력에서는 받아들이지만, 되쓰면 §7.3.3이 배제하는 문법을 영원히 이어지게 하므로 출력에서는 다른 라이브러리 생성 숫자처럼 포맷됩니다. 토크나이저는 텍스트를 보관하기 전에 늘 하던 작은 보정도 적용합니다. .5 같은 선행 점 리터럴은 0.5로, 5. 같은 후행 점 리터럴은 5.0으로 보관합니다. 모든 리더가 각 쌍을 같은 숫자로 취급하고, 보정된 표기가 훨씬 넓게 받아들여집니다
아래 스니펫은 CalRGB 값들을 PDF 파일을 열지 않고도 규칙 하나하나를 볼 수 있게 객체 레이어로 바로 돌립니다. Assert 줄은 여러분 테스트에 추가하길 권하는 검사이지, 라이브러리로의 호출이 아닙니다
uses
  PDFlibStruct;

var
  Structure: TPDFStructure;
  Values: TPDFArray;
  Number: TPDFNumeric;
begin
  Structure := TPDFStructure.Create;
  try
    Structure.PDFPrecNum := 4;
    Values := TPDFArray(Structure.Decode('[2.22221 0.71519 -0.000012345 1 0.12567]'));

    // 자작 검사: 편집하지 않은 입력은 그대로 살아남는다. 순진한 네 자리
    // 포매터가 0으로 뭉개버렸을 값까지 포함해
    Assert(Values.Output = '[ 2.22221 0.71519 -0.000012345 1 0.12567 ]');

    // 편집하면 원본 텍스트를 버리고 PDFPrecNum을 따른다
    Number := TPDFNumeric(Values.Item[0]);
    Number.SetTo(0.123456);
    Assert(Number.Output = '0.1235');
    Assert(Structure.NewNumeric(0.123456).Output = '0.1235');

    // 아주 작은 새 값은 0이 되는 대신 유효 숫자를 지킨다
    Assert(Structure.NewNumeric(0.0000123).Output = '0.0000123');

    // 나중에 정밀도를 낮춰도 편집하지 않은 입력에는 닿지 않는다
    Structure.PDFPrecNum := 2;
    Assert(TPDFNumeric(Values.Item[1]).Output = '0.71519');
  finally
    Structure.Free;
  end;
end;
이런 assertion을 쓸 때의 함정 하나: Delphi의 Round는 banker's rounding을 쓰고, 0.000012345 * 1e8은 1234.5가 아니라 2진수로 1234.4999…로 평가됩니다. 저희도 near-zero 포맷 경로를 검사하다 그 값을 정면으로 만났습니다. assertion이 마지막 자리의 반올림에 의존한다면 2진수 중간값이 아닌 테스트 입력을 고르세요
SetPrecision은 무엇을 제어하나
TPDFlib.SetPrecision은 라이브러리가 쓰는 숫자의 소수 자릿수를 정합니다. 페인터로 그려지는 그래픽, NewNumeric처럼 Double에서 만들어지는 숫자, 그리고 이후 SetTo로 바뀐 파싱 값들이 대상입니다. 2부터 8까지 받고 그 밖의 값에는 0을 반환합니다. 아무도 편집하지 않은 파싱 소수는 설정이 무엇이든 입력 텍스트를 유지하고, LoadFromFile 뒤에 설정을 바꿔도 소급되지 않습니다. SetObjectFromString에 넘긴 소스도 같은 토크나이저를 거치며 같은 방식으로 보관됩니다
권하자면 생성하는 기하가 더 촘촘한 단계를 필요로 하지 않는 한 SetPrecision은 그대로 두는 것입니다. 입력 파일을 보호하려고 올리는 것은 아무 이득이 없습니다. 손대지 않은 입력은 이미 자기 자릿수를 지키고, 대신 그리는 모든 숫자가 길어질 뿐입니다. 서브포인트 드로잉 작업에는 다섯 자리가 합리적이고, 여덟은 대개 콘텐츠 스트림만 부풀립니다
uses
  PDFlibrary;

var
  PDF: TPDFlib;
begin
  PDF := TPDFlib.Create;
  try
    if PDF.LoadFromFile('calibrated.pdf', '') <> 1 then
      Exit;

    // 여기서부터 쓰이는 숫자를 제어한다; 파싱한 /Gamma,
    // /Matrix, /WhitePoint 배열은 원본 텍스트를 유지한다
    PDF.SetPrecision(5);

    PDF.SelectPage(1);
    PDF.SetLineWidth(0.123456);       // 그려지는 숫자는 다섯 자리 사용
    PDF.DrawLine(72, 72, 300, 72);

    PDF.SaveToFile('calibrated-out.pdf');
  finally
    PDF.Free;
  end;
end;
콘텐츠 스트림: 편집은 오퍼랜드를 유지, 정규화는 옵트인
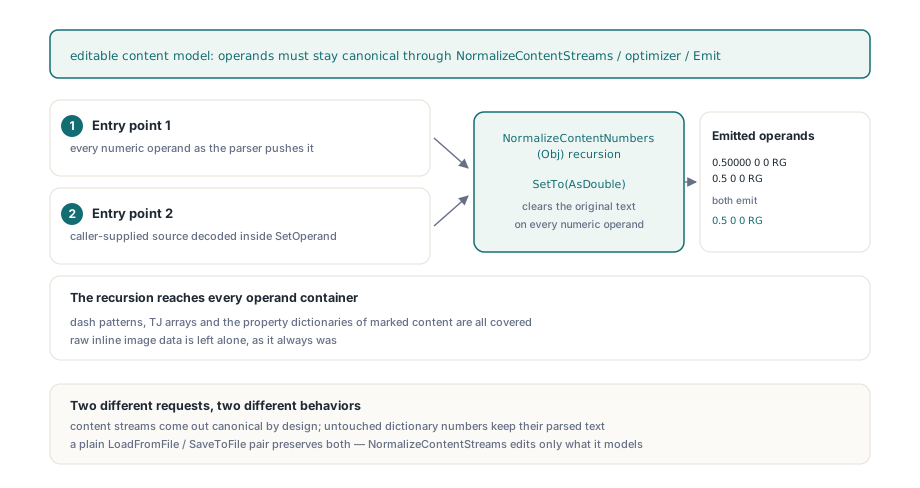
편집 가능한 콘텐츠 모델은 기본적으로 오퍼랜드 텍스트를 유지하고, 정규 출력이 그 호출의 목적인 경우에만 숫자를 정규화합니다. TPDFContentProgram.CanonicalNumbers의 기본값은 False라서, 그래픽 상태 트래커가 세워진 것과 같은 모델인 ParsePageContentLayer가 돌려주는 레이어는 손대지 않은 모든 숫자 오퍼랜드를 쓰인 그대로 재출력합니다. ScalePage, TransformPageElement, DeletePageElement, RedactRegion, ConvertTextToPaths, 그리고 여러분 프로그램을 WritePageContentLayer로 되쓰는 것을 포함해 레이어 전체를 다시 쓰는 페이지 편집도 편집이 만진 오퍼랜드만 바꿉니다
다른 쪽 기본값이 더 깔끔해 보입니다. 파싱할 때마다 정규화해서 편집 경로와 NormalizeContentStreams가 항상 같은 표기를 내놓는 방식이죠. 편집용으로는 잘못된 기본값이라고 생각합니다. 0.123456 w를 담은 레이어에 ScalePage를 호출하면 0.1235 w로 되쓰이고, 호출자가 스케일만 요청했는데도 레이어의 다른 모든 오퍼랜드가 재작성됩니다. 정규 형태는 비교 가능한 출력이 목적인 연산의 소유입니다
그런 연산은 여전히 그것을 받습니다. NormalizeContentStreams와 저장 시점 콘텐츠 옵티마이저는 CanonicalNumbers를 True로 두고 파싱합니다. 임의의 입력에서 안정적인 출력을 내는 것이 임무이기 때문입니다. 0.50000 0 0 RG와 0.5 0 0 RG가 다르게 출력되면 모든 하류 비교가 생산자의 포맷 습관을 따라 흔들릴 겁니다. 정규화는 배열과 딕셔너리를 재귀하므로 dash 패턴, TJ 배열, marked-content 속성 딕셔너리까지 커버되고, raw 인라인 이미지 데이터는 그대로 둡니다. SetOperand로 공급된 오퍼랜드는 플래그와 무관하게 정규화됩니다. 콘텐츠 프로그램은 SetPrecision과 무관하게 소수점 네 자리로 고정된 자체 숫자 저장소를 지니므로, 편집된 오퍼랜드는 네 자리로 나옵니다. 플래그를 읽는 곳은 Parse뿐이므로 파싱 전에 설정해야 하고, ParsePageContentLayer가 이미 파싱한 프로그램이라면 플래그를 설정한 뒤 Parse(Emit)을 호출하세요
uses
  PDFlibrary, PDFlibContentModel, PDFlibContentOps;

var
  PDF: TPDFlib;
  Prog: TPDFContentProgram;
  I: Integer;
begin
  PDF := TPDFlib.Create;
  try
    if PDF.LoadFromFile('calibrated.pdf', '') <> 1 then
      Exit;
    PDF.SelectPage(1);
    Prog := PDF.ParsePageContentLayer(1);
    if Prog = nil then
      Exit;
    try
      // 선 하나의 폭을 바꾼다; 다른 모든 오퍼랜드는 소스 텍스트를 유지한다
      I := Prog.FindNextOp(0, coLineWidth);
      if I >= 0 then
        Prog.SetOperand(I, 0, '0.123456');   // 0.1235로 출력됨
      PDF.WritePageContentLayer(1, Prog);

      // 비교용 정규 사본일 뿐, 되쓰지 않는다:
      // 플래그를 읽는 곳은 Parse뿐이므로 설정 후 재파싱한다
      Prog.CanonicalNumbers := True;
      Prog.Parse(Prog.Emit);
      // 이제 Prog.Emit은 0.50000과 0.5를 같은 식으로 쓴다
    finally
      Prog.Free;
    end;
    PDF.SaveToFile('calibrated-out.pdf');
  finally
    PDF.Free;
  end;
end;
종합하면 호출자를 위한 규칙은 짧습니다. 평범한 LoadFromFile 뒤의 SaveToFile은 손대지 않은 콘텐츠 스트림과 딕셔너리 숫자를 원래 그대로 남깁니다. 콘텐츠 모델을 거쳐 편집한 페이지는 편집이 바꾸지 않은 모든 오퍼랜드의 텍스트를 유지합니다. NormalizeContentStreams, 저장 시 콘텐츠를 압축할 때 도는 옵티마이저, 그리고 CanonicalNumbers를 True로 두고 파싱한 프로그램은 설계대로 정규 숫자를 만들고, 문서의 나머지는 여전히 보존됩니다
그 대가와 보장이 멈추는 지점
TPDFNumeric마다 AnsiString 참조가 하나 더 들고, 파싱한 모든 소수는 객체가 사는 동안 소스 텍스트를 살려 둡니다. 실수가 수백만 개인 문서에서는 측정 가능한 메모리이므로, 돌리는 대용량 문서 벤치마크에 들어가야 할 항목입니다. 보장은 또한 숫자가 속한 문서로 범위가 한정됩니다. 문서 간 객체 복사나 객체 API를 통한 값 재구축은 새 숫자를 만들고, 새 숫자는 출력 정밀도를 따릅니다
보존된 숫자와 바이트 단위 동일 출력은 별개의 속성입니다. 손대지 않은 문서의 로드-저장은 렌더러가 소비하는 캘리브레이션 숫자를 지키지만, 바이트 동일성은 객체 번호 매기기, 스트림 압축, 결정적 PDF ID 글이 다루는 트레일러 식별자에도 달려 있습니다. 지문 diff는 계속 정규화된 본문을 해시하므로, 다른 도구가 쓴 파일의 반올림 차이는 그것이 비교하는 범위 밖입니다. 그런 것들은 여전히 렌더 비교의 몫입니다
숫자 처리와 SetPrecision의 정확한 의미는 losLab PDF Developer Library 레퍼런스에서, 위에서 쓴 콘텐츠 모델 호출과 함께 문서화되어 있습니다