LZW 인코더 딕셔너리는 자신의 출력을 읽을 디코더보다 항상 한 항목 앞서 있으므로, 양쪽이 단일 코드 폭 임계값을 공유할 수 없습니다. PDFlibPas는 같은 EarlyChange 플래그에서 파생된 별도의 임계값을 TPLLZWEncoder와 TPDFLZWDecompressor에 부여하며, 바로 그 한 항목의 리드 때문에 이 플래그가 존재합니다
직접 만든 LZW 구현은 거의 다 같은 자리에서 틀립니다. 파일을 열려면 디코더가 필요하니 먼저 디코더를 작성합니다. 잘 작동합니다. 그다음 LZW는 대칭이라고 믿고 디코더 로직을 한 줄 한 줄 그대로 따라 인코더를 작성하고, round-trip 테스트를 돌리면 통과합니다. 출시합니다. 여섯 달 뒤 고객이 여러분이 만든 출력을 다른 뷰어에서 열었는데, 스트림 중간 어딘가부터 전부 쓰레기로 보입니다. 버그는 바로 그 미러링이었습니다. LZW의 두 절반은 대칭이 아니며, 대칭인 척하면 자기 코드로만 읽을 수 있는 스트림이 만들어집니다
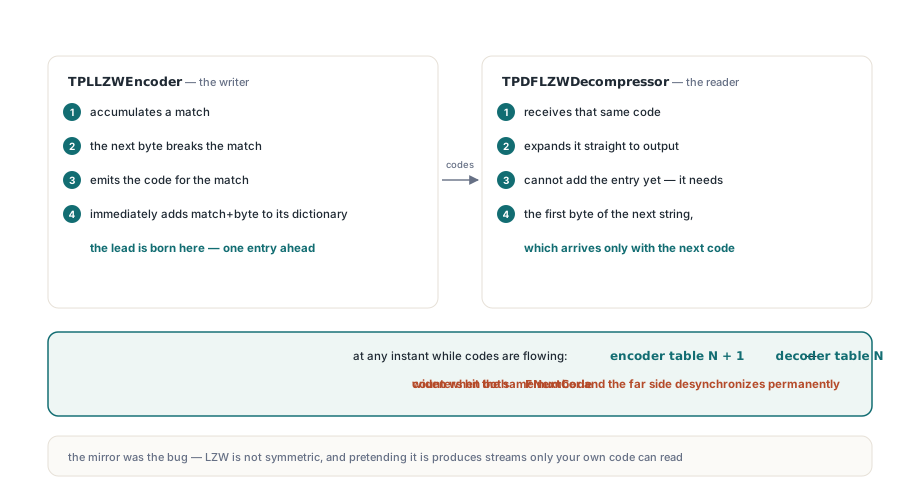
인코더는 디코더와 다른 임계값이 왜 필요할까요?
인코더는 디코더보다 한 단계 먼저 각 딕셔너리 항목을 배우기 때문입니다. 이건 PDFlibPas의 설계 선택이 아니라 LZW가 작동하는 방식 자체에 내재한 성질이며, 올바른 구현이라면 어딘가에서 반드시 이를 보정해야 합니다. 루프를 따라가 보면 리드가 어디서 생기는지 보입니다. 인코더는 일치를 쌓다가 다음 바이트가 일치를 깨뜨리는 순간 일치 코드를 내보내고, 즉시 일치+바이트를 자기 딕셔너리에 추가합니다. 디코더는 같은 코드를 받아 확장하지만, 아직 대응 항목을 추가할 수 없습니다. 새 항목이 필요한 건 다음 문자열의 첫 바이트인데, 그것은 다음 코드와 함께야 도착하기 때문입니다. 그래서 코드가 흐르는 어느 순간이든 인코더 테이블은 디코더 테이블보다 항목이 하나 더 많습니다. 양쪽이 자기 FNextCode가 같은 숫자에 도달했을 때 코드를 9비트에서 10비트로 늘린다면, 한 코드만큼 어긋난 시점에 폭을 늘리게 되어 반대편 비트 리더가 영구적으로 동기화를 잃습니다. TPDFLZWDecompressor.ResetDictionary에서는 디코더 임계값이 한 번 계산되어 FChangeCode에 저장됩니다:
// TPDFLZWDecompressor.ResetDictionary: 임계값의 디코더 측
FCodeSize := FInitialCodeSize;                 // PDF LZWDecode용 9
FBitMask  := (Cardinal(1) shl FCodeSize) - 1;  // 511
if FEarlyChange then
  FChangeCode := FBitMask                      // FNextCode가 511에 도달하면 폭을 늘림
else
  FChangeCode := FBitMask + 1;                 // FNextCode가 512에 도달하면 폭을 늘림
FClearCode := 1 shl (FCodeSize - 1);           // 256
FEOICode   := FClearCode + 1;                  // 257
FNextCode  := FClearCode + 2;                  // 258
디코드 루프는 항목을 추가한 직후 (FNextCode = FChangeCode) and (FCodeSize < 12)를 검사해 폭을 늘리고, 새 폭에 맞춰 FBitMask와 FChangeCode를 다시 계산합니다. 9비트는 511 또는 512에서, 10비트는 1023 또는 1024에서, 11비트는 2047 또는 2048에서 전환되며, 12비트는 딕셔너리를 키우는 대신 ClearCode로 비워야 하는 상한입니다. 인코더는 그 어떤 숫자도 재사용할 수 없습니다. GrowCodeSize는 리드를 보정하기 위해 1을 더하므로, EarlyChange가 설정된 경우 디코더는 511에서 폭을 늘리는 동안 인코더는 512에서 늘립니다:
procedure GrowCodeSize(FinalDataCode: Boolean);
var
  ChangeCode: Cardinal;
begin
  if FCodeSize >= 12 then
    Exit;
  if FEarlyChange then
    ChangeCode := Cardinal(1) shl FCodeSize          // 9비트일 때 512
  else
    ChangeCode := (Cardinal(1) shl FCodeSize) + 1;   // 9비트일 때 513
  // 디코더는 EOI를 읽기 전에 마지막 대기 항목을 추가합니다.
  if FinalDataCode then
    Dec(ChangeCode);
  if FNextCode = ChangeCode then
    Inc(FCodeSize);
  end;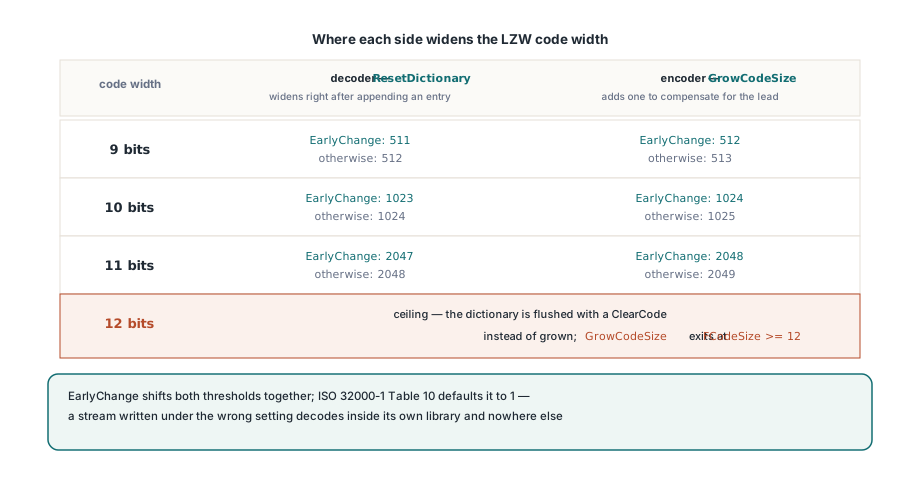
마지막 데이터 코드에서 두 쪽이 드디어 만납니다
스트림의 끝은 인코더가 리드를 멈추고 디코더처럼 생각해야 하는 유일한 지점이며, GrowCodeSize의 FinalDataCode 파라미터가 바로 그 용도입니다. EOI 코드를 잘못된 폭으로 내보내면 그 앞부분은 여전히 완벽하게 유효해서, 결함이 수천 개의 올바른 바이트 뒤에 숨습니다. 과정은 이렇습니다. 인코더는 마지막 데이터 코드를 내보낸 뒤, 이전의 모든 반복과 달리 자기 딕셔너리에 아무것도 추가하지 않습니다. 일치를 확장할 다음 바이트가 남아 있지 않기 때문입니다. 디코더는 반대입니다. 그 마지막 코드를 받아서야 이전 코드부터 붙들고 있던 항목을 완성합니다. 마지막 단계에서 디코더는 따라잡히고 리드는 0으로 줄어들며, EOI를 읽을 때 쓸 폭은 인코더가 만든 적 없는 항목이 결정합니다. Dec(ChangeCode)는 정확히 한 번의 호출 동안 인코더가 자신이 디코더인 척하는 것입니다:
// TPLLZWEncoder.Compress, 스트림의 꼬리
EmitCode(CurCode);      // 마지막 데이터 코드, 현재 폭 그대로
GrowCodeSize(True);     // 감소된 임계값으로 폭을 늘릴 수 있음
EmitCode(FEOICode);     // 디코더가 실제로 읽을 폭의 EOI
FlushBits;
FlushOutput;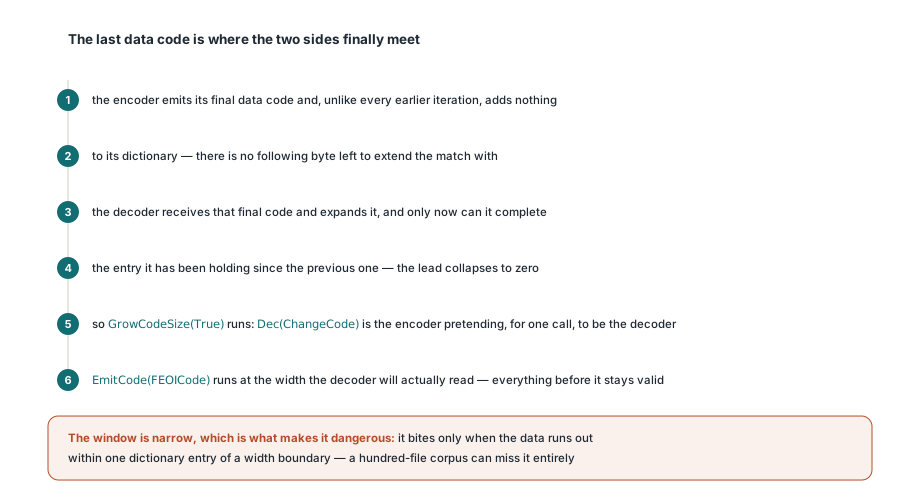
이것이 실제로 문제가 되는 창은 좁으며, 바로 그 점 때문에 위험합니다. 데이터가 우연히 폭 경계에서 딕셔너리 항목 하나 이내로 떨어질 때만 물기 때문에, 테스트 파일 백 개짜리 코퍼스는 전부 놓치는데 고객 파일 하나는 매번 걸립니다. Compress의 경계 케이스는 의도적으로 만들어야 합니다. 딕셔너리가 510, 511, 512 항목에 도달하는 입력을 조합한 다음, 성공적인 디코드에서 추론하지 말고 내보내진 EOI 비트 폭을 스트림에서 직접 읽어 보세요
통과한 round-trip 테스트도 왜 깨진 스트림을 숨길까요?
같은 실수를 저지른 두 구현은 서로 합의하기 때문입니다. 인코더와 디코더가 둘 다 한 코드 일찍 폭을 늘리거나, 둘 다 한 코드 늦게 늘린다면 양쪽은 그대로 보조를 맞추고, round trip은 입력을 바이트 단위로 재현하며, 테스트 스위트는 초록색이지만 여러분이 만든 스트림은 다른 무엇으로도 읽을 수 없습니다. 이 전체 과정에서 얻을 가장 가치 있는 교훈은 이것입니다. LZW에서는 자기 일관성이 증거로서 아무 가치가 없습니다. 그래서 자체 round-trip은 1차 테스트가 될 수 없고, PDFlibPas는 대신 세 가지 다른 방식으로 LZW 경로를 검증합니다. 기대하는 비트 패턴을 손으로 직접 써 넣은 hand-built 코드 스트림이라 디코드 결과가 아니라 바이트 자체를 단언합니다. 독립 구현과의 양방향 상호운용성으로, 이 인코더가 만든 스트림은 다른 곳에서 디코드되고 다른 곳이 만든 스트림은 TPDFLZWDecompressor가 디코드합니다. 그리고 차등 디코딩으로, 같은 바이트를 EarlyChange를 양쪽으로 설정해 두 번 읽어서, 잘못된 설정에서도 깨끗하게 디코드되는 스트림이라면 폭 경계가 전혀 테스트되지 않았다는 신호로 삼습니다:
Dec := TPDFLZWDecompressor.Create;
try
  Dec.EarlyChange := True;
  A := Dec.Decompress(Stream);
finally
  Dec.Free;
end;
Dec := TPDFLZWDecompressor.Create;
try
  Dec.EarlyChange := False;   // PDF에서는 일부러 틀린 규칙
  B := Dec.Decompress(Stream);
finally
  Dec.Free;
end;
// A는 소스와 일치해야 합니다. B는 일치하면 안 됩니다. B도 일치한다면
// 입력이 코드 폭 경계를 넘기엔 너무 짧았다는 뜻입니다.
실제로 이런 커버리지를 주는 것은 외부 입력입니다. 현재 테스트 자료는 9, 10, 11, 12비트 폭을 모두 넘나들고 단일 스트림에서 딕셔너리 리셋 34회를 강제하는데, 4095 상한에서 ClearCode 경로가 아예 작동한다는 것을 증명하는 유일하게 현실적인 방법입니다. 픽스처가 수 킬로바이트를 넘지 않는다면 그 코드는 한 번도 실행된 적이 없는 것입니다. 그리고 수정이 인코더 출력을 바꾼다면, 옛 출력을 보존할 가치가 있는 호환성 기준선이 아니라 깨진 것으로 취급하세요. 코드 폭을 잘못 섞은 스트림은 레거시 포맷이 아니라 우연히 디스크에 쓰여진 버그입니다
PDF는 1, TIFF는 사정이 다릅니다
PDFlibPas가 TPLLZWEncoder와 TPDFLZWDecompressor 양쪽에서 EarlyChange를 기본 True로 두는 이유는, ISO 32000-1 Table 10이 EarlyChange를 기본값 1인 LZWDecode 디코드 파라미터로 정의해서 코드 길이가 한 코드 일찍 늘어나기 때문입니다. 이는 ISO 32000-1 섹션 7.4.4.2에서 predictor 파라미터들과 함께 규정되어 있으며, 다른 동작을 원하는 PDF는 /DecodeParms 딕셔너리에 /EarlyChange 0을 명시적으로 적어야 합니다. 이 플래그가 상수가 아니라 속성인 이유는 TIFF입니다. TIFF 6.0 섹션 13은 그렇게 명확한 문장 없이 LZW 압축을 설명하며, 실제로 배포된 인코더들이 역사적으로 이 문제에서 갈렸습니다. PDF 스펙이 굳이 이 파라미터에 이름을 붙였다고 느껴질 만한 이유입니다. 따라서 TIFF-to-PDF 파이프라인에서 이 설정은 어느 한쪽 끝에 하드코딩할 수 있는 것이 아닙니다. TIFF 쪽이 결국 무엇을 필요로 하든 그것을 PDF /DecodeParms로 명시적으로 옮겨야 하며, 그렇지 않으면 잘 열리던 파일을 열리지 않는 파일로 변환하게 됩니다. 같은 주의가 FillOrder에도 적용됩니다. foTop과 foBottom은 비트 리더가 바이트의 어느 끝에서 채울지 고르며, TIFF Predictor 2 수평 차분도 TPDFLZWParms가 Predictor, Colors, BitsPerComponent, Columns를 통해 전달합니다. 그 경로의 나머지는 BigTIFF와 타일 레이아웃을 위한 내장 TIFF 디코더 강화 노트에서 다룹니다
이름 붙일 만한 작은 함정 두 가지
이 둘은 인코더와 디코더 객체를 나란히 열어 두고 여기서도 대칭이 성립할 거라 가정하면 둘 다 잘못 연결하기 쉽습니다:
InitialCodeSize는 두 클래스에서 같은 뜻이 아닙니다.TPLLZWEncoder.InitialCodeSize는 루트 심볼 폭으로 2에서 8까지 검증되며,InitDictionary가FClearCode를1 shl FInitialCodeSize로 유도하고FCodeSize를FInitialCodeSize + 1로 설정합니다.TPDFLZWDecompressor.InitialCodeSize는 첫 코드 폭으로 2에서 9까지 검증되며,ResetDictionary가FClearCode를1 shl (FCodeSize - 1)로 유도합니다. 평범한 8비트 PDF 데이터에서는 기본값이 각각 8과 9라서 알아차리지 못하지만, 둘을 손으로 같은 숫자로 맞추면 어긋난 쌍을 만든 것입니다- 신뢰할 수 없는 LZW 디코딩은 정확성 문제이기 전에 메모리 안전성 문제입니다. 딕셔너리 인덱스가 파일에서 곧장 나오기 때문입니다.
TPDFLZWDecompressor는 4095를 넘거나FNextCode이상인 코드를 거부하고, 4095를 넘는 항목 추가를 거부하며, 매GetNextCode전에 남은 입력을 비트 단위로 확인하고,SawExplicitEOI를 노출해서 호출자가 제대로 종료된 스트림과 그냥 바이트가 바닥난 스트림을 구분하게 합니다. 잘린 스트림은 부분 성공이 아닙니다. 악성 파일에 대비한 Pascal PDF 파서 강화의 더 넓은 조사가 이 가드들이 막는 결함 부류를 다룹니다
그래서 결국 무엇이 남을까요?
LZW는 대칭처럼 보이지만 대칭이 아닙니다. 인코더 딕셔너리는 스트림 본문 내내 한 항목 앞서 있고 리드는 마지막 코드에서 사라지므로, 올바른 구현은 임계값 두 개와 특수 케이스 하나를 지니며 EarlyChange 플래그가 두 임계값을 함께 이동시킵니다. 둘 중 하나가 한 코드만 어긋나도, 출력은 어느 순간까지는 유효하다가 갑자기 무효해지며 어디서도 에러도 예외도 없이 그냥 어딘가의 뷰어가 노이즈를 렌더링합니다. 솔직한 한계는 이것이 내부에서 전혀 테스트할 수 없다는 점입니다. 자기 스위트 안에서는 올바른 스트림과 일관되게 틀린 스트림을 구분할 방법이 없으므로, 상호운용성 검사는 선택적인 추가 패스가 아니라 얻을 수 있는 유일한 진짜 증거입니다. 두 클래스 모두 PDF Library for Delphi에 포함되어 있으며, 이 라이브러리는 object stream과 cross-reference stream 노트에서 설명한 주변 구조 작업도 처리합니다. 지원하는 컴파일러 버전 전반의 Delphi와 C++Builder용입니다