FDF 어노테이션 임포터는 파싱한 항목 수를 반환하면서 문서에는 하나도 추가하지 않을 수 있습니다. 전부 세고, 전부 떨어뜨리는 것입니다. losLab PDF Library의 TPDFlib.ImportAnnotationsFromFDFString은 키를 어떤 순서로든 읽고, /Rect를 정확하게, 로케일과 무관하게 파싱하며, 실제로 추가된 어노테이션 수를 반환합니다. 짝이 되는 익스포터는 어노테이션의 실제 /Rect를 쓰므로, 내보내기, 임포트, 두 번째 내보내기가 바이트까지 동일한 FDF를 만듭니다. 이 노트의 나머지 부분에서는 시작 오프셋 하나가 어쩌면 완벽한 조용한 실패를 만드는지, 그 뒤에 어떤 함정 세 개가 숨어 있는지, 그리고 반환값을 믿는 대신 임포트를 직접 확인하는 방법을 설명합니다
시나리오는 평범합니다. 리뷰어가 계약서에 코멘트를 달고, 코멘트가 FDF 파일로 이동하고(Acrobat은 Export Comments라고 부릅니다), Delphi 서비스가 FDF 임포트 호출로 깨끗한 사본에 병합합니다. 호출은 7을 반환하고, 로그는 '코멘트 7개 임포트됨'이라 말하고, 작업은 초록불이 켜지지만 출력 PDF에는 코멘트가 하나도 없습니다. 아무것도 던지지 않고, 아무것도 경고하지 않으며, 숫자는 그럴듯해 보였습니다. 파일 안 항목의 실제 개수였으니까요. 버그가 취할 수 있는 최악의 형태입니다. 성공 신호가 자기가 보고한다고 주장하는 작업과 무관하게 계산되는 카운터뿐인 함수입니다
FDF 임포트는 어떻게 성공을 보고하면서 아무것도 추가하지 않을 수 있을까
이름 리더가 잘못된 지점에서 시작할 수 있고, 카운터가 실제 작업 코드 바깥에 살 수 있기 때문입니다. /Subtype 바로 뒤 위치를 반환하는 키 탐색기는 값 앞의 공백 위에 착지합니다. 그 공백에서 시작해 첫 공백 문자에서 멈추는 ReadName은 아무것도 읽기 전에 멈추고, 모든 서브타입은 빈 채로 돌아옵니다. 서브타입이 없으면 어노테이션 생성을 거부하는 AddAnnotationToPage 같은 헬퍼는 그 자체로는 올바른 방어적 선택입니다. 하지만 반환값 없는 프로시저이고 호출부의 Inc(Result)가 그 바깥에 있다면, 두 가드가 합쳐져 '아무것도 안 됐다'를 '전부 됐다'로 바꿔버립니다. 올바른 이름 리더는 공백을 건너뛰고, PDF 이름 객체의 선행 /를 요구하며, [, (, )를 포함한 모든 구분자에서 멈춥니다. 그래서 /Subtype/Text와 /Subtype /Text 모두 Text를 산출합니다. losLab PDF Library가 이름을 읽는 방식입니다
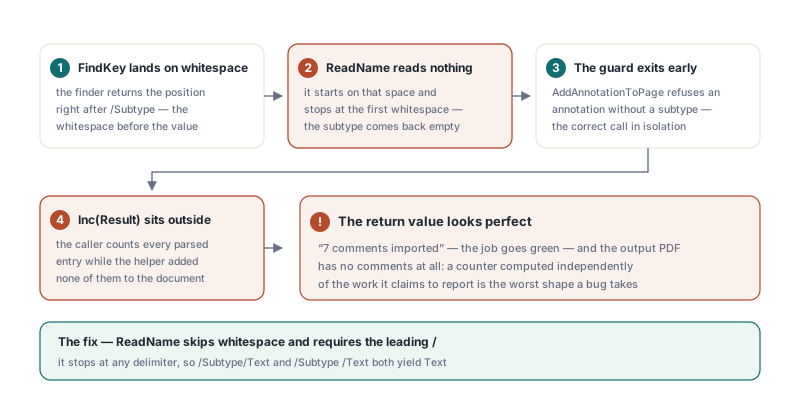
반환값에는 이것 말고도 신경 쓸 점이 있습니다. /Annots 배열의 형식이 맞는 사전마다 카운터를 올리는 임포터라도, 범위 밖 0-based /Page나 /Subtype 누락처럼 건너뛰어지는 항목이 있으면 과대 보고합니다. losLab PDF Library에서 ImportAnnotationsFromFDFString과 ImportAnnotationsFromFDF는 XFDF 임포트처럼 실제로 추가된 어노테이션 수를 반환합니다. FDF 헬퍼 AddAnnotationToPage는 Boolean을 반환하고 카운터는 성공할 때만 움직입니다. 그래도 문서를 직접 측정하는 편이 더 강한 검사입니다. 그 숫자를 어떤 코드가 만들었든 성립하기 때문입니다. 아래 스케치는 임포트 전후로 페이지마다 AnnotationCount를 비교합니다
function TotalAnnotations(Lib: TPDFlib): Integer;
var
  Page, Saved: Integer;
begin
  Result := 0;
  Saved := Lib.SelectedPage;
  for Page := 1 to Lib.PageCount do
    if Lib.SelectPage(Page) = 1 then
      Inc(Result, Lib.AnnotationCount);   // 선택된 페이지마다, 위젯 포함
  Lib.SelectPage(Saved);
end;

var
  Lib: TPDFlib;
  Before, Reported, Added: Integer;
begin
  Lib := TPDFlib.Create;
  try
    Lib.LoadFromFile('contract.pdf', '');
    Before := TotalAnnotations(Lib);
    Reported := Lib.ImportAnnotationsFromFDF('review-comments.fdf');
    Added := TotalAnnotations(Lib) - Before;
    if Added <> Reported then   // 모든 항목이 페이지에 안착하면 같다
      Writeln(Format('Importer reported %d, %d landed on a page', [Reported, Added]));
    Lib.SaveToFile('contract-reviewed.pdf');
  finally
    Lib.Free;
  end;
end;
첫 함정 뒤에 숨은 함정 세 가지
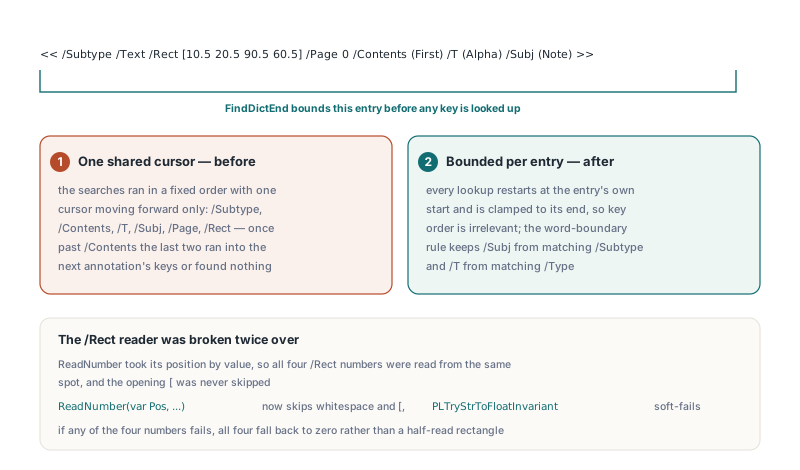
서브타입만 고치면 같은 부류의 파서에 함정이 세 개 더 드러나고, 어노테이션이 페이지에 닿지 않는 한 어느 것도 보이지 않습니다. 첫째, 위치를 값 매개변수로 받는 ReadNumber는 네 /Rect 숫자를 연달아 읽으면서 같은 지점을 네 번 읽고, 여는 [를 건너뛰지 않으면 실제로는 아무것도 읽지 못합니다. 둘째, 모든 탐색에서 앞으로 전진하는 커서 하나를 공유하는 FindKey는 키 순서에 의존합니다. 익스포터는 /Subtype, /Rect, /Page, /Contents, /T, /Subj 순으로 쓰는데 임포터는 /Subtype, /Contents, /T, /Subj, /Page, /Rect 순으로 찾을 수 있습니다. 커서가 /Contents를 지나치면 /Page와 /Rect 탐색은 현재 항목을 지나쳐 아무것도 찾지 못하거나 다음 어노테이션의 키를 맞춰버립니다. 임포터가 자기 익스포터의 출력조차 읽지 못하는 형국입니다. 셋째, 시스템 소수점 구분자를 따르는 PLStrToFloat 같은 루틴으로 파싱한 숫자는 쉼표 로케일 머신에서 깨집니다. ISO 32000-1 §12.7.7은 FDF를 PDF 객체 문법으로 정의하고 PDF의 딕셔너리 키는 순서가 없으므로(§7.3.7), 키 순서를 가정하는 FDF 파서는 파일을 만든 도구가 어느 쪽이든 구조적으로 틀립니다
losLab PDF Library는 각 항목의 경계를 먼저 잡습니다. FindDictEnd는 여는 <<에서 짝이 되는 >>까지 걸으며 중첩 딕셔너리를 추적하고 백슬래시 이스케이프를 포함한 리터럴 문자열 본문을 건너뛰므로, (see section >> 4) 같은 주석 안의 >>가 항목을 조기 종료시킬 수 없습니다. 모든 키 탐색은 항목의 시작에서 출발해 끝으로 제한되므로 키 순서는 무관해지고, 한 어노테이션이 다른 어노테이션의 /Page를 빌리는 일도 막습니다. 키 매칭은 이름 뒤에 구분자가 바로 오는 것도 받아들입니다. /Contents(Hi)가 /Contents (Hi)만큼 유효하기 때문입니다. 단어 경계 규칙 덕분에 /Subj가 /Subtype의 시작을, /T가 /Type을 잘못 맞추는 일은 없습니다. ReadNumber는 위치를 var 매개변수로 받고, 공백과 [를 건너뛰며, PLTryStrToFloatInvariant로 파싱합니다. 잘못된 토큰에서 예외 대신 부드럽게 실패합니다. 네 개의 사각형 숫자 중 하나라도 실패하면 절반만 읽힌 사각형을 만드는 대신 넷 모두 0으로 폴백합니다
FDF 왕복이 어노테이션을 자기 높이만큼씩 밀어내는 이유
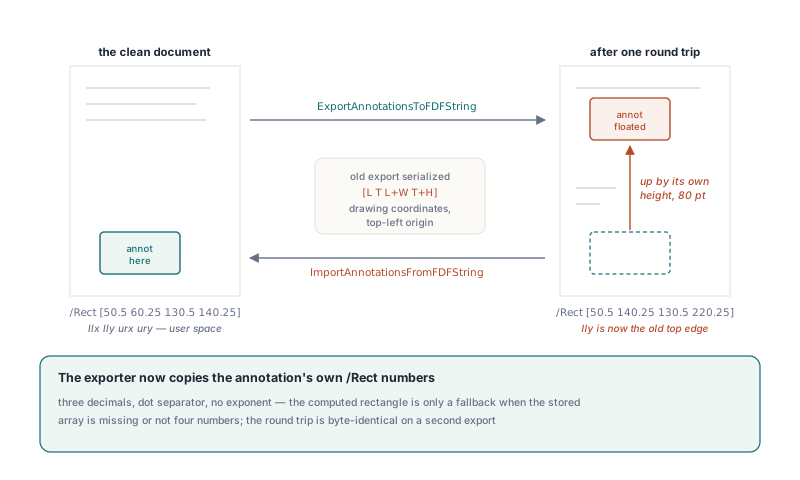
잘못된 좌표 모델로 사각형을 쓰기 쉽기 때문입니다. 어노테이션의 /Rect는 기본 사용자 공간에서 [llx lly urx ury]입니다(ISO 32000-1 §12.5.2, 사각형 정의는 §7.9.5). FDF도 같은 배열을 운반합니다. 그러나 GetAnnotRectEx는 라이브러리의 드로잉 좌표, 즉 SetOrigin이 제어하는 공간에서 Left, Top, Width, Height를 보고합니다. 이를 [L T L+W T+H]로 직렬화하는 익스포터는 임포터에게 네 값을 넘기고, 그 값을 PDF 사각형으로 그대로 써넣으면 왼쪽 아래 모서리가 있어야 할 자리에 윗변이 놓입니다. 왕복마다 어노테이션이 자기 높이만큼 올라가는 이유입니다. losLab PDF Library 익스포터는 어노테이션 자신의 /Rect 숫자를 그대로 복사합니다. 소수 셋째 자리, 점 구분자, 지수 없음입니다. 저장된 배열이 없거나 네 숫자가 아닐 때만 계산된 사각형으로 폴백합니다
복사해 쓸 만한 왕복 테스트는 임포터의 반환값이 아니라 문서 상태와 두 번째 내보내기를 단언합니다. 기대 개수가 2인 점에 주목하세요. AddNoteAnnotation은 Text 어노테이션과 그 Popup을 만들고 둘 다 이동합니다. 이 테스트는 내보내기와 임포트를 쉼표 소수 구분자 아래에서 실행하는데, 이 이야기의 나머지 절반이 바로 그 자리에서 나옵니다
var
  Source, Target: TPDFlib;
  FDF: AnsiString;
  OldSep: Char;
begin
  Source := TPDFlib.Create;
  Target := TPDFlib.Create;
  try
    Source.NewPages(1);                     // 이제 두 페이지
    Source.SelectPage(2);
    Source.AddNoteAnnotation(50.5, 60.25, 0, 80, 80, 120, 60,
      'Reviewer', 'Check this', 0.25, 0.5, 0.75, 0);
    Target.NewPages(1);

    OldSep := FormatSettings.DecimalSeparator;
    FormatSettings.DecimalSeparator := ',';   // 독일어나 프랑스어 데스크톱을 흉내
    try
      FDF := Source.ExportAnnotationsToFDFString;   // 여전히 /Rect [50.5 ...를 쓴다
      Target.ImportAnnotationsFromFDFString(FDF);
    finally
      FormatSettings.DecimalSeparator := OldSep;
    end;

    Target.SelectPage(2);
    Assert(Target.AnnotationCount = 2);           // 노트와 그 팝업
    Assert(Target.GetAnnotType(1) = 'Text');
    Assert(Target.ExportAnnotationsToFDFString = Source.ExportAnnotationsToFDFString);
  finally
    Target.Free;
    Source.Free;
  end;
end;
FDF 경로는 어노테이션의 핵심 딕셔너리를 중심으로 만들어져 있습니다. 임포터는 각 항목을 /Type, /Subtype, /Rect, /Contents, /T, /Subj로 재구성하고, 익스포터는 Widget 어노테이션을 폼 필드가 속한 폼 데이터 메서드에 맡깁니다. 색, 플래그, 테두리 스타일, 팝업 링크, 외형 스트림까지 FDF에 맡기기 전에 어떤 데이터가 어떤 메서드로 이동하는지 더 넓은 지도를 FDF, XFDF, XFA 폼 데이터 교환 개요에서 확인하세요. 실제로 도착한 것을 들여다봐야 한다면 GetAnnotType, GetAnnotTitle, GetAnnotContentsEx 같은 인덱스별 리더가 아웃라인, 어노테이션, 액션 인트로스펙션에서 다뤄집니다
쉼표 소수 FDF와 XFDF 파일은 어떻게 읽나
FDF의 답은 명확합니다. PDF 문법에서 쉼표는 구분자가 아니므로, 쉼표를 정확히 하나 갖고 점이 없는 숫자 토큰은 쉼표 로케일 머신에서 쓰인 소수일 수밖에 없습니다. 그런 파일은 실제로 존재합니다. 시스템 로케일로 숫자를 포맷한 익스포터가 내놓은 /Rect [10,500 20,250 40,750 60,125] 같은 것입니다. ReadNumber는 파싱 전에 그 쉼표 하나를 점으로 바꿉니다. 쉼표가 두 개이거나 쉼표와 점이 섞인 토큰은 추측하지 않고 거부합니다. 리더는 지수 표기도 소비하지 않는데, ISO 32000-1 §7.3.3과 맞습니다. PDF 숫자는 지수를 쓰지 않습니다
XFDF는 더 까다롭습니다. XML 속성에서는 쉼표가 구분자이기 때문입니다. 표준 XFDF(ISO 19444-1)는 rect="50.5,80.25,70.75,100.125"과 dashes="4,2"를 쓰지만, 쉼표 로케일 시스템의 로케일 의존적 작성기는 rect="50,500 80,250 70,750 100,125"과 opacity="0,600"을 만들어냅니다. losLab PDF Library는 XFDF 숫자를 양방향 모두 로케일 불변으로 읽고 쓰며, 레거시 형태는 XFDFNormalizeLegacyDecimals로 다음 조건에서만 인식합니다. 속성이 공백으로 분할됐을 때 기대한 토큰 수(rect는 넷, opacity와 width는 하나)가 나오고 모든 토큰이 숫자-쉼표-숫자 형태일 때입니다. 표준 rect는 결코 매칭되지 않습니다. 쉼표 셋을 가진 토큰 하나이거나 쉼표로 끝나는 토큰들이기 때문입니다. dashes는 의도적으로 그대로 둡니다. 4,2는 대시 길이 둘일 수도, 레거시 4.2일 수도 있고 어느 쪽인지 알려줄 규칙이 없기 때문입니다
const
  // 익스포터 순서와 다른 키, 쉼표 로케일 익스포트의 쉼표 소수
  LegacyFDF: AnsiString = '%FDF-1.2'#10'1 0 obj'#10'<< /FDF << /Annots ['#10 +
    '<< /Rect [10,500 20,250 40,750 60,125] /Page 0 /Contents (First) ' +
    '/Subtype /Text /T (Alpha) /Type /Annot >>'#10 +
    '] >> >>'#10'endobj'#10'trailer'#10'<< /Root 1 0 R >>'#10'%%EOF'#10;
var
  Lib: TPDFlib;
begin
  Lib := TPDFlib.Create;               // 새 문서에는 페이지가 하나
  try
    Lib.ImportAnnotationsFromFDFString(LegacyFDF);
    Assert(Lib.AnnotationCount = 1);
    Assert(Lib.GetAnnotTitle(1) = 'Alpha');
    // 점 소수로 XFDF 재내보내기: rect="10.500 20.250 40.750 60.125"
    Writeln(Lib.ExportAnnotationsToXFDFString);
  finally
    Lib.Free;
  end;
end;
어노테이션 임포트 테스트는 무엇을 단언해야 하나
유용한 임포트 테스트는 대상 문서의 상태를 단언하고, 임포터가 자기 자신에 대해 말하는 것만 단언하지 않습니다. 말없는 0 실패에서 반환값이야말로 무사히 남는 그 하나의 숫자입니다. 여기서 설명한 모든 함정은 세 단언으로 잡힙니다. 기대한 페이지의 어노테이션 개수, GetAnnotType이나 GetAnnotContentsEx로 되읽은 필드 하나, 첫 내보내기와 바이트 단위로 비교한 두 번째 내보내기입니다. 같은 규율이 문서 구조를 대량으로 다시 쓰는 모든 API에 적용됩니다. 중복 폼 필드 병합에서 설명한 필드 통합도 마찬가지입니다. 반환된 총계가 아니라 결과 트리를 검사하는 것이 맞습니다. FDF와 XFDF 어노테이션 메서드는 파일 및 문자열 변형과 함께 losLab PDF Library for Delphi and C++Builder에 포함되어 있습니다