정보 딕셔너리가 /Title (Annual Maintenance Report)라고 말하는데 XMP 패킷에는 dc:title이 아예 없는 파일을 생각해 보자. 뷰어는 불평 없이 제목을 보여 주지만 PDF/A 검사기는 파일을 거부한다. 두 메타데이터 사본이 서로 어긋나기 때문이다. 두 번째 파일은 똑같이 건강해 보이지만 XMP에 pdfaid:part 항목이 없고, 검사기는 수십 개의 오류로 답한다. 파일을 평범한 PDF로 판정해 청구된 파트의 모든 규칙을 실패로 보고하는데, 한 줄이 빠진 것에서 전부 나온다
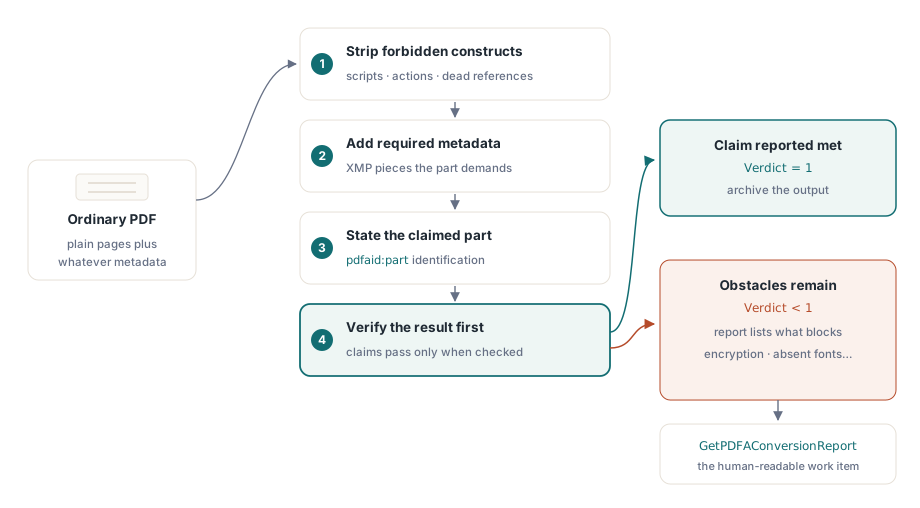
두 문제는 필요한 작업량이 크게 다르다. 메타데이터 조율은 어떤 파일에든 돌릴 수 있는 좁은 수정이다. 임의의 PDF를 보존용으로 바꾸는 것은 대상 파트가 금지하는 것을 걷어내고, 요구하는 것을 더하고, 청구를 명시한 뒤 실제로 나온 바이트를 검증하는 일이다. 우리는 변환을 일부러 그 마지막 단계를 중심으로 지었다. ConvertToPDFA는 Enterprise 에디션(TPDFlibEnterprise)이 GetPDFAConversionReport와 함께 제공하는 기능으로, 변환된 문서를 메모리에 저장하고 그 바이트로 PDF/A 검사를 돌려 검사가 통과할 때만 1을 반환한다
잘 열리는 PDF가 왜 PDF/A 검사에 실패하는가?
두 실패 모두 메타데이터 규칙에서 나온다. PDF는 제목과 저자, 프로듀서, 날짜를 문서 정보 딕셔너리에 기록하고, PDF/A는 같은 사실을 XMP 메타데이터 패킷에서도 요구한다. ISO 19005-1 §6.7.3은 둘이 동등할 것을 요구하고 PDF/A-2와 PDF/A-3도 이 규칙을 유지한다. 이 규칙에서 실패하는 파일들의 전형적 패턴은 정보 딕셔너리를 채우고 XMP 절반은 한 번도 쓰지 않은 프로듀서다. 검사기는 한쪽에서 제목을 찾고 다른 쪽에서는 아무것도 찾지 못한다
빠진 식별은 더 조용하다. pdfaid:part와 pdfaid:conformance 항목이 파일을 PDF/A로 표시하는 것이고, 그것 없이도 파일은 완벽히 잘 구성될 수 있다. 가장 흔히 보는 사례는 애플리케이션이 자기 XMP 패킷을 공급해 PDF writer가 만든 것을 대체하는 경우다. 커스텀 패킷에는 애플리케이션 자체 필드만 있고 pdfaid 항목은 없으므로, 오류 목록은 진짜 원인과는 전혀 다른 곳을 가리킨다
RepairDocumentMetadata는 두 사례를 모두 처리하고 바꾼 항목 수를 반환한다. 모든 에디션에서 쓸 수 있고 SetPDFAMode와 SanitizeDocument도 마찬가지다. 복구는 Title, Author, Subject, Keywords, Creator, Producer, CreationDate, ModDate를 훑는다. XMP만 값을 갖고 있으면 정보 딕셔너리를 그것으로 채우므로 이미 기록된 것은 하나도 버려지지 않는다. 양쪽 다 값을 갖고 서로 다르면 정보 딕셔너리가 이긴다. 정보 딕셔너리가 프로듀서가 가장 흔히 설정하는 절반이고, 그래서 저자의 의도를 기록했을 가능성이 더 높은 쪽이라고 판단한 것이다
XMP가 권위 있는 사본이라면(문서 관리 시스템에서 큐레이션됐다고 치자) 원하는 값을 SetInformation으로 정보 딕셔너리에 밀어 넣은 뒤에야 복구를 돌려라. 반대로 하면 큐레이션된 XMP 제목이 원본 프로듀서가 쓴 것으로 덮인다
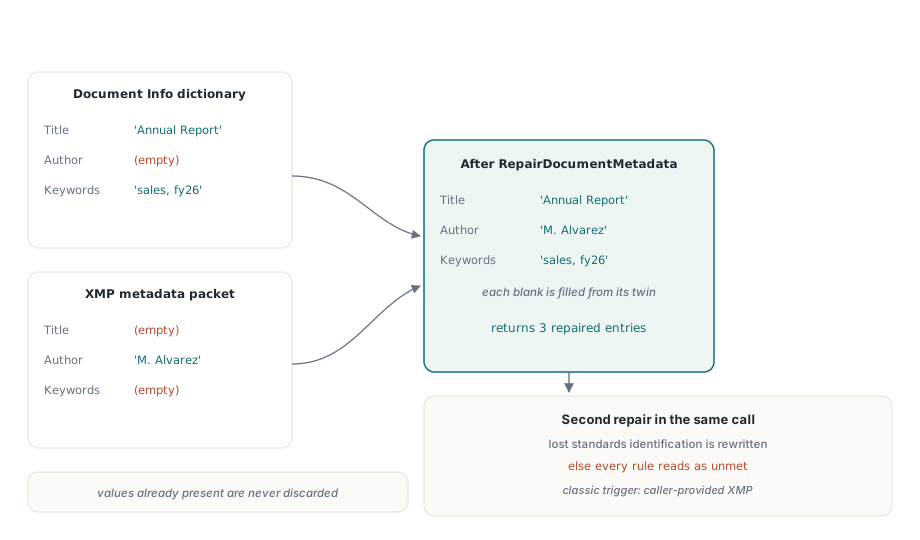
식별 복구가 여러분에게 요구하는 것은 하나다. 문서가 어느 파트를 겨냥하는지 알아야 한다. 갓 불러온 파일에는 PDF/A 모드가 설정되어 있지 않으므로 복구 전에 SetPDFAMode를 호출하라. 모드가 자리 잡으면 RepairDocumentMetadata는 맞는 pdfaid 항목들을 쓰고, 파트 4 모드에는 연도 2020을 단 pdfaid:rev를 추가하며, 검사기가 함께 검사하는 dc:format을 application/pdf로 설정한다
uses
  SysUtils, PDFlibrary;

procedure RepairIncoming(const InName, OutName: string);
var
  Lib: TPDFlib;
  Fixed: Integer;
begin
  Lib := TPDFlib.Create;
  try
    if Lib.LoadFromFile(InName, '') <> 1 then
      raise Exception.CreateFmt('Cannot open %s', [InName]);

    // 큐레이션된 제목을 정보 딕셔너리에 먼저 넣는다.
    // 두 절반이 어긋날 때 이쪽 사본이 이기기 때문이다
    Lib.SetInformation(2, 'Annual Maintenance Report 2025');

    Lib.SetPDFAMode(3);                  // 3 = PDF/A-2b, 아래 표 참조
    Fixed := Lib.RepairDocumentMetadata;
    Writeln(Format('%d metadata entries brought into agreement', [Fixed]));

    Lib.SaveToFile(OutName);
  finally
    Lib.Free;
  end;
end;
대상 파트와 모드 번호 고르기
파트는 문서가 담아야 하는 것에서 고르고, 번호는 그다음에 찾는다. SetPDFAMode와 ConvertToPDFA는 하나의 번호 체계를 공유하는데, 그 체계는 파트 이름이 암시하는 순서로 흘러가지 않는다
| 모드 | 파트와 레벨 | 비고 |
|---|---|---|
| 1 | PDF/A-1a | PDF 1.4, 태그 있음 |
| 2 | PDF/A-1b | PDF 1.4 |
| 3 | PDF/A-2b | PDF 1.7 |
| 4 | PDF/A-2a | PDF 1.7, 태그 있음 |
| 5, 6, 7 | PDF/A-3b, 3a, 3u | 모든 타입의 내장 파일 허용 |
| 8 | PDF/A-2u | PDF 1.7, Unicode 텍스트 필요 |
| 9, 10, 11 | PDF/A-4, 4e, 4f | PDF 2.0. 4e는 3D와 리치 미디어를 더하고 4f는 내장 파일을 허용 |
모드 3은 PDF/A-2b이고 모드 4는 PDF/A-2a다. 1a부터 세어 올라가며 a 레벨이 항상 앞선다고 가정하는 사람들이 이 역전에 걸린다. PDF/A-2u는 파트 3 모드들 뒤인 8에서 나타난다
실질적 결과를 낳는 선택은 첨부 파일이다. 파트 1과 2는 내장 파일을 금지하므로 ConvertToPDFA는 모드 1부터 4와 모드 8에서 그것들을 제거한다. Factur-X나 ZUGFeRD 송장을 모드 3으로 변환하면 구조화된 XML 송장이 출력에서 사라지고, 파일이 존재했던 이유도 함께 사라진다. 첨부 파일을 담는 것은 모두 모드 5(PDF/A-3b)를 겨냥하라. 그 송장 형식들이 정의된 파트이기도 하다. PDF 2.0이 필요하면 모드 11이다. 파트 3이나 파트 4 파일의 모든 첨부 파일은 /AFRelationship으로 문서와의 관계를 밝혀야 하고, PDF Library for Delphi는 그 모드들에서 저장하는 내장 파일마다 그 항목을 써 준다
파트 4는 자기를 다르게 식별한다. 평범한 PDF/A-4에는 준수 문자가 없고, 두 확장에는 E나 F를 쓰며, 파트가 발표된 연도를 단 pdfaid:rev를 요구한다. ConvertToPDFA는 모드 9부터 11에서 파일을 PDF 2.0으로 올린다. ISO 19005-4 §6.1.2가 이 파트를 PDF 2.0 위에 세우므로 검사도 그런 파일을 1.7이 아니라 PDF 2.0 기준으로 판정한다
ConvertToPDFA가 파일에서 바꾸는 것
ConvertToPDFA는 고정된 복구 순서를 밟고 각 단계를 일반 텍스트 보고서에 적어 두며, 결과를 메모리에 저장해 그 바이트를 검증한다. 실패한 검사는 0을 반환하고 1부터 11 밖의 모드도 그렇다. 이쪽은 보고서가 쓰이기 전에 반환된다. 순서를 알아 둘 가치가 있다. 각 단계가 출력이 잃거나 얻는 것이기 때문이다:
- 암호를 모르는 암호화 문서는
blocked:줄과 함께 즉시 변환을 멈춘다. 안쪽을 읽을 수 없으니 복구는커녕할 것도 없다 - 문서 수준 JavaScript와 그것을 실행하는 open action이 제거되며, 모든 additional-actions 항목과 어느 파트도 허용하지 않는 액션 타입이 함께 사라진다. Launch, Sound, Movie, ResetForm, ImportData, Hide, SetOCGState, Rendition, Trans가 그 대상이다. GoTo와 URI 링크는 남으므로 내비게이션은 계속 동작한다
- 내장 파일은 금지하는 파트에서 제거된다. 위에서 말한 바로 그것이다
- 숨겨져 있거나 표시 안 함으로 설정된 주석은 삭제된다. PDF/A는 주석이 보이고 인쇄될 것을 요구하는데, 드러내자면 페이지의 모습이 바뀌므로 우리는 제거를 택했다
- 폼 필드 appearance는
/NeedAppearances플래그를 지우기 전에 재생성되므로 채워진 값이 계속 보인다 - 쓰이지만 임베드되지 않은 폰트는 머신에 설치된 폰트에서 임베드된다
- 아무도 참조하지 않는 객체는 버려지고, 파일에 없다면 sRGB output intent가 추가된다
- 마지막으로 파트와 레벨이 XMP에 명시되고 바이트가 검사된다
서버에서는 폰트 단계가 변환을 멈추게 할 가능성이 가장 높다. 변환 호스트 어디에도 존재하지 않는 폰트를 쓰는 문서는 파일 안쪽에서 복구될 수 없고 보고서가 그렇게 말해 준다. 문서들이 실제로 쓰는 폰트를 변환 머신에 설치하라. 기존 PDF에 누락 폰트 임베드하기 안내가 그 단계만을 따로 다룬다
배치 작업은 실패한 변환을 어떻게 다뤄야 하는가?
반환 값은 게이트로, 보고서는 작업 지시서로 다루어라. 1을 반환한 파일은 보관하고 나머지는 보고서를 붙여 사람에게 돌려라. 실패한 변환의 출력이 입력보다 깔끔해 보인다는 이유만으로 보관함에 저장하지 마라. 그 파일은 이제 검사가 확인을 거부한 PDF/A 청구를 달고 있다. 검증 단계가 존재하는 이유가 바로 그 상황을 막기 위해서다
GetPDFAConversionReport의 보고서는 동작마다 한 줄이고 각 줄은 동사로 시작한다. removed:, regenerated:, repaired:, embedded:, added:, stated:, 실행을 멈춘 것이 있으면 blocked:, 그리고 끝맺는 result: 줄. 판정 뒤의 검사는 첫 실패에서 멈추므로, 파일이 실패하면 변환이 검사를 통째로 다시 돌리고 보고서는 모든 문제를 한꺼번에 보여 준다. 접두어로 분류하는 데는 몇 줄이면 족하다
uses
  Classes, SysUtils, PDFlibrary, PDFlibEnterprise;

function ArchiveOne(const InName, ArchiveDir, ReviewDir: string): Boolean;
var
  Lib: TPDFlibEnterprise;
  Report: TStringList;
  I: Integer;
  Blocked: Boolean;
begin
  Result := False;
  Lib := TPDFlibEnterprise.Create;
  Report := TStringList.Create;
  try
    if Lib.LoadFromFile(InName, '') <> 1 then
      Exit;
    Result := Lib.ConvertToPDFA(5) = 1;      // 5 = PDF/A-3b, 첨부 파일 유지
    Report.Text := Lib.GetPDFAConversionReport;
    if Result then
      Lib.SaveToFile(IncludeTrailingPathDelimiter(ArchiveDir) + ExtractFileName(InName))
    else
    begin
      Blocked := False;
      for I := 0 to Report.Count - 1 do
        if Pos('blocked:', Report[I]) = 1 then
          Blocked := True;
      // 원본은 그대로. 함께 가는 것은 보고서뿐이다
      Report.SaveToFile(IncludeTrailingPathDelimiter(ReviewDir) +
        ChangeFileExt(ExtractFileName(InName), '.pdfa-report.txt'));
      if Blocked then
        Writeln(InName, ': needs a password or a rebuilt source file');
    end;
  finally
    Report.Free;
    Lib.Free;
  end;
end;
blocked: 줄은 보통 수정이 PDF 바깥에 있음을 뜻한다. 암호, 다른 소스 파일, 또는 문서를 만든 무엇의 재실행이다. 통변환 뒤의 평범한 검증 문제는 더 잦게는 의미를 담고 있어 단순히 지울 수 없는 콘텐츠고, 사람이 결정해야 하는 것이 바로 그 사례들이다
파일이 이미 달고 있는 PDF/A 표식 읽기
변환 전에 문서가 이미 자신에 대해 무엇이라 청구하는지 검사하라. 스캐너와 오피스 스위트, 다른 PDF 도구에서 도착하는 파일은 흔히 이미 PDF/A 표식을 달고 있고, 유효한 PDF/A-3 파일을 파트 2로 다시 변환하면 첨부 파일을 아무 이유 없이 잃는다
함정은 XMP가 같은 속성을 두 가지 방식으로 쓰게 허용한다는 점이다. 어떤 프로듀서는 파트를 자식 엘리먼트로 쓴다. <pdfaid:part>2</pdfaid:part>. 어떤 프로듀서는 rdf:Description의 속성으로 쓴다. pdfaid:part="2". 둘 다 평범하고 유효한 XMP다. 한 형태만 찾는 탐지기는 다른 부류의 프로듀서 파일에 표식이 없다고 결론 내리고, 그렇게 만든 검사기는 유효한 PDF/A-2 파일을 파트 1 기준으로 판정해 표식도 없고 PDF 버전도 너무 높다고 보고한다. 진실의 정반대다. PDF Library for Delphi의 검사기는 두 형태를 모두 읽는다. 직접 표식을 후각으로 찾는다면 같은 것까지 하라:
function DeclaredPDFAPart(Lib: TPDFlib): string;
const
  ElemTag = '<pdfaid:part>';
  AttrDQ  = 'pdfaid:part="';
  AttrSQ  = 'pdfaid:part=''';
var
  Packet: string;
  P: Integer;
begin
  Result := '';
  Packet := Lib.GetDocumentMetadata;
  P := Pos(ElemTag, Packet);                   // 엘리먼트 형태
  if P > 0 then
    Exit(Copy(Packet, P + Length(ElemTag), 1));
  P := Pos(AttrDQ, Packet);                    // 속성 형태, 큰따옴표
  if P = 0 then
    P := Pos(AttrSQ, Packet);                  // 속성 형태, 작은따옴표
  if P > 0 then
    Result := Copy(Packet, P + Length(AttrDQ), 1);
end;
빈 결과는 어느 형태로도 표식이 없다는 뜻이다. 숫자 하나가 프로듀서가 겨냥한 파트를 알려 주며, 변환을 할지 아예 정하기 전에 대상과 비교할 숫자가 바로 그것이다
보관함에 들어가기 전 스크립트 살균
보존 변환과 보안 살균은 보통 함께 돈다. 보안 정책이 없애고 싶어 하는 콘텐츠가 PDF/A가 금지하는 것과 크게 겹치기 때문이다. SanitizeDocument는 SANITIZE_* 플래그 비트마스크를 받아 적용한 제거 수를 반환한다. ConvertToPDFA 스스로도 첫 단계에서 SANITIZE_JAVASCRIPT or SANITIZE_OPEN_ACTION으로 그것을 호출한다
검사기에 중요한 세부가 하나 있다. 문서 수준 스크립트는 카탈로그의 /JavaScript 이름 트리, 곧 /Names 딕셔너리 아래의 이름 트리에 살고, 마지막 스크립트가 제거되면 이제 빈 트리가 함께 제거된다. 빈 트리도 문서가 스크립트를 갖고 있다고 알리는 셈이라, 아래에 뭐가 있는지 세지 않고 키 자체에 반응하는 검사기도 있다
살균을 어떤 도구가 했든, 메모리 상태를 믿지 말고 새로 로드해서 저장된 파일을 검증하라. 다시 여는 일은 값싸다:
var
  Lib, Check: TPDFlib;
begin
  Lib := TPDFlib.Create;
  Check := TPDFlib.Create;
  try
    Lib.LoadFromFile('upload.pdf', '');
    Lib.SanitizeDocument(SANITIZE_JAVASCRIPT or SANITIZE_OPEN_ACTION);
    Lib.SaveToFile('upload-clean.pdf');

    Check.LoadFromFile('upload-clean.pdf', '');
    if Check.GlobalJavaScriptCount > 0 then
      raise Exception.Create('Document-level scripts survived the save');
  finally
    Check.Free;
    Lib.Free;
  end;
end;
보존 파이프라인의 이웃 단계들은 PDF/A와 PDF/UA 프리플라이트, 진짜 블랙라인과 콘텐츠 제거, 그리고 보관된 문서가 구조화된 송장 데이터까지 담게 됐을 때 메타데이터 쪽을 이어 받는 Factur-X를 위한 PDF/A-3 XMP 확장 스키마 안내를 보라
여기서 보여준 변환과 메타데이터 복구, 검증 전부가 여러분 자신의 Delphi, C++Builder 또는 Lazarus 프로세스 안에서 돌며, 사슬에 외부 변환기나 명령줄 검사기는 없다. PDF Library for Delphi 제품 페이지에 PDF/A 파트와 에디션, 대상 플랫폼이 정리되어 있다