.otf 파일의 Noto Sans SC로 조판한 중국어 송장이 mutool에서 열리면 고객 이름이 있어야 할 자리에 엉뚱한 한자가 나타날 수 있습니다. 같은 페이지를 TrueType 폰트로 찍으면 정상입니다. 원인은 폰트의 CFF charset이고, PDFlibPas는 임베딩하는 사본에서 이를 identity로 다시 써서 glyph-index 코드가 의도한 글리프에 도달하게 만듭니다
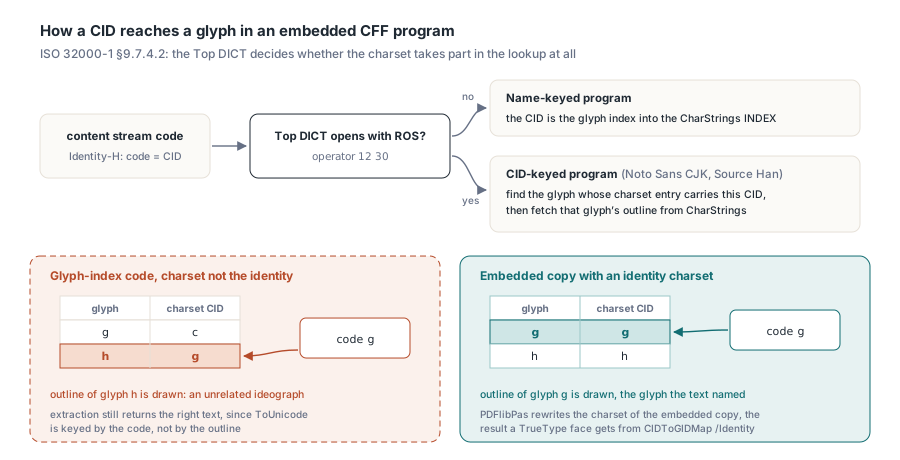
문제가 드러나는지는 폰트가 어떻게 만들어졌는지에 달려 있습니다. CIDFontType2 폰트로 임베딩된 TrueType 프로그램은 CIDToGIDMap으로 Identity를 받으니 content stream의 코드가 의도한 글리프에 바로 앉습니다. CFF outline을 가진 라틴 OpenType 폰트 대부분은 name-keyed이고, name-keyed CFF 프로그램은 들어온 CID를 그대로 glyph index로 씁니다. ISO 32000-1 §9.7.4.2도 많은 폰트에서 CID와 GID가 일치한다고 언급합니다. 전부는 아닙니다. CID-keyed 폰트로 만들어진 대형 CJK 패밀리 — Noto Sans CJK와 그 형제격인 Source Han이 여기 속합니다 — 는 자체 CID 번호 체계를 가지며, glyph index를 그 번호 체계에 곧장 밀어 넣는 writer는 그 CID를 가진 글리프가 무엇이든 그걸 얻습니다
CID-keyed CFF 프로그램이 CID를 가지고 하는 일
ISO 32000-1 §9.7.4.2는 Top DICT를 보고 임베딩된 CFF 프로그램을 두 사례로 갈라 놓습니다. Top DICT가 CIDFont 연산자를 쓴다 — 실제로는 ROS(연산자 12 30: registry, ordering, supplement)로 시작한다 — 는 경우 reader는 content stream에서 CID를 가져오고, 그 CID를 charset 항목에 지닌 글리프를 찾은 뒤에야 CharStrings INDEX에서 outline을 가져옵니다. CIDFont 연산자가 없으면 CID가 곧 glyph index이고 charset은 아무 역할도 하지 않습니다. 따라서 §9.7.4.2에 적힌 그대로 따르는 reader는 charset이 identity가 아닌 한 glyph-index 코드에 대해 엉뚱한 글리프를 그립니다. 뷰어를 무엇으로 바꿔도 마찬가지입니다. Adobe Technical Note #5176에 정의된 charset 자체는 두 가지 특수 사례를 곁에 둔 세 가지 레이아웃으로 옵니다:
- Format 0은 글리프 순서대로 글리프마다 2바이트 SID 또는 CID 하나를 저장합니다
- Format 1은 범위를 저장합니다. 첫 CID 뒤에 연속된 CID를 지닌 글리프 수를 1바이트 카운트로 붙이는 식입니다
- Format 2는 같은 범위 레이아웃에 2바이트 카운트를 쓰며, 길게 이어진 런이 많은 폰트에 어울립니다
- Glyph 0은
.notdef이며 어떤 포맷에도 항목이 없습니다. 0, 1, 2의 charset 오프셋은 데이터를 가리키는 대신 미리 정의된 charset 중 하나를 이름으로 지목합니다
먼저 손에 든 폰트가 어느 쪽인지부터 확인하세요. PDF 쪽의 Identity-H는 2바이트 코드가 CID와 같다는 말만 할 뿐입니다. 그 CID가 글리프에 도달하는 경로는 전부 폰트 프로그램 안에 살아 있습니다. 아래 함수는 .otf에서 CFF 테이블을 읽고 Top DICT를 따라가 ROS를 찾은 뒤 charset이 모든 글리프를 같은 번호의 CID에 대응시키는지 검사합니다. RTL만 있으면 됩니다
uses
  System.SysUtils, System.IOUtils;

type
  TCFFCharsetReport = record
    IsCFF, CIDKeyed, IdentityCharset: Boolean;
    CharsetFormat, GlyphCount: Integer;
  end;

{$RANGECHECKS ON}  // 잘린 파일은 잘못 읽는 대신 ERangeError를 일으킵니다
function InspectOtfCharset(const FileName: string): TCFFCharsetReport;
var
  B: TBytes;
  NumTables, I, Cff, P, Dict, DictEnd, Unused1, Unused2: Integer;
  Op, Operand, CharsetOfs, CharStringsOfs, G, Left: Integer;

  function BE(Pos, Count: Integer): Integer;
  var
    K: Integer;
  begin
    Result := 0;
    for K := 0 to Count - 1 do
      Result := (Result shl 8) or B[Pos + K];
  end;

  // Pos 위치의 INDEX 끝을 반환하고 첫 오브젝트 범위를 잡아 줍니다
  function SkipIndex(Pos: Integer; out ObjStart, ObjEnd: Integer): Integer;
  var
    Count, OffSize, Base: Integer;
  begin
    Count := BE(Pos, 2);
    if Count = 0 then
    begin
      ObjStart := Pos + 2;
      ObjEnd := ObjStart;
      Exit(Pos + 2);
    end;
    OffSize := B[Pos + 2];
    Base := Pos + 2 + (Count + 1) * OffSize;  // 오프셋은 여기서부터 1 기반
    ObjStart := Base + BE(Pos + 3, OffSize);
    ObjEnd := Base + BE(Pos + 3 + OffSize, OffSize);
    Result := Base + BE(Pos + 3 + Count * OffSize, OffSize);
  end;

begin
  Result := Default(TCFFCharsetReport);
  Result.CharsetFormat := -1;
  B := TFile.ReadAllBytes(FileName);
  if (Length(B) < 12) or (BE(0, 4) <> $4F54544F) then  // 'OTTO'
    Exit;
  Cff := -1;
  NumTables := BE(4, 2);
  for I := 0 to NumTables - 1 do
    if BE(12 + I * 16, 4) = $43464620 then               // 'CFF '
      Cff := BE(12 + I * 16 + 8, 4);
  if Cff < 0 then
    Exit;
  Result.IsCFF := True;
  P := SkipIndex(Cff + B[Cff + 2], Unused1, Unused2);    // Name INDEX
  SkipIndex(P, Dict, DictEnd);                           // Top DICT INDEX
  Operand := 0;
  CharsetOfs := 0;
  CharStringsOfs := 0;
  P := Dict;
  while P < DictEnd do
  begin
    Op := B[P];
    case Op of
      12:
        begin
          if B[P + 1] = 30 then
            Result.CIDKeyed := True;                     // ROS
          Inc(P, 2);
        end;
      0..11, 13..21:
        begin
          if Op = 15 then
            CharsetOfs := Operand
          else if Op = 17 then
            CharStringsOfs := Operand;
          Inc(P);
        end;
      28: begin Operand := SmallInt(BE(P + 1, 2)); Inc(P, 3); end;
      29: begin Operand := BE(P + 1, 4); Inc(P, 5); end;
      30:
        begin                                            // 실수(real) 값
          repeat
            Inc(P);
          until ((B[P] and $F) = $F) or ((B[P] shr 4) = $F);
          Inc(P);
        end;
      32..246: begin Operand := Op - 139; Inc(P); end;
      247..250: begin Operand := (Op - 247) * 256 + B[P + 1] + 108; Inc(P, 2); end;
      251..254: begin Operand := -(Op - 251) * 256 - B[P + 1] - 108; Inc(P, 2); end;
    else
      Exit;                                              // 예약된 바이트
    end;
  end;
  if (not Result.CIDKeyed) or (CharsetOfs <= 2) or (CharStringsOfs <= 0) then
    Exit;
  Result.GlyphCount := BE(Cff + CharStringsOfs, 2);
  P := Cff + CharsetOfs;
  Result.CharsetFormat := B[P];
  if Result.CharsetFormat > 2 then
    Exit;
  Inc(P);
  Result.IdentityCharset := True;
  G := 1;                                                // .notdef에는 항목이 없음
  while G < Result.GlyphCount do
  begin
    if BE(P, 2) <> G then
      Result.IdentityCharset := False;
    case Result.CharsetFormat of
      0: Left := 0;
      1: Left := B[P + 2];
    else
      Left := BE(P + 2, 2);
    end;
    Inc(P, Result.CharsetFormat + 2);
    Inc(G, Left + 1);
  end;
end;
CIDKeyed = True이면서 IdentityCharset = False인 보고서가 바로 이 글의 주인공 폰트입니다. 그 charset을 고려하지 않은 채 content stream에 glyph index를 밀어 넣는 writer라면 무엇이든 이 폰트로 엉뚱한 글리프를 그립니다. name-keyed 결과, 혹은 charset이 이미 identity인 CID-keyed 폰트는 같은 writer 아래에서도 정상 렌더링됩니다. 어떤 제품에서 CJK 폰트 하나는 되고 바로 다음 것은 안 되는 이유가 이것입니다. 루프는 범위마다 첫 CID만 비교합니다. 그것으로 충분합니다. 범위는 연속된 CID를 지닌 연속된 글리프를 덮으므로, 자기 glyph index에서 시작한 범위는 끝까지 그 위에 머뭅니다
glyph index는 폰트 딕셔너리 전체를 관통합니다
PDF writer가 CID를 손에 쥘 일은 드뭅니다. cmap 테이블과 shaping 엔진이 둘 다 glyph index를 돌려주므로, 자연스러운 설계는 그 인덱스를 2바이트 Identity-H 코드로 쓰고 나머지를 전부 이 코드에 묶습니다. /W 폭 배열, PDF/A가 요구하는 /CIDSet 비트맵, 추출이 원문을 복구하게 만드는 ToUnicode CMap이 그렇습니다. TrueType에는 탈출구가 있습니다. Table 117이 CIDToGIDMap을 제공하긴 하지만 Type 2 CIDFont 전용이고, CFF 프로그램은 CIDFontType0 폰트 안에 살아서 PDF 쪽에서 CID를 다른 곳으로 돌릴 방법이 없습니다. 일부 writer가 TrueType에서 쓰는 요술 — 재사용된 글리프에 폰트 끝을 넘는 두 번째 "alias" CID를 부여해 ToUnicode가 용도마다 다른 텍스트를 붙이게 하는 — 도 같은 이유로 막힙니다. CFF 폰트에서 그 alias는 글리프를 하나도 고르지 못하고 mutool은 렌더링할 수 없다고 보고합니다. U+4E00과 U+2F00(KANGXI RADICAL ONE)을 하나의 outline에 대응시키는 폰트가 흔한 사례입니다. 두 글자가 서로 다르게 추출되어야 하는 문서라면 해당 위치를 /ActualText(ISO 32000-1 §14.9.4)가 붙은 marked-content span으로 감싸세요. reader는 폰트의 대응 대신 그것을 사용합니다
charset을 제자리에서 다시 쓰기
glyph-index 코드와 CID-keyed 프로그램을 화해시키는 길은 둘입니다. 하나는 모든 glyph index를 쓰기 전에 폰트의 CID로 번역하는 것인데, 이러면 content stream 코드, /W의 키, /CIDSet의 비트 위치, ToUnicode의 원본 코드, 저장 시점의 모든 서브셋까지 다 건드려야 합니다. 다른 하나는 딱 한 구조, charset만 바꿔서 폰트가 name-keyed 프로그램처럼 glyph index에 응답하게 만드는 것입니다. 두 번째 길이 더 안전합니다. shaper, 폭 테이블, 서브셋터, ToUnicode 빌더는 전부 glyph 공간에서 계속 일하고, CID를 이해해야 하는 코드는 폰트의 임베딩 사본 위에 한 번 도는 짧은 루틴 하나뿐입니다. PDFlibPas는 이 길을 택합니다
재작성은 charset의 포맷과 바이트 길이를 그대로 유지합니다. Format 0에서는 각 항목이 자기 glyph index로 덮어 써집니다. Format 1과 2에서는 범위마다 첫 CID만 바뀌고 카운트는 그대로입니다. 늘어나거나 줄어드는 것이 하나도 없습니다. CharStrings, Private DICT, FDArray, FDSelect로 향하는 Top DICT 오프셋은 아무것도 재인코딩하지 않고도 유효하게 남고, glyph index로 hinting 딕셔너리를 배정하는 FDSelect는 모든 글리프를 원래 FD에 그대로 둡니다. name-keyed 프로그램, 미리 정의된 charset, CFF2 테이블(charset이 없음), 파싱되지 않는 프로그램은 건드리지 않습니다. 재작성을 도는 코드 경로는 셋입니다:
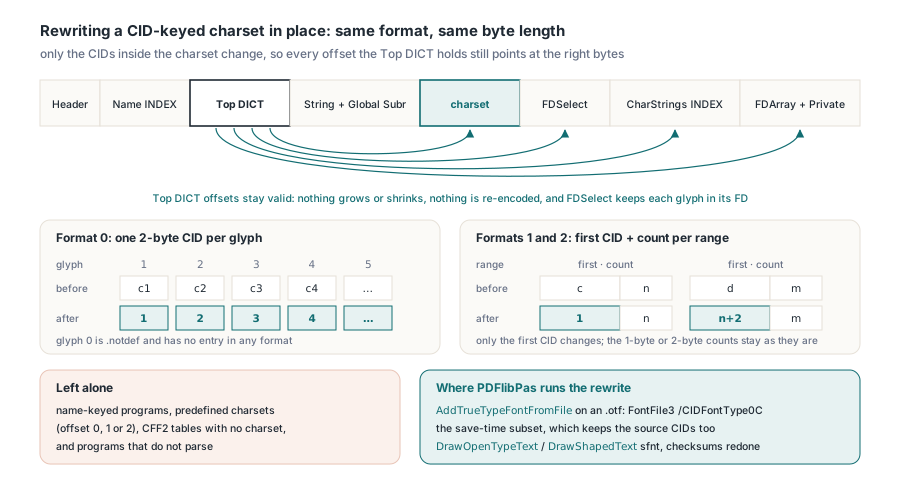
AddTrueTypeFontFromFile이.otf를 만나면 벌거벗은CFF테이블을 서브타입CIDFontType0C의FontFile3로 임베딩하며, charset은 이미 재작성된 상태입니다- 저장 시점의 서브셋은 원래 glyph index도, 원본 CID도 유지하므로 charset이 두 번째로 재작성됩니다
DrawOpenTypeText와DrawShapedText뒤에 있는 shaping 컴패니언은 sfnt 전체를 유지합니다. 재작성 후에는CFF테이블 체크섬이 다시 계산되고,head테이블의checkSumAdjustment는 파일 총합을 뺀0xB1B0AFBA가 됩니다- 그 조정값은 단일 폰트에만 정의되어 있으므로, 컬렉션에서 꺼낸 폰트는 테이블 체크섬만 적용받습니다
uses
  SysUtils, PDFlibrary;

var
  Lib: TPDFlib;
  FontID: Integer;
begin
  Lib := TPDFlib.Create;
  try
    // CFF 계열 .otf는 FontFile3 /CIDFontType0C로 임베딩되고,
    // CID-keyed이면 임베딩 사본이 identity charset을 얻습니다
    FontID := Lib.AddTrueTypeFontFromFile('C:\Fonts\NotoSansSC-Regular.otf');
    if FontID = 0 then
      raise Exception.Create('the font file could not be read or parsed');
    Lib.SetTextSize(18);
    Lib.DrawText(56, 760, '季度报表:华东区销售汇总');
    Lib.DrawText(56, 730, '发票号码 2026-11-0187,金额 ¥12,480.00');
    if Lib.SaveToFile('noto-sc.pdf') <> 1 then
      raise Exception.CreateFmt('save failed, error %d', [Lib.LastErrorCode]);
  finally
    Lib.Free;
  end;
end;
출력은 렌더링해서 확인하세요. 추출로는 문제가 보이지 않습니다. pdftotext를 비롯한 모든 추출기는 ToUnicode를 읽는데, ToUnicode는 content stream의 코드에 묶여 있고 폰트가 그 코드에 어떤 outline을 배정하는지는 전혀 모릅니다. 그래서 엉뚱한 한자를 그리는 페이지도 올바른 문자열을 추출해 냅니다. mutool draw -r 150 -o page%d.png noto-sc.pdf는 페이지의 실제 모습을 보여 주고, 이 DrawText 경로에서는 poppler의 pdffonts noto-sc.pdf가 폰트를 CID Type 0C로 표시해야 합니다. 예상 결과는 이렇습니다. 두 줄이 모두 원문이 가리키는 글리프를 갖춘 Noto Sans SC로 렌더링되고, Ghostscript에서도 같은 결과가 나옵니다
어느 임베딩 형태가 PDF 1.6을 요구할까요?
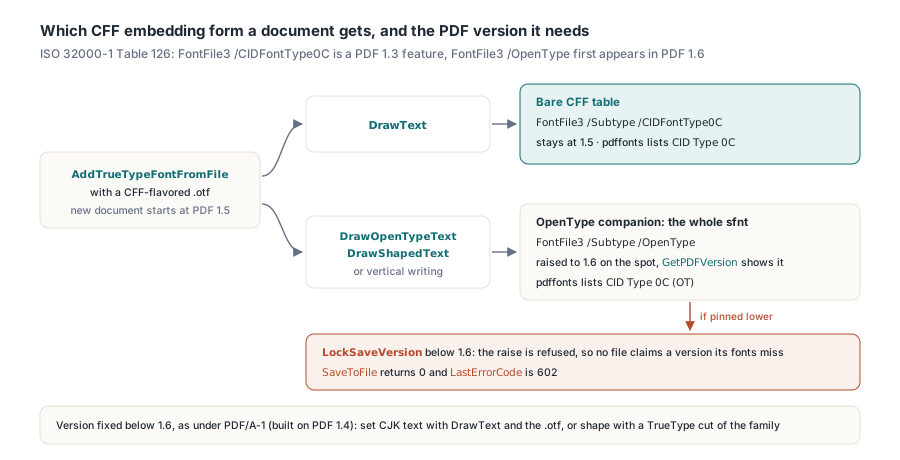
OpenType 서브타입입니다. ISO 32000-1 Table 126은 서브타입 CIDFontType0C의 FontFile3 스트림을 PDF 1.3 기능으로 실으며, CFF 테이블을 통째로 품은 sfnt인 서브타입 OpenType은 PDF 1.6에 처음 등장합니다. 새 PDFlibPas 문서는 버전 1.5에서 시작하고, 벌거벗은 CFF를 쓰는 DrawText 경로는 그 안에 들어맞습니다. CFF 폰트로 처음 DrawOpenTypeText, DrawShapedText 혹은 세로쓰기 호출이 일어나면 OpenType 컴패니언이 만들어지고 문서는 그 자리에서 1.6으로 올라가며, GetPDFVersion이 즉시 그렇게 보고합니다. 버전 잠금은 이야기를 바꿉니다. LockSaveVersion이 문서를 더 낮은 버전에 못 박아 두었다면 승격이 거부되고 SaveToFile은 0을 돌려주며 LastErrorCode는 602가 됩니다. 그래서 어떤 파일도 자기 폰트가 채우지 못하는 버전을 주장하지 못합니다. 납품 프로파일이 버전을 1.6 미만으로 고정하는 경우 — PDF 1.4 위에 세워진 PDF/A-1이 흔한 사례입니다 — CJK 텍스트는 .otf를 DrawText로 심거나, shaping이 필요한 것은 패밀리의 TrueType 컷으로 처리하세요
var
  Lib: TPDFlib;
  FontID: Integer;
begin
  Lib := TPDFlib.Create;
  try
    FontID := Lib.AddTrueTypeFontFromFile('NotoSansSC-Regular.otf');
    Writeln('before: ', Lib.GetPDFVersion);      // 예상: 1.5
    if Lib.DrawOpenTypeText(56, 760, FontID, 18, '《年度报告》第三章', 0) = 1 then
      Writeln('after: ', Lib.GetPDFVersion);     // 예상: 1.6
    Lib.SaveToFile('shaped.pdf');  // pdffonts에서 예상: CID Type 0C (OT)
  finally
    Lib.Free;
  end;

  Lib := TPDFlib.Create;
  try
    Lib.LockSaveVersion('1.5');
    FontID := Lib.AddTrueTypeFontFromFile('NotoSansSC-Regular.otf');
    Lib.DrawOpenTypeText(56, 760, FontID, 18, '《年度报告》第三章', 0);
    if Lib.SaveToFile('locked.pdf') = 0 then
      Writeln('save refused, error ', Lib.LastErrorCode);  // 예상: 602
  finally
    Lib.Free;
  end;
end;
같은 숫자로 묶이는 폭과 ToUnicode
charset이 identity가 되는 순간 CID, glyph index, content stream 코드는 하나의 숫자입니다. 폭도 이를 따라옵니다. ISO 32000-1 §9.7.4.3은 /W를 CID 자체로 인덱싱합니다. 시작 CID에 폭 배열이 붙는 그룹, 혹은 첫 CID와 마지막 CID에 하나의 공유 폭이 붙는 그룹이며, simple font가 쓰는 /FirstChar 오프셋 같은 것은 없습니다. 배열이 빠뜨린 CID는 /DW를 받고, Table 117은 /DW 기본값을 1000으로 정합니다. 0은 틀린 값입니다. 목록에 없는 CID를 0으로 떨어뜨리는 reader는 한자 한 줄을 한 자리로 접어 붙입니다. AddTrueTypeFontFromFile로 올린 .otf에는 PDFlibPas가 CID 0에서 시작해 모든 글리프의 advance를 나열하는 /W 배열을 명시적 /DW 1000 곁에 씁니다. 읽는 쪽에서는 추출하면 쓰레기가 나오는 CJK 텍스트가 대개 같은 파이프라인의 codespace 절반에서 잘못되고, 폭, CharSet, CIDSet에 대한 PDF/UA 폰트 감사가 이 배열들을 임베딩 프로그램과 맞대어 봅니다
ToUnicode에는 자기 번호 규칙이 있습니다. bfrange 항목은 첫 대상 문자열만 저장하고, §9.10.3은 범위 길이가 그 마지막 바이트를 255 너머로 밀어 올리지 못하게 요구합니다. reader는 그 마지막 바이트만 증가시켜 이어지는 대상을 만들어 내기 때문입니다. U+4EFE, U+4EFF, U+4F00, U+4F01로 이어지는 연속 글리프는 하나의 범위처럼 보이지만 그렇지 않습니다. reader는 셋째를 U+4E00으로 디코딩할 겁니다. PDFlibPas writer는 원본 코드와 대상이 둘 다 256짜리 한 블록 안에 머물 때만 이웃한 glyph-to-Unicode 쌍을 하나의 bfrange로 합치고, 그렇지 않으면 런을 쪼갭니다. 세로쓰기 CJK 조판은 같은 컴패니언 폰트를 거치므로, 세로쓰기 일본어·중국어 텍스트는 추가 호출 없이 identity charset과 이 ToUnicode 범위를 물려받습니다
InspectOtfCharset이 CID-keyed에 identity가 아닌 charset이라고 보고하는 폰트는 glyph-index 코드와 폰트가 서로 어긋나는 폰트입니다. Delphi용 PDFlibPas를 통해 임베딩되면 그런 폰트는 outline과 오프셋과 charset 길이를 그대로 유지하고, 바뀌는 것은 그 한 테이블 안의 CID뿐입니다. sfnt 전체를 유지하는 경로라면 체크섬까지 더해집니다