新しく生成した PDF で "two-x" を検索すると、ページにはその 5 文字がはっきり表示されているのに、ヒット 0 件で返ることがあります。抽出した文字列をコードポイントでダンプすれば、理由はそこにあります。ハイフンは U+00AD SOFT HYPHEN で戻り、その後の空白は U+00A0 NO-BREAK SPACE で戻ったのです。見た目はどちらも同じです。違いは ToUnicode CMap、つまりリーダーが文字コードを Unicode へ戻すときに参照する表にあり、その起源は 1 個のフォントグリフを 2 つのコードポイントで共有していることです
素朴な文字列ツールは、この不一致を悪化させます。CSV エクスポートは行の切り方を変え、差分ツールはすべてのビューアで同じに読める 2 行を検出し、スペルチェッカーはソフトハイフンの入った "two-x" を未知の語として扱います。Unicode 正規化は半分だけ救いの手を差し伸べます。NFKC は U+00A0 を普通の空白に畳み込みます。NBSP には互換分解があるからです。しかし U+00AD は分解をまったく持たず、ソフトハイフンはすべての正規化形式を生き延びます
抽出された空白がU+00A0で戻ってくる理由
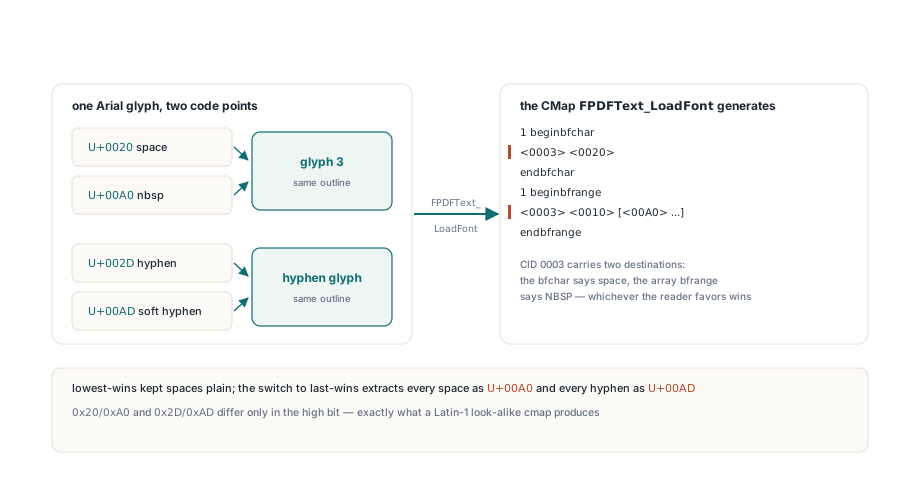
抽出された空白が U+00A0 に化けるのは、ToUnicode CMap がグリフでキーイングされていて、1 個のグリフに 2 つのコードポイントから到達できるときです。Arial ではグリフ 3 が U+0020 と U+00A0 の両方に仕え、ハイフングリフも U+002D と U+00AD の両方に仕えています。グリフ側から組み立てた CMap は CID 0003 について何かを言わなければならず、FPDFText_LoadFont にある PDFium のジェネレーターは結局 2 つのことを言います。CID 0003 を U+0020 に対応させる bfchar エントリと、同じ CID を U+00A0 に対応させる配列形式の bfrange です
1 beginbfchar
<0003> <0020>
endbfchar
1 beginbfrange
<0003> <0010> [<00A0> ...]
endbfrange
ISO 32000-1 の §9.10.3 は、bfchar と bfrange がコードを Unicode へ対応させるしかたを述べますが、2 つのエントリが同じ CID を要求したときどちらが勝つかは語りません。リーダーはそれぞれ独自の優先規則を選びます。最小値か最初のマッピングを保持するリーダーは素の空白を抽出します。PDFium のリーダーは最後のものを保持し、配列レンジは bfchar ブロックの後に来るので、グリフキーイングの CMap を通って書かれた空白はすべて NBSP として、ハイフンはすべてソフトハイフンとして抽出されます。同じテキストが、同じファイルの 2 つのビューアで違う抽出結果になるのです
このペアにはパターンがあります。0x20/0xA0 と 0x2D/0xAD は上位ビットでしか違いません。フォントの cmap が、ASCII 文字ですでに使っているアウトラインへ Latin-1 のそっくりさんを送り込むときに生じる形です。ギリシャ大文字のオメガ(U+03A9)とオーム記号(U+2126)も、Arial ではグリフを共有します。これまで通っていた抽出コードが、目に見えない文字のせいで急に失敗するなら、デバッガの文字列表示を信用せず、コードポイントを印字してください。ページからテキストを読み出す基本は PDFium で PDF 文書からテキストを抽出するの記事にあります
PDFium Component はシステムフォントをコードポイントでキーイングする
PDFium Component は、Unicode の cmap を持つシステムフォントについて、その CMap をエンジンに生成させることは決してありません。TPdf.AddText がフォントを必要とするとき、コンポーネントはフォント自身の sfnt cmap テーブルを読みます。format 12 のサブテーブルを優先し、なければ format 4 に落ちます。コードポイントはソート済みで重複のない状態で戻り、k 番目のコードポイントに CID k+1 が割り当てられ、CID 0 は .notdef のまま残ります。明示的な CIDToGIDMap が各 CID を自分のグリフへ送ります。したがって U+0020 と U+00A0 は、同じアウトラインを描く 2 つの異なる CID を得て、コンポーネントが書き出す ToUnicode CMap は各 CID をちょうど 1 つのコードポイントに対応させます
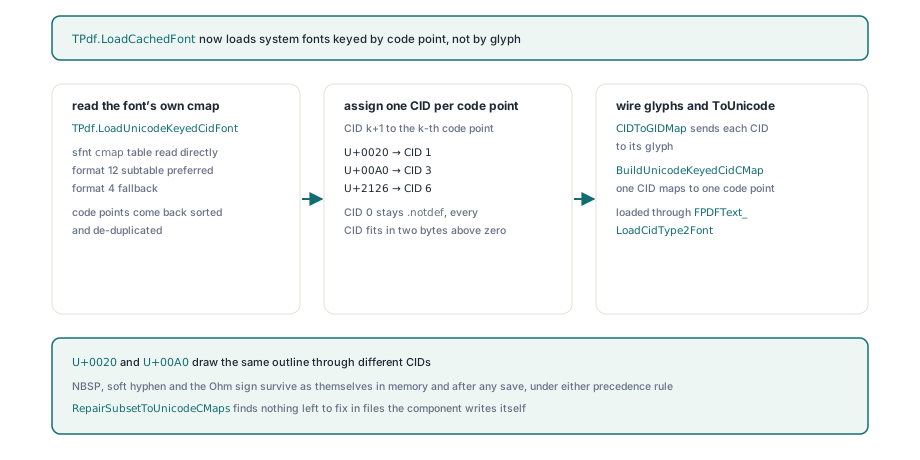
フォントは FPDFText_LoadCidType2Font を通じてロードされます。これは 明示的な CID-to-GID マップによる CID Type 2 フォント埋め込みのグリフレベル書き込みを支えるのと同じエントリポイントです。後に FPDFText_SetText が文字列を書くとき、逆引きは 1 文字につき 1 つの CID に着地します。選ぶべき 2 つ目のマッピングが存在しないので、リーダーの優先規則に左右される要素は何もありません。保存されたファイルはコンポーネント自身の ToUnicode ストリームも運ぶので、リロード後の抽出は、ライブ文書が使っていたのと同じ 1 対 1 の表を見ます
コストは CIDToGIDMap が大きくなることです。フォントが扱うコードポイント 1 個につき 2 バイトです。フォントが約 3,000 個のコードポイントを対応させているとすると、マップは約 6 KB になり、フォントごとにエンジンへ渡ります。それでもこの取引は毎回成立させる値打ちがあります。数 KB で、PDFium でも、最初のマッピングを保持するビューアでも、来年顧客が走らせるどんなインデクサーでも、同じに読める抽出が買えます
下の往復テストは、厄介なペアをすべて含む文字列を書き込み、未保存の文書から抽出し、保存し、リロードし、もう一度抽出します。どちらの文字列も入力と正確に一致するはずです。CodePoints ヘルパーがあるのは、不一致を読める形にするためだけです
uses
  SysUtils, PDFium;

const
  // 空白/U+00A0 とハイフン/U+00AD は 1 個の Arial グリフを共有し、
  // ギリシャのオメガ(U+03A9)とオーム記号(U+2126)も同様
  Sample: WString = 'two-x'#$00A0'y'#$00AD'z '#$03A9#$2126;

function CodePoints(const S: WString): string;
var
  I: Integer;
begin
  Result := '';
  for I := 1 to Length(S) do
    Result := Result + 'U+' + IntToHex(Ord(S[I]), 4) + ' ';
end;

var
  Pdf: TPdf;
  Live, Reloaded: WString;
begin
  Pdf := TPdf.Create(nil);
  try
    Pdf.CreateDocument;
    Pdf.AddPage(1, 595, 842);
    Pdf.AddText(Sample, 'Arial', 12, 72, 770);
    Live := Pdf.Text;                  // ライブの未保存文書
    Pdf.SaveAs('codepoints.pdf');
  finally
    Pdf.Free;
  end;

  Pdf := TPdf.Create(nil);
  try
    Pdf.FileName := 'codepoints.pdf';
    Pdf.Active := True;
    Pdf.PageNumber := 1;
    Reloaded := Pdf.Text;              // フルの保存とリロードの後
  finally
    Pdf.Free;
  end;

  if (Live <> Sample) or (Reloaded <> Sample) then
    Writeln('Mismatch: ', CodePoints(Live), '/ ', CodePoints(Reloaded));
end.
文書にめったに現れないとしても、サンプル文字列には NBSP とソフトハイフンを残してください。ASCII だけを書くテストは、グリフキーイングの CMap に対しても通ってしまいます。2 つのマッピングのどちらを選ぶかをリーダーに問う箇所が、どこにもないからです
1つのbfrangeエントリがブロック全体を消せる理由
CID の連なりが xxFF の境界をまたぐ 1 個の bfrange があると、PDFium はそのブロック全体を捨てます。ISO 32000-1 の §9.10.3 は、範囲内で変わってよいのは destination の最終バイトだけとしています。CID 側には PDFium のパーサーに対する同等の罠があります。上位 CID を (low and $FFFFFF00) or (high and $FF) と導出するのです。CID 00FE から 0101 への連なりは 00FE から 0001 と読まれ、low が high を超えるため、ブロック全体が無効と印を付けられます。SetText は成功し、ページは正しくレンダリングされ、それでいて抽出はそのブロックのすべての文字について U+0000 を返します
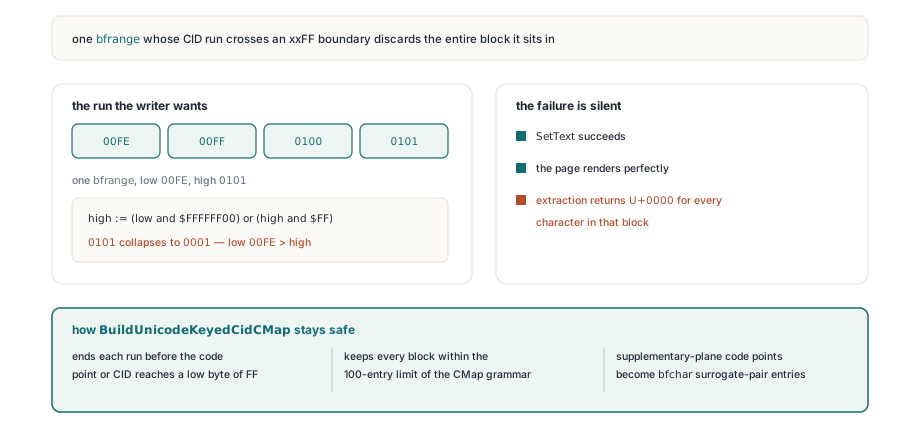
コードポイントキーイングのフォントは、まさにこの罠が噛みつく場所です。CID は密で連続的なので、255 を超えるコードポイントを持つフォントはどれも、ライターが連続エントリを単純に連結したら 00FF や 01FF をまたぐ CID の連なりを生みます。PDFium Component が書く CMap は、コードポイントか CID のいずれかが下位バイト FF に達する手前で連なりを終え、エントリを最大 100 個のブロックへ分割します。100 というのは、CMap の文法が各 beginbfrange と beginbfchar セクションに課す上限です
U+FFFF を超えるコードポイントには、UTF-16 のサロゲートペアを destination とする個別の bfchar エントリが与えられます。範囲内でサロゲートペアをインクリメントする意味は定義されていないからです。サロゲート側の話は Delphi での絵文字、CJK、サロゲートペア処理の記事にあります。bfchar だけの CMap なら境界問題を完全に回避できますが、サイズは数倍になります。だからこそレンジが主形式のままであり、分割規則が負担を担うのです
他のツールが書いたファイルの ToUnicode 競合を修復する
FPdfCompress ユニットの RepairSubsetToUnicodeCMaps は、コンポーネントが書いていないファイルのグリフキーイング競合を修復します。TPdf.SaveAs はフルの非インクリメンタル保存のたびにこれを実行し、任意のストリームに直接呼び出すこともできます。2 つの destination を持つ各 CID については、bfchar エントリが勝ちます。CID に bfchar がないときは、上位ビットでしか違わないペアは、より小さい base-Latin のコードポイントに解決されます。それ以外の競合は最初のマッピングを保持します
修復は、競合する 16 進値を同じ長さの置換でその場で書き換えます。ブロックのレイアウトも CID の網羅範囲も、ストリームの他のすべてのバイトも元のままです。CMap は PDFium のリーダーがすでに受け入れた形のまま保たれます。きれいに再構築した CMap は 16 進ダンプでは整然と見えるでしょうが、それは厳格なリーダーがすでに受け入れたストリームの構造を変えることで、間違っている destination 値がほんの一握りしかないなら、上振れのない賭けです
uses
  Classes, FPdfCompress;

var
  Source, Dest: TFileStream;
begin
  Source := TFileStream.Create('from-other-tool.pdf',
    fmOpenRead or fmShareDenyWrite);
  try
    Dest := TFileStream.Create('repaired.pdf', fmCreate);
    try
      // 等長の編集のみ。修復できる競合のないファイルと、
      // クロスリファレンスストリームやオブジェクトストリームのファイルはそのままコピーされる
      RepairSubsetToUnicodeCMaps(Source, Dest);
    finally
      Dest.Free;
    end;
  finally
    Source.Free;
  end;
end.このルーチンはクラシックなクロスリファレンステーブルを組み立て直すので、クロスリファレンスストリーム、ハイブリッド参照、オブジェクトストリームを使う文書はバイト単位でそのまま通過します。インクリメンタル保存(saIncremental)は設計上修復をスキップします。インクリメンタルリビジョンは追記専用でなければならないからです。コンポーネント自身が書くテキストには、どちらのケースも関係ありません。コードポイントキーイングのフォントは、修復が見つけるべき競合を決して生まないのです
コードポイントキーイングの経路が適用される範囲
コードポイントキーイングの経路は、Unicode の cmap サブテーブルを見せるすべてのフォントをカバーし、残りは PDFium のグリフキーイングロードが扱います。頼る前に知っておく価値のある細部です
- (3,0) の cmap しか持たないシンボルフォントと、CID 経路でロードできないフォントは
FPDFText_LoadFontを通ります。ここでは 2 つのコードポイントで共有されるグリフが、リーダーの優先規則にさらされます - format 4 のサブテーブルしかなければ、マップは基本多言語面をカバーします。プラットフォーム (3,10) や Unicode プラットフォームの format 12 サブテーブルがあれば、補助平面のコードポイントも加わります
- グリフ 0 とサロゲートのコードポイントは除外され、エントリ数は 65535 で頭打ちになります。すべての CID が 0 を超える 2 バイトに収まるようにするためです
- TrueType Collection には特別な注意が要ります。GDI の
GetFontDataは .ttc 全体を返し、FPDFText_LoadCidType2Fontにフェイスインデックスの引数はないので、コレクションをそのまま渡すと、simsun.ttc で NSimSun を求めたのにフェイス 0 の SimSun を埋め込むことになります。コンポーネントはファミリー名をフォントの name テーブル(nameID 1 と 16)と照合し、要求されたフェイスをスタンドアロンの sfnt として渡します。解釈できないコレクションは丸ごと通し、フェイス 0 を使います - 要求された名前のシステムフォントがどうしても読めないとき、
AddTextはフォント名をFPDFPageObj_NewTextObjに渡し、PDFium の標準フォントの中から探させます
不可視文字はインデックスで畳み、テキストには残す
抽出が本物のコードポイントを返すようになると、別の問いが浮かびます。作成者が意図的に打ち込んだ本物の NBSP やソフトハイフンに、検索インデックスはどう対処すべきか。インデックス層で畳み込み、TPdf.Text には手を付けません。抽出された文字列は文書が語っていることの記録です。インデックスはマッチングのために作られた損のあるビューであり、畳み込みの規則はそちらに属します
下のヘルパーは、自分のコードに足す関数です。NBSP を空白へ写像し、ソフトハイフンを落とします。ソフトハイフンは Unicode Standard によれば、行を折ってよい場所の印でしかありません。U+2126 は意図的にそのまま残します。NFC 正規化はオーム記号をオメガへ変えてしまいます。U+2126 には U+03A9 への正準単一分解があるからです。データシートの検索がこの 2 つをマッチさせるべきかは、抽出ではなく製品の判断です
uses
  SysUtils, Classes, PDFium;

// 検索インデックス向けの自前ヘルパー。PDFium Component の一部ではない
function FoldForIndex(const S: string): string;
begin
  Result := StringReplace(S, #$00A0, ' ', [rfReplaceAll]);
  Result := StringReplace(Result, #$00AD, '', [rfReplaceAll]);
end;

procedure IndexDocument(const FileName: string; Lines: TStrings);
var
  Pdf: TPdf;
  P: Integer;
begin
  Pdf := TPdf.Create(nil);
  try
    Pdf.FileName := FileName;
    Pdf.Active := True;
    for P := 1 to Pdf.PageCount do
    begin
      Pdf.PageNumber := P;
      Lines.Add(FoldForIndex(Pdf.Text));   // 正確なテキストは Pdf.Text に残る
    end;
  finally
    Pdf.Free;
  end;
end;
最初の例の codepoints.pdf ファイルに IndexDocument を走らせると、インデックスされた行は "two-x yz ΩΩ" と読めるはずです。11 文字で、最後はオーム記号です。一方 Pdf.Text は、NBSP とソフトハイフンを含む元の 12 文字すべてを、今もって返します
コードポイントキーイングのフォント、CMap 修復、テキスト抽出は、Delphi、C++Builder、Lazarus で同じページモデルの上に載っています。フォントとテキストの API は PDFium Component for Delphi の製品ページで全文カバーしています