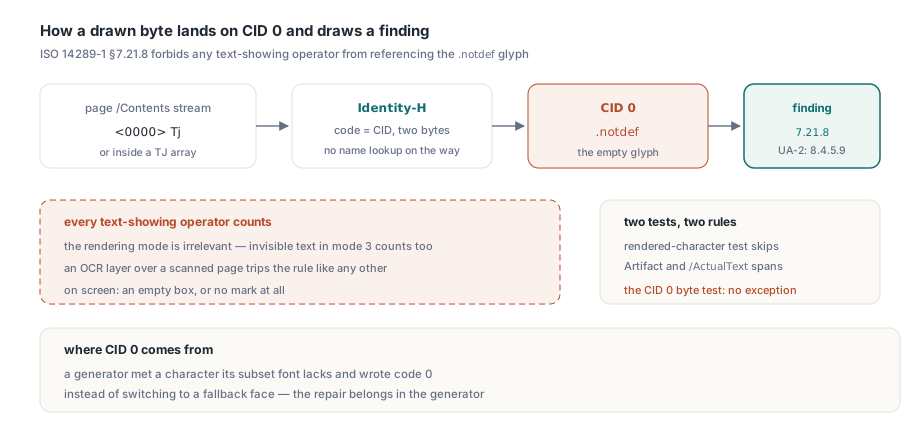
veraPDF は、1 つの Tj 演算子がバイト <0000> を出すだけで、ISO 14289-1 §7.21.8 によりタグ付き四半期レポートを落とします。Identity-H の下でこれは CID 0、つまり .notdef グリフを意味します。この条項と、その隣の §7.21.6——TrueType の /Differences 配列が使ってよいグリフ名を限定する——は、Delphi では PDFium Component の TPdf.ValidatePdfUa の結果に別々のフラグとして現れます
どのテキスト演算子が .notdef グリフを参照するか
オペランドがグリフ 0 に写るテキスト表示演算子はすべてです。単純フォントでは、.notdef はグリフ名です。CID キー付きフォントでは同じ役割が CID 0 に属し、ISO 32000-2 の §9.7.4.2 は、すべての CIDFont に CID 0 のグリフ記述を含めるよう求めます。「単純フォントの .notdef 文字名に準じたもの」として。通常の Identity-H エンコーディングでは文字コードと CID は同じ 2 バイトなので、<0000> を Tj で、あるいは TJ 配列の中で出すコンテンツストリームは、CID 0 を描いています。ISO 14289-1 の §7.21.8 はこれを禁じ、PDF/UA-2 は §8.4.5.9 で同じ要求を述べます。テキストレンダリングモードは無関係です。モード 3 の不可視テキスト、たとえばスキャンページ上の OCR レイヤーも、カウントに入ります。画面では結果はたいてい数ポイント幅の空箱か、まったくの無印で、どちらも読み校閲者に文字が消えたことを告げません
いつもの源は、サブセットフォントにない文字に出会ったジェネレータが、フォールバックの書体に切り替えるべき場所でコード 0 を書いたものです。おかげでバイトレベルのチェックは快いほど正確です。各ページの /Contents が参照するストリームだけをデコードし、Type 0 フォントを使う文書で <0000> が Tj や TJ に流れ込んでいないか探し、画像、ICC プロファイル、CMap は圧縮のままにします。ページを見つけられるかどうかを決めるパースの細部が 1 つあります。ISO 32000-1 の §7.3.5 は name トークンを次の区切り文字で終わらせるので、スペースなしの /Type/Page は有効なページ辞書であり、スペース入りの /Type /Page を探す検索はそれを飛ばします。Differences 配列の中で /.notdef を名指すこと自体はこの規則に触れません。そのスロットに着地するコードを出したときだけ触れます
どの /Differences グリフ名が Unicode 適合と数えられるか
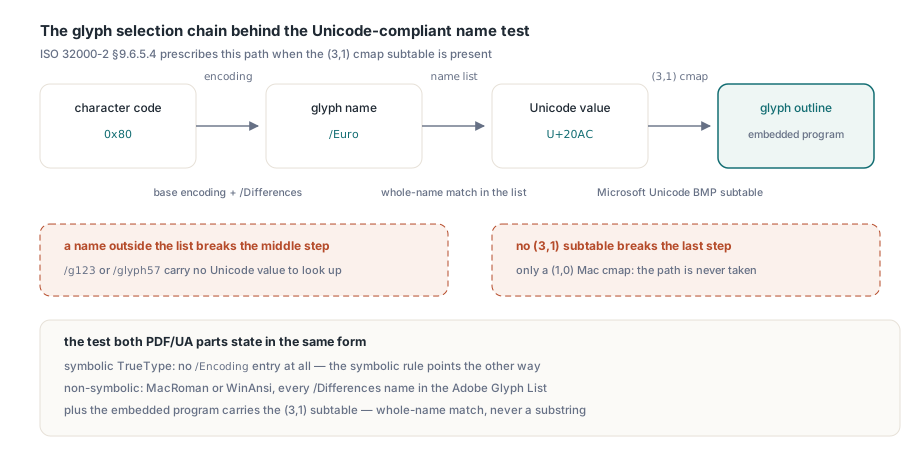
Adobe Glyph List に載っている名前です。ただし埋め込みフォントプログラムも (3,1) cmap サブテーブルを含むことが条件です。背景は ISO 32000-2 の §9.6.5.4 で、非シンボリック TrueType フォントには Differences 配列なしの MacRomanEncoding か WinAnsiEncoding を推奨しています。PDF/UA はこの助言を、1 つの逃げ道付きの要求に変えます。両方の PDF/UA パートは、veraPDF が適用するのと同じ形でテストを述べます。フォントがシンボリックであること、または エンコーディングが MacRoman か WinAnsi で、/Differences 配列がないか、配列のすべての名前が Unicode 適合であること。(3,1) の条件は、そのサブテーブル(Microsoft プラットフォーム、Unicode BMP)があるとき §9.6.5.4 が定めるグリフ選択順から出ます。文字コードはエンコーディングを経てグリフ名へ、グリフ名は Adobe Glyph List を経て Unicode へ、Unicode は (3,1) サブテーブルを経てグリフへ。リスト外の名前は中間の一歩を壊し、サブテーブルのないフォントはその経路を決して取りません。シンボリックフォントの規則は逆方向を指します。シンボリックな TrueType フォントは /Encoding エントリを一切運んではなりません
| フォント辞書 | 結果 |
|---|---|
非シンボリック、/Encoding /WinAnsiEncoding、Differences なし | 合格 |
非シンボリック、WinAnsi ベース、/Euro /bullet /.notdef の Differences、フォントは (3,1) cmap を持つ | 合格 |
非シンボリック、/g123 や /glyph57 を含む Differences | 不合格: 名前がグリフリストにない |
| 非シンボリック、有効な Differences、埋め込みフォントは (1,0) Mac cmap だけ | 不合格: (3,1) サブテーブルがない |
非シンボリック、Differences 付きの WinAnsi ベース、FontFile2 未埋め込み | この規則では判定しない。埋め込み規則(§7.21.4)が落とす |
非シンボリック、/Encoding エントリなし | 不合格 |
シンボリック、どんな /Encoding エントリでも | シンボリック規則で不合格 |
2 行目は、自作のグリフリストが踏み外れる場所です。veraPDF がフォントコードと一緒に同梱するリスト、font/AdobeGlyphList.txt は 4,282 エントリを持ち、その最初の行は .notdef 0000 です。手組みや他ソース由来の表はたいていそのエントリを欠きます。.notdef は実在の文字を表さないからです。そういう表に載せたチェッカーは、Differences 配列に /.notdef と書いたフォントをすべて報告します。使わないスロットをそれで埋めるサブセットフォントには、この名前がしょっちゅう現れるのに、です。照合は名前全体で行われます。部分一致なら、/grave がリストにあるだけで /grav を受けてしまいます。使わない Differences スロットは .notdef で自由に埋めて構いません。veraPDF に従うチェッカーは受け入れます
フォント規則は作成者が書いたバイトで判定される
自然な近道は、正規化したコピーを保存してそれをスキャンすることです。書き直されたファイルのほうがパースしやすいので。フォント規則では、これは失敗します。PDF を再シリアライズするツールはどれも、フォント辞書を組み直して構いません。Differences 配列を新しいエンコーディングへ折り込み、グリフを改名し、オブジェクトを振り直します。だからエンコーディング規則は、作成者が書いたバイトに対して検査されねばなりません。TPdf.ValidatePdfUa は読み込んだファイルやメモリバッファに対してフォントテストを走らせ、TrueType のテーブルディレクトリへ届くために FontFile2 ストリームを直接デコードします。文字レベルのテスト(描かれた文字が Unicode 0 に写るか)はページが描画するテキストを使い、Artifact と印されたものや /ActualText で覆われたものは飛ばします。CID 0 のバイトテストにその例外はありません。指摘は issue 集合に別々の値として届くので、レポートはどの規則が発火したかを述べられます:
uses
  SysUtils, PDFium, FPdfPdfua;

procedure ReportFontFindings(const FileName: string);
const
  FontIssues: TPdfUaValidationIssues = [pvuaiPdfiumNotDefGlyph,
    pvuaiTrueTypeEncodingInvalid, pvuaiSymbolicTrueTypeEncoding,
    pvuaiFontNotEmbedded, pvuaiFontMissingToUnicode];
var
  Pdf: TPdf;
  Report: TPdfUaValidationResult;
  Found: TPdfUaValidationIssues;
  Coverage: TPdfUaUnicodeCoverageReport;
  I: Integer;
begin
  Pdf := TPdf.Create(nil);
  try
    Pdf.FileName := FileName;
    Pdf.Active := True;
    if not Pdf.Active then
      raise Exception.CreateFmt('Cannot open %s', [FileName]);
    Report := Pdf.ValidatePdfUa;
    Found := Report.Issues * FontIssues;
    if pvuaiPdfiumNotDefGlyph in Found then
    begin
      Writeln('Text references .notdef / CID 0 (7.21.8, 8.4.5.9)');
      // Unicode 値に写らない描画文字を特定する
      Coverage := Pdf.InspectPdfUaUnicodeCoverage;
      for I := 0 to High(Coverage.Objects) do
        if Coverage.Objects[I].MissingUnicodeCharacterCount > 0 then
          Writeln(Format('  page %d, object %d: %d character(s)',
            [Coverage.Objects[I].PageNumber,
             Coverage.Objects[I].PageObjectIndex,
             Coverage.Objects[I].MissingUnicodeCharacterCount]));
    end;
    if pvuaiTrueTypeEncodingInvalid in Found then
      Writeln('Non-symbolic TrueType encoding or Differences (7.21.6, 8.4.5.7)');
    if pvuaiSymbolicTrueTypeEncoding in Found then
      Writeln('Symbolic TrueType font carries an /Encoding entry');
    if pvuaiFontNotEmbedded in Found then
      Writeln('A font program is not embedded (7.21.4)');
    if pvuaiFontMissingToUnicode in Found then
      Writeln('A font has no usable Unicode mapping (7.21.7)');
    if Found = [] then
      Writeln('No font findings');
    // Differences 配列の /g123 だけが欠陥のファイルに対する期待値:
    // 7.21.6 の 1 行だけ
  finally
    Pdf.Free;
  end;
end;
修復はファイルを書いたプログラムの中にある
どちらの指摘も、辞書を後から編集して安全に直せません。CID 0 の参照は、使われたフォントにその文字のグリフがなかったことを意味するので、ジェネレータにはその文字のためのフォールバック書体が要ります。<0000> を別のコードへ書き直すと、任意のグリフが描かれ、間違った Unicode 値が付きます。/g123 といった名前の Differences 配列は、たいてい、標準名を持たないグリフのフォントをサブセットした結果です。きれいな修復は、その書体を CID キー付き TrueType フォントとして埋め込むことです。CID Type 2 フォント埋め込みで使う構成で、Identity-H と /ToUnicode CMap 付き。これで単純フォントのエンコーディング規則は表から外れます
§7.21.6 を消すために Symbolic フラグを立てるのは間違った手です。シンボリックな TrueType フォントは /Encoding を一切運べません。スクリーンリーダーにどのコードがどの文字かを教えていた Differences の名前も一緒に消え、すべてのビューアは生のコードで (3,0) か (1,0) サブテーブルを通ってグリフを選びます。フラグは消えます。テキストの意味も一緒に
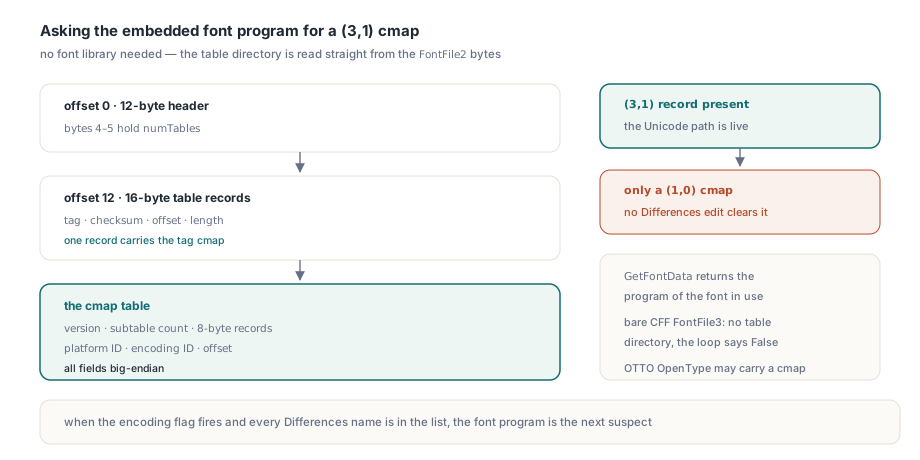
埋め込みフォントプログラムに (3,1) cmap はあるか
フォントプログラムに直接聞きましょう。エンコーディングのフラグはテストの両半分を覆い、どちらが落ちたかは語らないので。発火して、しかもすべての Differences 名がリストに載っているなら、次の容疑者はプログラムです。TrueType ファイルは 12 バイトのヘッダーで始まり、そのバイト 4〜5 がテーブル数を抱え、16 バイトのテーブルレコード(タグ、チェックサム、オフセット、長さ)が続きます。cmap テーブルはバージョンとサブテーブル数で始まり、プラットフォーム ID、エンコーディング ID、オフセットの 8 バイトレコードが続き、すべてビッグエンディアンです。フォントライブラリは不要です。TPdf.GetFontData はページオブジェクトが使うフォントの埋め込みプログラムを返すので、ヘルパーはページ上のすべてのテキストオブジェクトに回せます:
function BE16(const B: TBytes; P: Integer): Integer;
begin
  Result := (B[P] shl 8) or B[P + 1];
end;

function BE32(const B: TBytes; P: Integer): Cardinal;
begin
  Result := (Cardinal(B[P]) shl 24) or (Cardinal(B[P + 1]) shl 16) or
    (Cardinal(B[P + 2]) shl 8) or B[P + 3];
end;

// TrueType プログラムが (Platform, Encoding) の cmap サブテーブルを持つとき True
function HasCmapSubtable(const Font: TBytes; Platform, Encoding: Integer): Boolean;
var
  Tables, I, Rec, CmapOfs, Count: Integer;
begin
  Result := False;
  if Length(Font) < 12 then
    Exit;
  Tables := BE16(Font, 4);
  CmapOfs := -1;
  for I := 0 to Tables - 1 do
  begin
    Rec := 12 + I * 16;
    if Rec + 16 > Length(Font) then
      Exit;
    if (Font[Rec] = Ord('c')) and (Font[Rec + 1] = Ord('m')) and
       (Font[Rec + 2] = Ord('a')) and (Font[Rec + 3] = Ord('p')) then
      CmapOfs := Integer(BE32(Font, Rec + 8));
  end;
  if (CmapOfs < 0) or (CmapOfs + 4 > Length(Font)) then
    Exit;
  Count := BE16(Font, CmapOfs + 2);
  for I := 0 to Count - 1 do
  begin
    Rec := CmapOfs + 4 + I * 8;
    if Rec + 8 > Length(Font) then
      Exit;
    if (BE16(Font, Rec) = Platform) and (BE16(Font, Rec + 2) = Encoding) then
      Exit(True);
  end;
end;

// Mac Roman (1,0) の cmap しか持たないフェイスは cmap(3,1)=False と印字する
procedure ListTextFonts(Pdf: TPdf; PageNo: Integer);
var
  I: Integer;
begin
  Pdf.PageNumber := PageNo;
  for I := 0 to Pdf.ObjectCount - 1 do
    if Pdf.ObjectType[I] = otText then
      Writeln(Format('%-32s embedded=%-5s cmap(3,1)=%s', [
        string(Pdf.GetFontBaseName(I)),
        BoolToStr(Pdf.GetFontIsEmbedded(I), True),
        BoolToStr(HasCmapSubtable(Pdf.GetFontData(I), 3, 1), True)]));
end;
フォントを共有するテキストオブジェクトは同じ行を何度も印字します。ここでは無害です。素の CFF プログラム(/Type1C や /CIDFontType0C 付きの FontFile3)にはテーブルディレクトリがないので、ヘルパーは False と答えますが、この規則は TrueType フォントの話なので、その答えはここでは何も決めません。CFF アウトラインの OpenType フォントは違います。OTTO タグの sfnt ディレクトリを運び、cmap を含むこともあり、同じループがそれを見つけます。プログラムがメモリにあるうちに、hmtx の送り幅をフォント辞書の /Widths と比べるのも価値があります。PDF/UA には幅整合性の独立した規則があり、グリフ幅、CharSet、CIDSet の監査が PDFlibPas 側からそれを適用します
§7.21.6 のフラグの背後の書体に対して HasCmapSubtable が False を返すなら、その Differences 配列へのどんな編集も指摘を消せず、ジェネレータはその書体を ToUnicode CMap 付きの Type 0 フォントとして埋め込む必要があります。PDFium Component for Delphi で、再生成したファイルに対して検証をもう一度走らせ、pvuaiTrueTypeEncodingInvalid が Report.Issues から消えていることを期待しましょう