FDFをフォームにインポートすると、フィールド値が微妙に間違って戻ってきます。箇条書き記号が短剣符として、省略記号がemダッシュとして届きます。PDFium Componentはこの症状の一族全体を、自社のPDFDocEncodingテーブルの1行に追跡しました。ISO 32000-1のAnnex D.2の特殊文字ブロックは$7Fではなく$80から始まります
FDFインポートが隣の文字を返す理由
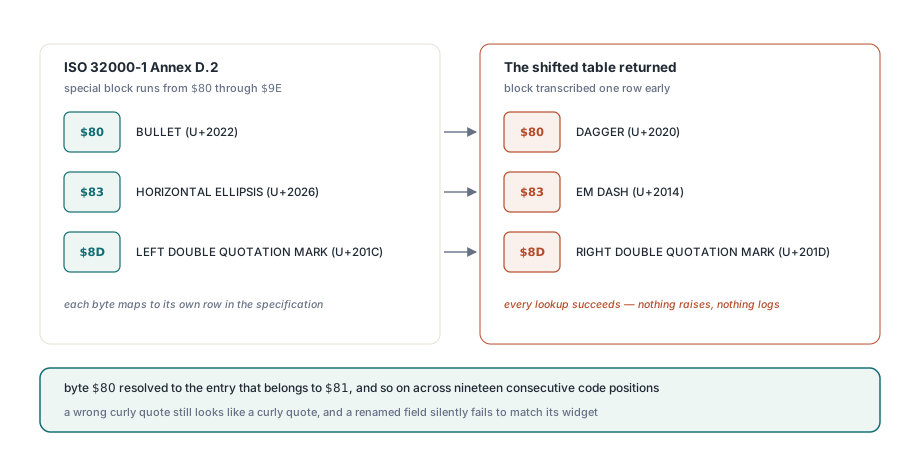
1位置ずれたエンコーディングテーブルも、依然として完全に有効に見えるテーブルであり、その中のすべてのルックアップは成功するからです。Annex D.2が$80から$9Eに割り当てるブロックは、1行早く書き写されていました。そのためバイト$80は$81に属するエントリに解決され、バイト$81は$82のエントリに解決され、19個の連続するコード位置にわたって同じことが続きました。何も例外を上げず、何もログされず、どのフィールドも拒否されませんでした。TPdf.ImportFDFはいつもと同じフィールド数を報告しました
被害は一様で、静かでした。Annex D.2がBULLET(U+2022)と定義する$80を運ぶバイトは、DAGGER(U+2020)として戻ってきました。バイト$83、HORIZONTAL ELLIPSIS(U+2026)はEM DASH(U+2014)として戻りました。バイト$8D、LEFT DOUBLE QUOTATION MARK(U+201C)はRIGHT DOUBLE QUOTATION MARK(U+201D)として戻りました——誰も気づかないケースです。間違ったカール引用符も、フォームフィールドではカール引用符に見えるからです。フィールド名もフィールド値と同じ運命をたどり、それはさらに悪いものです。ドキュメント内のウィジェットと一致しなくなった名前は、静かに適用に失敗します
PDFテキスト文字列は2つの異なるエンコーディングを持つ
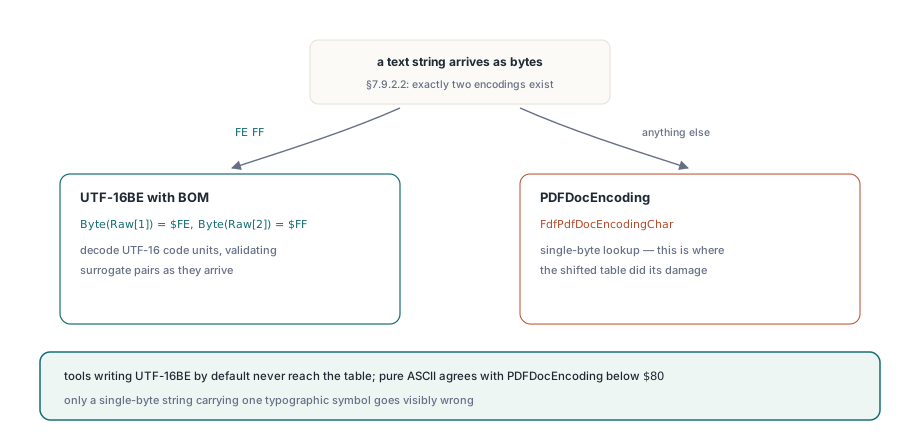
ISO 32000-1 §7.9.2.2は、テキスト文字列型を正確に2つのエンコーディングのどちらかとして定義し、辞書エントリではなく最初の2バイトの検査で選択します。バイトオーダーマークFE FFで始まる文字列はUTF-16BE、それ以外はすべてPDFDocEncodingです。この単一の分岐が、2つのまったく異なるデコーダのどちらを実行するかを決め、PDFium Componentは1文字に触れる前にFDFパーサ内でこれを適用します
// FDFテキスト文字列:BOMがあればUTF-16、なければPDFDocEncoding
if (Length(Raw) >= 2) and
   (((Byte(Raw[1]) = $FE) and (Byte(Raw[2]) = $FF)) or
    ((Byte(Raw[1]) = $FF) and (Byte(Raw[2]) = $FE))) then
begin
  BigEndian := Byte(Raw[1]) = $FE;
  // ... UTF-16コード単位をデコードし、サロゲートペアを検証
end
else
begin
  SetLength(Result, Length(Raw));
  for I := 1 to Length(Raw) do
    Result[I] := FdfPdfDocEncodingChar(Byte(Raw[I]));
end;これが、このバグが通常のテストでこんなに長く隠れた理由です。デフォルトでUTF-16BEを書くツールが生成したFDFは、FdfPdfDocEncodingCharにまったく到達しません。ずれたテーブルは休眠したままなのです。単一バイトの文字列だけが——多くのFDFジェネレータがプレーンなラテン文字のフィールド名に対して、短いからという理由で出力するのはこれです——テーブルが重要になる分岐を下っていきます。純粋なASCIIのフィールド名は、$80より下ではPDFDocEncodingとASCIIが一致するため、いずれにせよ正しくデコードされます。何かが目に見えて壊れるには、1つの活版記号を含む単一バイト文字列が必要です
修正されたテーブルと、それを固定する2つのアンカー
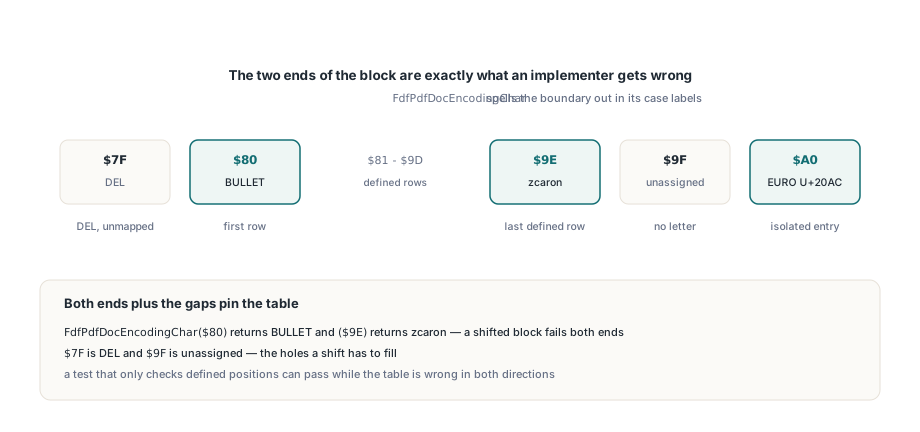
PDFium Componentは現在、FdfPdfDocEncodingChar自体で境界を明示しています。ブロックの両端こそ、実装者が間違えるまさにその場所だからです。$7FはDELで、PDFDocEncodingの意味をまったく持ちません。ブロックは$80のBULLETで始まり、$9Eのzcaronまで続きます。$9Fは未割り当てで、ユーロ記号は$A0に単独で座ります
function FdfPdfDocEncodingChar(Value: Byte): WideChar;
begin
  case Value of
    // ISO 32000-1 Annex D.2。ブロックは$7Fではなく$80から始まる:$7FはDELで
    // PDFDocEncodingの意味を持たず、ユーロは$A0に座る。デフォルト分岐では
    // ノーブレークスペースとして返されてしまう
    $7F: Result := WideChar($FFFD);
    $80: Result := WideChar($2022);   // BULLET、ブロックの最初の行
    $81: Result := WideChar($2020);   // DAGGER
    // ... $82 through $9D
    $9E: Result := WideChar($017E);   // zcaron、最後に定義された行
    $9F: Result := WideChar($FFFD);   // Annex D.2で未割り当て
    $A0: Result := WideChar($20AC);   // EURO SIGN
  else
    Result := WideChar(Value);
  end;
end;そのずれが両端に何をしたかを見てください。オフバイワンが外観上の問題でなくなるのは、まさにここです。zcaronは仕様では$9Eでしたが、ずれたテーブルでは$9Dにありました。そのため文書のバイト$9Eは、誰かが書き写した最後の行を越えて、IDフォールバックにまっすぐ落ち、文字の代わりにC1制御文字を返しました。そしてユーロの$A0は、そもそもテーブルに書き込まれていませんでした。ID分岐はそれをU+00A0 NO-BREAK SPACEとして返し、この文字はその後のすべての検証を生き延び、何も印字せず、探しているフィールド名に決して一致しません
書き写したエンコーディングテーブルをどうテストするか
最初の行、最後の行、そしてギャップをテストしましょう。中間のサンプルではありません。これは、仕様からコピーする他のどんなテーブルにも持ち込む価値のある修正の一部です。ブロック中間のスポットチェックこそ、ブロック全体のずれが生き残るまさにそのテストだからです。$8Dが左二重引用符を与えることを検証しても、$8Cも同様にもっともらしいものを与えるなら何も証明しません。$80がBULLET、$9Eがzcaronを与えることを検証すれば両端が固定され、ずれたブロックは両方を同時に満たせません
procedure CheckPdfDocEncodingAnchors;
begin
  // Annex D.2特殊ブロックの両端:ブロック全体のずれはこれらを壊す
  Assert(FdfPdfDocEncodingChar($80) = WideChar($2022), 'first row: BULLET');
  Assert(FdfPdfDocEncodingChar($9E) = WideChar($017E), 'last row: zcaron');
  // 仕様が未定義のまま残すコード位置は、文字にデコードされてはならない
  Assert(FdfPdfDocEncodingChar($7F) = WideChar($FFFD), '$7F is DEL, unmapped');
  Assert(FdfPdfDocEncodingChar($9F) = WideChar($FFFD), '$9F is unassigned');
  // ブロックの上の孤立エントリ。完全に省くのが簡単
  Assert(FdfPdfDocEncodingChar($A0) = WideChar($20AC), 'EURO SIGN');
end;未定義の位置は、面白くないからとスキップされるのではなく、独自のアサーションに値します。オフバイワンは何かをどこかに置かなければならず、それを置く場所はほとんどの場合、仕様が空のまま残したコード位置です——前が$7F、後ろが$9F。定義済みの位置だけをチェックするテストは、テーブルが両方向で間違っていても通ることがあります。穴を固定するテストは、最初の実行でずれを捕捉します
ラウンドトリップフォームワークフローでのこのコスト
記号ごとに1文字を静かに書き換えるFDFインポートは、失敗するものより悪いです。失敗は下流で表面化し、別の何かのように見えるからです。ここでの刃先はフィールド名です。TPdf.ImportFDFは、入ってくる名前を開いているドキュメント内のウィジェットと照合し、1文字間違ってデコードされた名前は単純に一致しません——フィールドは空のままで、戻り値は依然としてフィールドをパース済みとして数え、パイプラインから出るレポートは、理由を説明するログが何もないまま値が1つ不足します。PDFium ComponentでXFDFフォームデータと注釈をエクスポート・インポートするで説明されているようなエクスポート&再インポートループを構築する人は、ループを信頼する前に、プレーンなASCIIだけでなく活版記号を含むフィールド名をラウンドトリップさせるべきです
修正の限界について正直になる価値もあります。テーブルは現在、256すべてのバイト値についてAnnex D.2と一致し、単一バイトのFDF文字列は正しくデコードされます。しかしPDFDocEncoding自体はラテン文字のレパートリーをカバーするだけで、それ以上はありません。その外のものは、BOM付きUTF-16BEとして届かなければならず、それはまさに§7.9.2.2の意図です。また、UTF-16文字列はDelphi側に独自の別の危険をまだ抱えています。U+FFFFを超えるコードポイントは、1つのWideCharではなくサロゲートペアを必要とし、その問題はDelphiでemojiとCJK文字がWideCharを壊す理由で扱われています。より広いポイントはエンコーディングテーブルを越えて一般化します。PDFパーサは、受け入れるべきものを拒否することができ、それはすぐに見つかります。あるいは受け入れて静かに間違えることができ、それは本番で見つかります。PDF辞書を安全にパースするで説明されている名前トークンの罠は2番目のカテゴリに属し、1行ずれたテーブルも同じです——コードパスは成功し、戻り値はもっともらしく見え、実装ではなく仕様に対して書かれたテストだけが異を唱えます
TPdfのImportFDF、ExportFDF、ImportXFDFと、その背後にあるFDFおよびXFDFパーサは、DelphiとC++Builder向けの標準PDFium Componentの一部です