40 ページの PDF から 3 ページをコピーするのに 2 分かかるのは、チューニングの問題ではありません。間違った API パスを使っているというサインです。HotPDF Delphi Component の上に組まれたページコピーコードで、このタイミングを最初に目にしたとき、私は文書構造を先に、コードを後に見ようとしました。この順番こそが裏目に出たのです
実際に遅かった部分
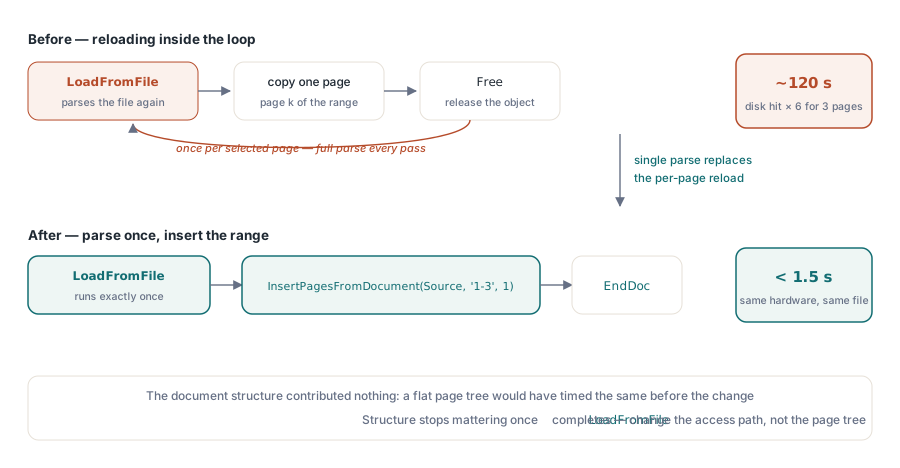
問題の PDF は、40 ページのリファレンス文書で、ページツリーが一筋縄ではありません。単一のフラットな配列ではなく、複数の中間 /Pages ノードがあります。問題のコードは、LoadFromFile を呼んだ後、BeginDoc で新しい文書を組み立て、選択されたページ番号をループし、各反復ごとにソース文書をディスクからもう一度ロードして 1 ページを引き抜いていました。フルパースのコストに、欲しいページ数を掛けているのです。3 ページの抽出のために 12 MB のファイルが 6 回ディスクを叩いたのは、ファイルを反復の間ずっと開いたままにすべきか、誰も確認しなかったからです
2 つ目の要因はコードには見えませんでした。HotPDF の LoadFromFile は、編集 API が土台にするインメモリのオブジェクトモデルを組み立てます。修正しようとしている文書にはそれが正しい挙動ですが、ページ数とページのサブセットが欲しいだけなら、必要のない仕事です。構造への読み取り専用アクセスには DAOpenFileReadOnly があり、オブジェクトツリー全体のデシリアライズを避けられます。大きな画像リソースを持つ圧縮ファイルでは、この差が効いてきます
どちらも、ある仕事のために設計された API を選んで、別の仕事に使っていることに尽きます
ページ抽出に ExtractPagesToFile を使う
ロード済みの HotPDF 文書からページ範囲を新しいファイルへコピーする正しい道は ExtractPagesToFile で、ソースに LoadFromFile を呼んだ後に呼びます。ソースは 1 回だけロードすればよく、この呼び出しが宛先文書を組み立て、選択されたページをそこへコピーし、ディスクへ書き出します。すべて、すでにメモリにあるコピーの上で行われます
procedure ExtractPages(const SourceFile, DestFile: string;
  const PageRange: string);
var
  Source: THotPDF;
begin
  Source := THotPDF.Create(nil);
  try
    // ソースは 1 回だけロードする: フルパースはここで、ここでしか起きない
    if Source.LoadFromFile(SourceFile) <= 0 then
      raise Exception.Create('Source PDF has no pages');

    // 要求された範囲 ('1-3', '1,5,7-9') をそのまま新ファイルへ書く
    Source.ExtractPagesToFile(DestFile, PageRange);
  finally
    Source.Free;
  end;
end;
PageRange パラメーターは、コマンドラインのサンプルと同じ形式を受け取ります。ページ番号や範囲をカンマでつないだリスト、たとえば '1-3' や '1,5,7-9' です。ページは 1 始まりです。ExtractPagesToFile は、選択された各ページを、そこから参照されるコンテンツストリームとリソースごとまとめてコピーするため、40 ページの文書からの 3 ページ抽出でもワーキングセットは小さいままです
以前 2 分かかっていた同じ 12 MB のファイルでの計測では、このパターンで約 1.3 秒でした。その大半は 1 回の LoadFromFile 呼び出しです。オブジェクトテーブルを一度解決してしまえば、文書構造はもう無関係です
LoadFromFile が過剰な場合:Direct File API
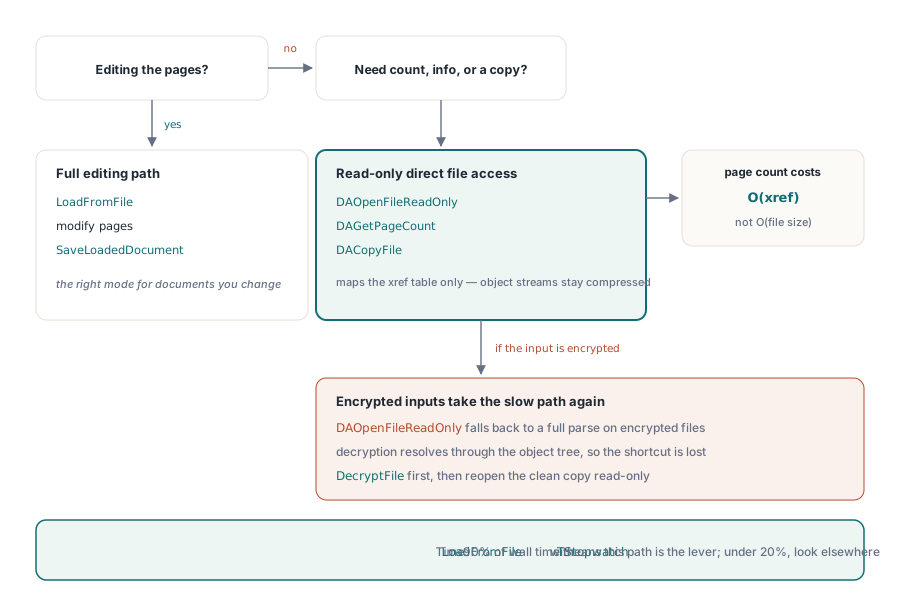
ページ数を数えたり、ドキュメント情報を調べたり、コンテンツに触れることなくファイルをコピーしたりするだけでよい場合は、Direct File API を使用することで完全な解析を完全に回避できます。DAOpenFileReadOnly はオブジェクトストリームを解凍せずにクロスリファレンステーブルをマッピングするため、ページ数は O(ファイルサイズ) ではなく O(xref サイズ) になります
procedure InspectPDF(const FileName: string);
var
  Pdf: THotPDF;
  Handle, PageCount: Integer;
begin
  Pdf := THotPDF.Create(nil);
  try
    Handle := Pdf.DAOpenFileReadOnly(FileName, '');
    if Handle <= 0 then
      Exit;
    try
      PageCount := Pdf.DAGetPageCount(Handle);
      Writeln('Pages: ', PageCount);

      // DACopyFile はバイトを保持したコピーであり、再シリアライズは行いません
      Pdf.DACopyFile(FileName, 'archive-copy.pdf');
    finally
      Pdf.DACloseFile(Handle);
    end;
  finally
    Pdf.Free;
  end;
end;注意点:DAOpenFileReadOnly はパスワードパラメーターを受け入れますが、復号化には暗号化辞書を解決するためのオブジェクトツリーが必要なため、暗号化された入力の場合は完全な解析にフォールバックします。ソースファイルが暗号化されている場合は、まず DecryptFile を使用して復号化し、暗号化されていないコピーを取得してから、Direct File API で開きます。ファイルレベルの DecryptFile 関数は、標準の暗号化に対して直接的な AES-256 書き換えパスを使用し、完全なインメモリのオブジェクトモデルを構築しないため、大きなファイルに対して LoadFromFile に続いて SaveLoadedDocument を呼び出すよりも高速です
大規模バッチ処理時のメモリ
数十のファイルをループ内で処理するバッチジョブには、正しく見えてメモリを蓄積するパターンがあります。それは、ループ内で THotPDF を作成し、LoadFromFile を呼び出し、処理を行い、Free を呼び出すというものです。これは構造的には問題ありません。問題は、内部の処理でスクラッチオブジェクトを割り当て、例外をキャッチし、エラーパスでそれらのスクラッチオブジェクトを有効なままにしておく場合です。Delphi のメモリマネージャーはコンパクションを行わないため、バッチ実行全体で100回のエラーパスによるリークが発生すると、他のすべてのメモリ割り当てが遅くなるほどメモリが高くなる可能性があります
修正は特別なものではありません。PDF 処理に関与するすべての THotPDF と、すべての中間 TStream または TBitmap は、Free を最後のステートメントとする try/finally ブロックに属します。try の前にローカルポインターを nil に設定することで、初期化が途中で失敗した場合に、finally 分岐で if Assigned(x) then x.Free を安全に使用できます。これは標準的な Delphi の所有権の規律であり、このクラスの問題に対する完全な説明です
バッチ文脈でもう 1 つ知っておくべきことがあります。AddImage は各画像を、構築中の文書に対して登録します。HotPDF はその登録を、EndDoc がそのファイルを締めたときに解放します。このレジストリは LoadFromFile ではなく BeginDoc/EndDoc のサイクルに従うため、バッチのきれいなパターンは、1 文書につき 1 つの THotPDF インスタンスです。作り、仕事をし、保存し、解放する
何か変更する前の測定
これらのパターンのいずれかに手を伸ばす前に、測定してください。System.Diagnostics の Delphi の TStopwatch は QueryPerformanceCounter をラップしており、ファイル I/O のウォールクロックプロファイリングに十分な精度があります。LoadFromFile だけをラップして、どのくらいの時間がかかるかを確認します。それが合計時間の 90% を占める場合、解決策は Direct File API か、同じファイルの解析回数を減らすことです。20% 未満の場合、ボトルネックは別の場所にあり、間違ったものを追いかけています
この記事の発端となった 2 分の抽出は、すべて repeated-load パターンの仕業でした。文書構造は何も寄与していません。フラットなページツリーでも同じように走っていたはずです。1 回の LoadFromFile の後に 1 回の ExtractPagesToFile 呼び出しへ切り替えたところ、他は何も触らずに、同じハードウェアで約 1.3 秒になりました
ここに示されているページ操作 API は、Delphi および C++Builder 用の HotPDF Delphi Component の一部です