セルに=NORM.DIST(115,100,15,TRUE)と入力すると、Excelは何の前置きもなく0.8413447を返します。この呼び出しは表引きのように見えますが、そうではありません。その1つの数値の背後にあるのは累積正規分布、つまり閉じた形を持たない積分です。CHISQ.INV.RTやBETA.DISTの背後にも、手作業で近似するのではなく丁寧に評価しなければならない特殊関数が控えています。Excel互換を謳うスプレッドシートコンポーネントは、Excelが表示する最後の桁までこれらの値を再現する必要があります。それは関数名をそろえることではなく、数値計算の手法そのものを再現するということです
HotXLSはこうした統計関数を50種類以上実装していますが、それを正しく動かしている作業は数式バーからはほとんど見えません。本稿は、エンジンがそれらをどう計算しているかをたどるものです。共有される特殊関数のコア、演算を安定させる分岐の判断、そして共通のケースが壊れた行に触れなかったために長く裾に潜んでいた逆正規分布のバグを取り上げます
1つのワークシート関数、その裏に50の分布
これらの関数は、統計を扱うワークブックが必要とするファミリーをひととおり網羅します。正規分布のファミリーにはNORM.DISTとNORM.S.DISTおよびその逆関数があり、ガンマとカイ二乗のファミリーにはGAMMA.DIST、CHISQ.DIST、CHISQ.DIST.RT、CHISQ.INV.RTがあります。ベータのファミリーはBETA.DISTとBETA.INV、標本分布はT.DIST、T.DIST.2T、F.DIST、F.INV、離散分布の組はBINOM.DISTとPOISSON.DIST、そして推測統計の補助関数としてCONFIDENCE.TやCONFIDENCE.NORMがあります。呼び出す側から見れば、どれも1つの数式にすぎません。セルに入力値を設定し、ワークブックに評価を依頼して、結果を読み取るだけです
var
  wb: IXLSWorkbook;
  sh: IXLSWorksheet;
begin
  wb := TXLSWorkbook.Create;
  sh := wb.Sheets.Add;
  sh.Range['A1', 'A1'].Value := 115;   // 観測値
  sh.Range['A2', 'A2'].Value := 100;   // 平均
  sh.Range['A3', 'A3'].Value := 15;    // 標準偏差

  // XLSの数式パーサーは引数の区切り文字として ';' を使う。
  Writeln(wb.Calculate('=NORM.DIST(A1;A2;A3;TRUE())'));   // 0.8413447
  Writeln(wb.Calculate('=CHISQ.INV.RT(0.05;10)'));        // 18.3070381
  Writeln(wb.Calculate('=BETA.DIST(0.5;2;3;TRUE())'));    // 0.6875
end;ワークブックのCalculateメソッドは、その場限りの数式を生きたシートに対してコンパイルおよび評価し、Variantを返します。最初に試すときにつまずきやすい点が1つあります。Calculateの背後にある数式パーサーは引数の区切り文字にセミコロンを使うため、=SUM(A1;B1)と書く必要があり、=SUM(A1,B1)ではありません。セルに保存される数式のほうはExcel標準のカンマのままです。以下で扱う統計関数はすべて同じ評価器がディスパッチするので、1つがCalculateで動けば、残りも同じ経路をたどります
すべての土台になっている2つの関数
この一群の累積分布のほとんどは、自身の定義を総和したり積分したりして計算されるわけではありません。実際には2つの特殊関数、すなわちP(a, x)と書かれる正則化下側不完全ガンマと、Ix(a, b)と書かれる正則化不完全ベータから計算されます。内部的にはこれらがディスパッチャの拠り所となるヘルパーであり、連鎖は短いものです。カイ二乗のCDFは、形状パラメータdf/2、尺度パラメータ2のガンマCDFそのものです。ガンマCDFはP(a, x)そのものです。t分布、F分布、二項分布の累積関数は、いずれも適切な引数における正則化不完全ベータの値です。ポアソンのCDFは上側不完全ガンマQです。ガンマとベータをきちんと実装すれば、十数個の分布がその精度をそのまま受け継ぎます
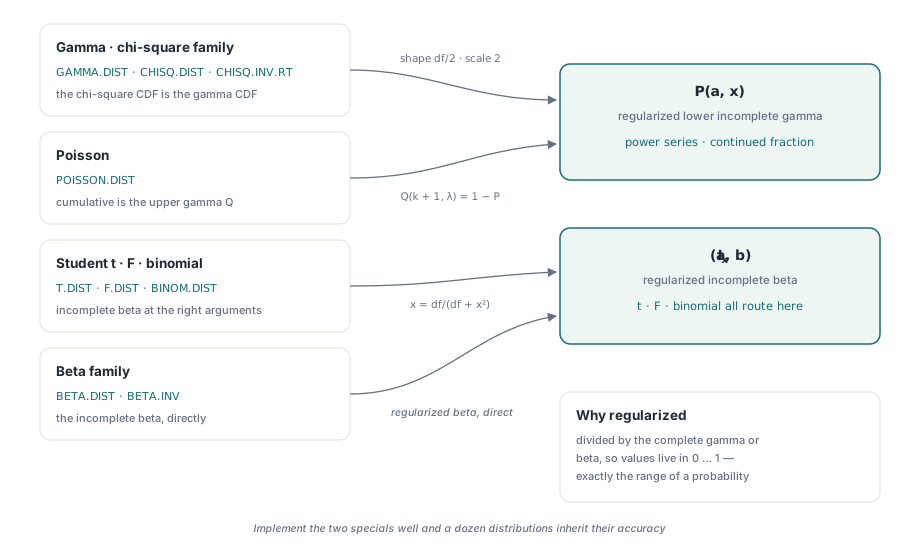
「正則化」という言葉こそが要点です。素の不完全ガンマは階乗のように増大し、素のベータ積分は答えが出るはるか手前でアンダーフローやオーバーフローを起こします。正則化された形は完全ガンマまたは完全ベータで割ってあるため、値は必ず0から1の区間に収まります。これはまさに確率が占める範囲です。この正規化があるおかげで、自由度2のカイ二乗にも自由度200のカイ二乗にも同じルーチンが使え、途中の項が倍精度の表現範囲から飛び出すこともありません。同時にこれは、密度の項を長い裾まで足し上げてCDFを求めない理由でもあります。各項はそれぞれ丸め誤差を抱えており、級数を進めるほど誤差が積み上がりますが、正則化された特殊関数は急速に収束する級数や連分数を評価することで、その総和自体を回避します
対角線の下は級数、上は連分数
不完全ガンマのルーチンは、何かを計算する前に1つだけ判断を行います。xをa + 1と比較するのです。この境界は恣意的なものではありません。P(a, x)のべき級数展開は、xがaに比べて小さいときは速く収束し、xが大きいときは遅く、やがて使い物にならなくなります。連分数はちょうど逆の性質を持ちます。そこでエンジンは、xがa + 1未満ならべき級数、a + 1以上ならLentzの連分数を使い、それぞれの分岐に得意な仕事だけをさせます
連分数には1つだけ安全装置が必要です。Lentzの方法は分子と分母を持ち回り、各ステップで分母を反転させるため、どちらかがゼロに近づくと反転が破綻します。対策はごく小さな下限値です。途中の項の絶対値がおよそ1e-30を下回ったら1e-30に丸め込むことで、収束後の値を乱すことなく漸化式を有限に保ちます。同じクランプは不完全ベータの連分数にも同じ理由で登場します。小さな定数が重い役割を担っており、安定した評価と、ゼロと見分けのつかない値による除算との分かれ目になっています
上側の裾Q(a, x)は単に1からP(a, x)を引いたものであり、ポアソンの累積分岐もそのように計算されます。平均λのもとで事象がk回以下となる確率はQ(k + 1, λ)です。k + 1個のポアソン項を足し合わせるのではなく上側不完全ガンマを経由させるのも、やはり小さな値を多数積み上げるのではなく収束の速い1つの式を評価するという選択です
階乗をあふれさせずに離散確率質量を求める
離散分布は別の危険をはらみます。二項確率質量には二項係数が含まれますが、52個から26個を選ぶ組み合わせの係数は途方もなく大きな整数です。そのまま計算すると、確率として妥当な値に戻すための除算を行う前に、分子が倍精度をあふれさせます。エンジンはこれを組み立てません。対数ガンマ関数を通じて階乗を対数空間で計算し、対数どうしを足し引きし、成功確率と失敗確率の対数を組み込み、最後に一度だけ指数関数を適用します
// 二項確率質量。すべて対数空間で評価する。
// LnGammaF(n+1) は ln(n!)。3つの対数階乗が ln(C(n,k)) を構成し、
// 指数部全体を組み立ててから Exp を1回だけ呼ぶ。
//   ln P(X=k) = ln(n!) - ln(k!) - ln((n-k)!) + k*ln(p) + (n-k)*ln(1-p)
result := Exp(LnGammaF(nt + 1) - LnGammaF(kk + 1) - LnGammaF(nt - kk + 1)
+ kk * Ln(pp) + (nt - kk) * Ln(1 - pp));対数ガンマ関数そのものはLanczos近似で、正の実軸全体にわたって精度が高く、評価も安価です。大きな量はすべて最後のExpまで対数のまま保持されるため、このルーチンが実体化する最大の数は確率そのもの、つまり高々1です。ポアソンの確率質量関数も同じ手順に従い、分母の階乗の代わりに対数ガンマの項が1つ立ちます。pがちょうど0または1になる端では閉じた形が特別扱いされるので、コードがLn(0)を呼ぶことはありません。HotXLSはBINOM.DIST(5,10,0.5,FALSE)に対して0.2460938を、累積のPOISSON.DIST(2,2,TRUE)に対して0.6766764を返し、Excelが表示する桁まで一致します
順方向の曲線を挟み込んで求める逆関数
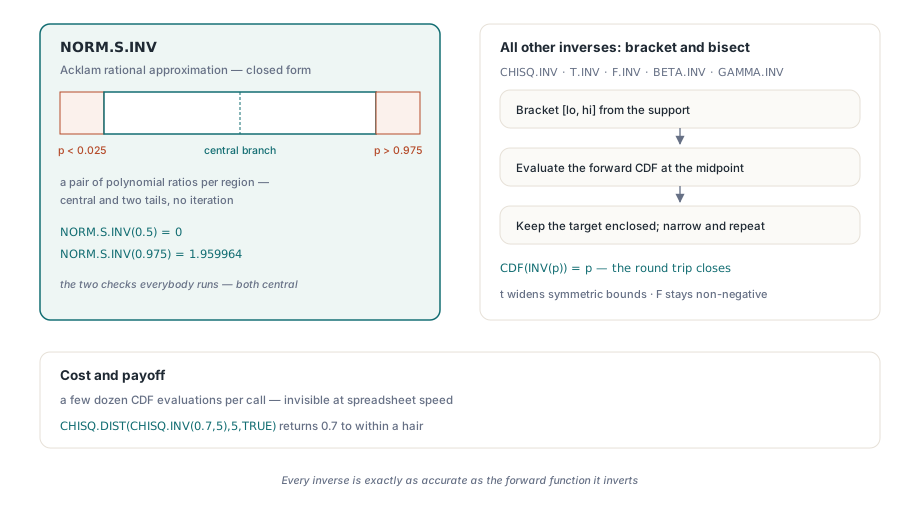
逆分布関数は逆の問いを立てます。確率が与えられたとき、CDFがその値になるxを求めよ、というものです。この一群で高速な直接式を持つ逆関数は1つだけです。標準正規分布の逆関数であるNORM.S.INVはAcklamの有理近似を使います。これは中央部と2つの裾に分けられた多項式の比の組で、全域にわたっておおむね倍精度の精度を持ちます。反復のない閉じた形の評価です
ほかの逆関数にはそのような式がないため、エンジンは数値的に反転します。分布の定義域から選んだ下限と上限で答えを挟み込み、二分法を適用します。中点で順方向のCDFを評価し、目的の確率を挟んだままになるほうの境界を動かし、区間が十分狭くなるまで繰り返すのです。ガンマとカイ二乗の逆関数では、下限を0、上限を形状と尺度から作った余裕のある推定値とし、確率がまだ挟まれていなければ上限を倍にしていきます。t分布の逆関数は対称な境界を外へ広げながら挟み込み、F分布の逆関数は非負の区間で二分します。コストは1回の呼び出しあたり数十回のCDF評価であり、スプレッドシートの速度では体感できません。その代わり、どの逆関数も反転元の順方向関数とまったく同じ精度になります。CHISQ.DIST(CHISQ.INV(0.7,5),5,TRUE)のような往復がほぼ誤差なく0.7を返すのはこのためです
裾に潜んでいた常用対数
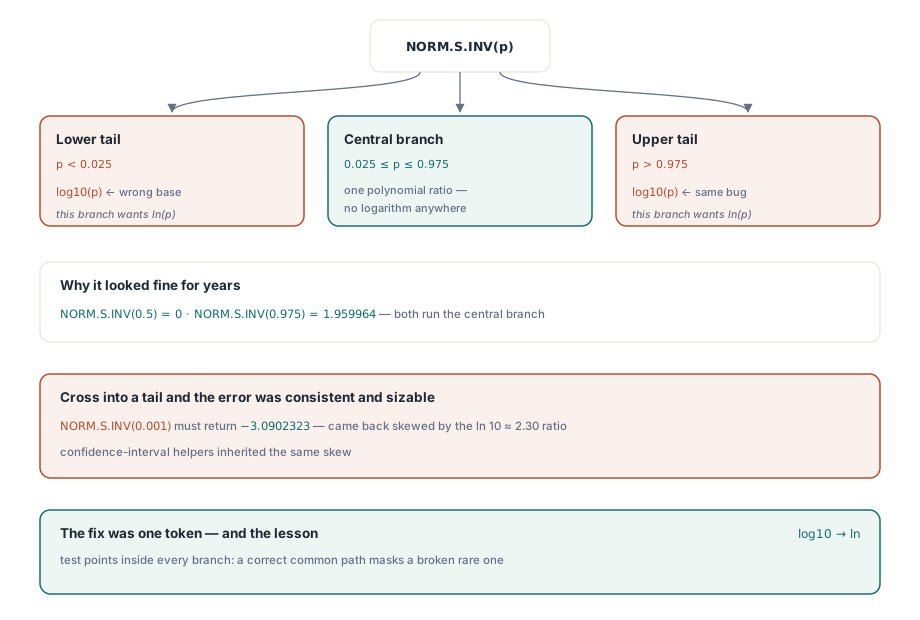
ここで語る価値のあるバグを紹介します。長く生き延びる類のものだからです。Acklamの逆正規ルーチンには3つの分岐があります。確率がおよそ0.025から0.975の間にあるときに使われる幅広い中央分岐は、対数をまったく含まない多項式の比に入力を通します。きわめて小さい確率と大きい確率に対する2つの裾分岐は、まず入力の対数を取ります。裾の振る舞いがpの自然対数の符号を反転したものの平方根に似ているからです
初期バージョンの裾分岐は、自然対数を使うべきところで常用対数を取っていました。両者はおよそ2.30という定数倍の差があるため、裾の結果は一定の、しかも無視できない幅でずれていました。それでも、ざっと確かめる限り関数は正常に見えました。そうした確認は中央部で行われるからです。NORM.S.INV(0.5)は0であり、NORM.S.INV(0.975)は教科書どおりの1.959964ですが、どちらも対数をまったく呼ばない中央の多項式を通ります。誤りが表に出るのは確率が裾に入ったときだけで、たとえばNORM.S.INV(0.001)は-3.0902323を返さなければならないのに、自然対数と常用対数の比の分だけずれた値が返っていました。裾で逆正規分布に依存する関数、たとえば信頼区間の補助関数も同じ歪みを受け継ぎます。教訓は平凡で、しかも高くつくものです。分岐構造を持つ関数には、すべての分岐の内側にテスト点が必要です。正しい共通経路は、壊れた稀な経路を平然と覆い隠すからです。修正は常用対数を自然対数に変える1トークンの変更で済み、裾の値はExcelにぴたりと合いました
xの符号がt分布の裾を決める
スチューデントのt分布の累積関数には、逆に取り違えやすい機微があります。その値はdf / (df + x²)における正則化不完全ベータから得られますが、そのベータの値はxの絶対値より外側の裾の確率であって、xまでの累積確率ではありません。t分布は左右対称なので、変換の仕方はxがゼロのどちら側にあるかで変わります
// スチューデントtのCDF。ib は df/(df+x*x) における正則化不完全ベータで、
// 対称な裾を測る値。累積値は x の符号によって決まり、
// ib を変換せずに返すと裾を取り違える。
ib := BetaIF(df / 2, 0.5, df / (df + x * x));
if x > 0 then
  result := 1 - 0.5 * ib        // 平均より上: 1 から裾の半分を引く
else if x < 0 then
  result := 0.5 * ib            // 平均より下: 裾の半分
else
result := 0.5; // ちょうど平均xがゼロより大きければ累積確率は1から対称な裾の半分を引いた値、ゼロより小さければその裾の半分、ゼロちょうどならきっかり0.5です。ベータの値をそのまま返すと分布の反対側を報告することになり、ゼロでないxではその差は曲線の胴体全体に及びます。右側裾と両側裾の変種も同じ分岐の上に構築されており、T.DIST.2T(1,1)が0.5を、T.DIST(1,1,TRUE)が0.75を返すのはそのためです。逆関数のT.INVもこの補正済みCDFに対して二分法を行うため、往復がきちんと閉じます
こうした事情はセルからは何も見えませんし、それこそが狙いどおりの結果です。数式を書き、Excelと一致する数値を読むだけで済みます。独自のロジックでエンジンを拡張したい場合、関数を登録する手順は数式エンジンとカスタム関数の解説記事で扱っており、数式がシートをまたいで名前付き範囲に届く仕組みは定義された名前とシート間数式の記事で扱っています。これらはすべてDelphiおよびC++Builder向けのHotXLS Delphi spreadsheet componentに含まれており、本ブログの他の記事で扱っている読み込み、書き込み、グラフ、書式設定のAPIと同梱されています