8枚のシートを持つ XLSX パッケージを8本のワーカースレッドでパースする Delphi ローダーでも、CPU グラフは1コア分ほどしか盛り上がらないことがあります。スレッド数を2から8まで動かしても、ストップウォッチの値はほとんど変わりません。スレッド2本では、平の直列ループよりむしろ遅くなることすらあります。パースコード自身はロックを取らず、シート同士もデータを共有しません。それでも待ちが発生するのは、ソースに一度も名前の出ていない場所、すなわちメモリマネージャの内部です。ワーカーは要素名、属性値、セルのそれぞれについてここを呼びます
スレッド数は誰もが最初に手を伸ばすつまみです。しかし割り当てがボトルネックのコードでは、ほとんど何も動きません。曲線を動かすのは、セル1個あたりのヒープ割り当て回数です
HotXLS が Open を3フェーズに分割する仕組み
HotXLS はデフォルトで、複数シートの XLSX パッケージのワークシートをワーカースレッドでパースします。TXLSXWorkbook.ParallelParse の初期値は True、ParallelParseThreads の初期値は 0 です。0 は、OS が報告する論理プロセッサ1個につきワーカー1本という意味で、パースすべきシート数を超えるワーカーは立ち上げません。Open の3フェーズのうち、ワーカーで走るのは1つだけです。フェーズ A は直列です。ワークブックパート、共有文字列、スタイルを読み、名前と表示状態付きで全シートを作成し、各シートのリレーションシップファイルをパースして、ハイパーリンクとテーブルのターゲットを解決済みにします。ワーカーが動き出す頃には、参照する検索テーブルはすべて完成済みで、以後は読まれるだけです
フェーズ B は各ワークシートをワーカーへ渡します。ワーカーはインターロック付きインクリメントで共有カウンターからシートインデックスを取得するため、大きなシート1つに小さなシート7つというワークブックでも、スケジューラなしで自然に帳尻が合います。小さなシートを終えたワーカーは、単純に次のインデックスを取るだけです。素朴には共有できないのが ZIP コンテナ側です。deflate ストリームはブロックから次のブロックへ状態を引き継ぐため、2つのスレッドが同じデコンプレッサを進めることはできません。そこで各ワーカーは、自分のシートエントリ上に自分のデコンプレッサを開き、XML を自分のリーダーへ直接ストリームします。共有リソースはファイルハンドルだけで、その周りのロックが一度に覆うのは圧縮バイトの1回のシークアンドリードです。展開もパースも並列に走り、ワークシートの XML がメモリ上で完全にインフレートされたまま置かれることはありません。パースが終わると、ワーカーはエントリを最後まで読み切るので、ZIP のサイズと CRC 検査は通常どおり走ります
フェーズ C は、シートにぶら下がるパーツ、つまりコメントとスレッド式コメント、描画とチャート、テーブル、プリンタ設定を1本のスレッドに戻して処理します。ほとんどのワークブックでは、これらはセル XML に比べれば小さなものです
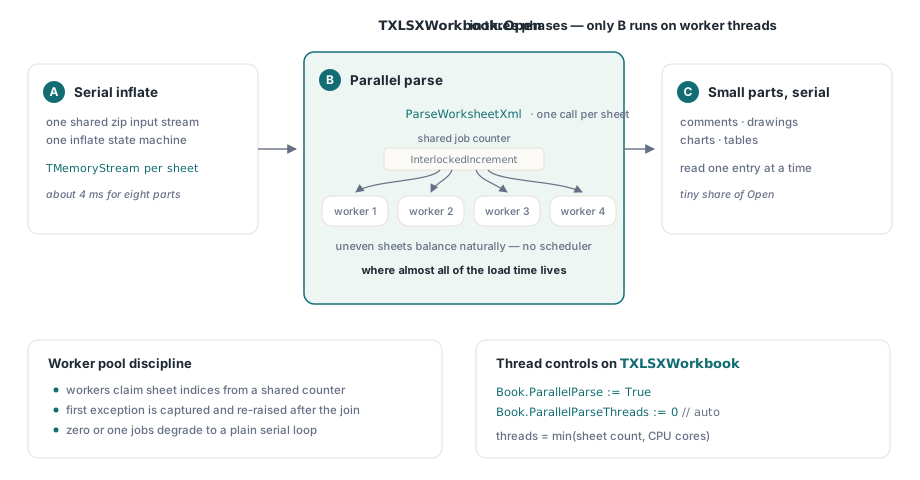
エラーは呼び出し側スレッドに返されます。パース中にシートが例外を上げると、プールは新しいインデックスの配布を止め、まだ動いているワーカーを待ち、それから失敗したシートのうち番号が最小のものの例外を Open から再スローします。報告がシート順に従い、呼び出し側がワーカースレッドを逃げた例外の処理に迫られることはありません。RecoveryMode を True にすると、パースに失敗したシートは代わりにスキップされ、警告が Diagnostics に記録され、残りのシートは普通にロードされます。ParallelParse を False にすると、同じパーサーがシートを1つずつ処理し、結果は同一になります
var
  Book: TXLSXWorkbook;
begin
  Book := TXLSXWorkbook.Create;
  try
    // どちらもデフォルト値。明示しておくと選択が
    // コードレビューで見えるままになる
    Book.ParallelParse := True;
    Book.ParallelParseThreads := 0;  // 0 = 論理 CPU ごとに 1 ワーカー、シート数で頭打ち
    Book.RecoveryMode := False;      // パースに失敗したシートは Open から例外を上げる
    if Book.Open('quarterly-ledger.xlsx') <> 1 then
      raise Exception.Create('open failed');
    // ここですべてのシートが完全にロード済み。通常どおりセルを読む
  finally
    Book.Free;
  end;
end;
スレッドを増やすと、割り当ての重いパーサーはなぜ遅くなるのか
ワークシートのパースは大半が小さな割り当てであり、Delphi のデフォルトのメモリマネージャはそこでスレッドに順番待ちさせます。素朴な XML リーダーは要素名ごとに文字列を1つ、属性名と属性値にそれぞれ1つ、セルに Variant を1つ、そのテキストに文字列を1つ作ります。デフォルトのメモリマネージャは小さなブロックをサイズ別にグループ化したプールに置き、各プールをロック1つで守ります。ロックが取られたと見たスレッドは退避してスリープし、それから再試行します。8本のワーカーが同じ小サイズばかりを要求すると、同じプールの前で衝突し続け、ソース上は独立に見えるスレッドが、結局は1本ずつ順番に走ることになります
冒頭の2つの症状はこれで説明が付きます。スリープ中のスレッドは CPU を燃やさないため CPU 時間は実時間に張り付き、ペースを決めるのはコアではなくプールのロックなので、スレッド数を動かす掃引はフラットなままです。スレッド2本が1本に完全敗北することもあります。割り当てのたびにロックをコア間で手渡すコストを払う一方、直列ループはそもそも競合しないからです
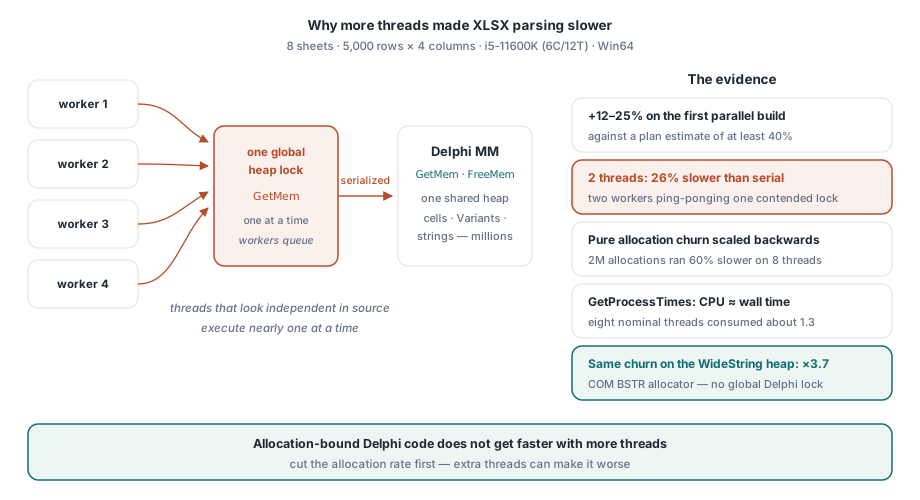
Windows では1つの文字列型だけがこの外側に置かれています。WideString は COM の BSTR であり、Delphi のメモリマネージャではなくシステムの OLE 文字列アロケータが確保するため、WideString のトラフィックは Delphi のプールに並びません。HotXLS はセルテキストを WideString で保持しています。これは直列パスの頃以上に、並列ロードで効いてくる選択です
自分のワークブックで競合を測る
ロードが割り当て律速かどうかは2つの数字で分かります。ワーカー数を上げたとき実時間がどう動くかと、同じ区間でプロセスがどれだけ CPU を消費したかです。実時間で割った CPU 時間が 1.0 近くに張り付いたまま8本のワーカーが名目上忙しければ、ワーカーはパースではなく整列待ちをしています。以下の掃引は、同じファイルを1から8本のワーカーで開き、両方の数値を表示します。自分のテストプロジェクトに足す計測ハーネスでして、TXLSXWorkbook のメンバーだけが HotXLS 由来です
uses
  Winapi.Windows, System.SysUtils, System.Math, System.Diagnostics;

// 自前のヘルパー: このプロセスの user + kernel CPU 時間(ミリ秒)
function ProcessCpuMs: Int64;
var
  Created, Exited, Kernel, User: TFileTime;
begin
  GetProcessTimes(GetCurrentProcess, Created, Exited, Kernel, User);
  Result := (Int64(Kernel) + Int64(User)) div 10000;  // 100 ns 刻みを ms へ
end;

procedure SweepThreads(const FileName: string);
var
  N: Integer;
  Book: TXLSXWorkbook;
  SW: TStopwatch;
  Cpu0, Cpu: Int64;
begin
  for N := 1 to 8 do
  begin
    Book := TXLSXWorkbook.Create;
    try
      Book.ParallelParseThreads := N;  // 1 は素の直列ループで走る
      Cpu0 := ProcessCpuMs;
      SW := TStopwatch.StartNew;
      if Book.Open(FileName) <> 1 then
        raise Exception.CreateFmt('open failed: %s', [FileName]);
      SW.Stop;
      Cpu := ProcessCpuMs - Cpu0;
      Writeln(Format('%d workers: %d ms wall, CPU/wall %.2f',
        [N, SW.ElapsedMilliseconds, Cpu / Max(Int64(1), SW.ElapsedMilliseconds)]));
    finally
      Book.Free;
    end;
  end;
end;
掃引は数回走らせ、ワーカー数ごとに最も良い数値を採用してください。最初の1回は冷えたディスクキャッシュのぶんも払っているからです。実時間の曲線がフラットで CPU/実時間が 1 近ければ、天井はメモリマネージャです。実時間が下がり続け、CPU/実時間がワーカー数に向かって登っていくなら、ファイルはパース律速で、追加ワーカーは存在価値を発揮しています
曲線がフラットなら、次の疑問は「どの割り当てが犯人か」です。サイズ別に呼び出しを数えるメモリマネージャのラッパーを使えば、プロファイラ無しで数分で答えが出ます。下のバージョンは GetMem だけを数え、FreeMem と ReallocMem は元のマネージャのままで、トラフィックの発生源を見るにはそれで足ります
// 自分のテストハーネスに足す診断コード。HotXLS の一部ではない
var
  OldMM, NewMM: TMemoryManagerEx;
  AllocCount, TinyCount: Int64;

function CountingGetMem(Size: NativeInt): Pointer;
begin
  AtomicIncrement(AllocCount);
  if Size <= 32 then
    AtomicIncrement(TinyCount);  // 監視に値する小ブロックのチャーン
  Result := OldMM.GetMem(Size);
end;

procedure InstallCounter;
begin
  GetMemoryManager(OldMM);
  NewMM := OldMM;
  NewMM.GetMem := CountingGetMem;
  SetMemoryManager(NewMM);
end;

procedure RemoveCounter;
begin
  SetMemoryManager(OldMM);
end;
カウンタは Open の直前に仕掛け、直後に外し、AllocCount をファイルのセル数で割ります。このセルあたりの数値をビルドからビルドへ追跡するのが筋で、32バイト以下のブロックの割合は短い文字列が支配的かどうかを示します。セルオブジェクトのプールを書く前に確認してください。セルオブジェクトは割り当て1回ですが、そのセルのパース中に生まれる短命の文字列は、それを何倍も上回りやすいのです
ワークシート XML のどこに割り当てが隠れるのか
<c r="B7" s="3" t="s"><v>42</v></c> のようなセルは、ディスク上ではごく小さく見えます。それでも素直なリーダーは、これを新鮮な文字列の連なりに変えます。要素名の c と v、3つの属性名、3つの属性値、そしてテキスト内容です。UTF-8 トークンを RTL で変換するたびに、最終的な WideString が生まれる前に中間の UnicodeString が1つ増えます。これらの文字列はセルより長く生きないのに、1つ1つがメモリマネージャへの小旅行です
HotXLS の XML リーダーは、この中で最大の2つの発生源を狙います。ワークシート XML の要素名はごく小さな語彙(row、c、v、f、is)から来るため、リーダーは出会った名前の短いキャッシュを保持し、新しい名前の素のバイトをそのキャッシュと比較して、一致すればキャッシュ済みの文字列を返します。キャッシュのコピーは意図的に AnsiString です。AnsiString は参照カウント方式なので、キャッシュ済みインスタンスを渡すコストはカウンタのインクリメント1回で、割り当ては一切ありません。WideString の名前キャッシュは何も買えません。WideString には参照カウントがなく、代入のたびに新しいシステム割り当てが発生するからです
属性名、属性値、セルテキストはもう一方のルートを行きます。リーダーは UTF-8 をスキャンバッファから直接2パスでデコードします。1パス目で UTF-16 コード単位数を数え、2パス目でちょうどその長さで1回だけ確保した WideString を埋めます。トークンあたり割り当て1回で、行き先は Delphi のプールではなくシステム文字列アロケータです。A のような文字参照と定義済みエンティティは、デコード開始前にスキャナが解決するため、デコーダが見るのは平の UTF-8 だけです。UTF-8 として妥当でないバイト列については、RTL 変換なら落としたり置き換えたりするところを、デコーダは問題のバイトを1つずつ素通しさせるため、壊れたファイルでも悪い箇所の周りは読める ASCII を返します。妥当な入力はどちらの道でも同じテキストにデコードされます
この2つの工夫は、自分の Delphi パースコードにも持ち込めます。文字列のキャッシュが割り当てを節約するのは文字列型が参照カウント方式のときだけですし、目的の型へ直接デコードすれば、便利な RTL 変換関数が呼び出しごとに作る一時オブジェクトが消えます
どのワークブックが得をして、どの設定を選ぶべきか
並列パースはワークシート粒度で働くため、成果の大半はワークブックの形で決まります。同程度のサイズのシートが数枚あるのが最良のケースで、地域や月ごとにテンプレートワークシートを複製して作ったファイルもここに含まれます。1枚の巨大シートだけのワークブックは、ParallelParseThreads が何と言おうと1本のワーカーでパースします。その形にはストリーミング型ダイレクトリーダーのほうが適しており、ワークブック全体をメモリに組みません。コメント、チャート、描画に費やす時間は直列のフェーズ C に残ります。パースすべきシートが0枚か1枚のファイルは、プールを飛ばして素の直列ループで走ります
一部のシートだけが重要なら、Open を呼ぶ前にその名前を SelectedSheets に並べます。残りのシートも名前と表示状態付きで作成はされますがセルは空で、ワーカーはそれらを素通りし、ユーザーが開いたときに LoadSheet が後から中身を満たします
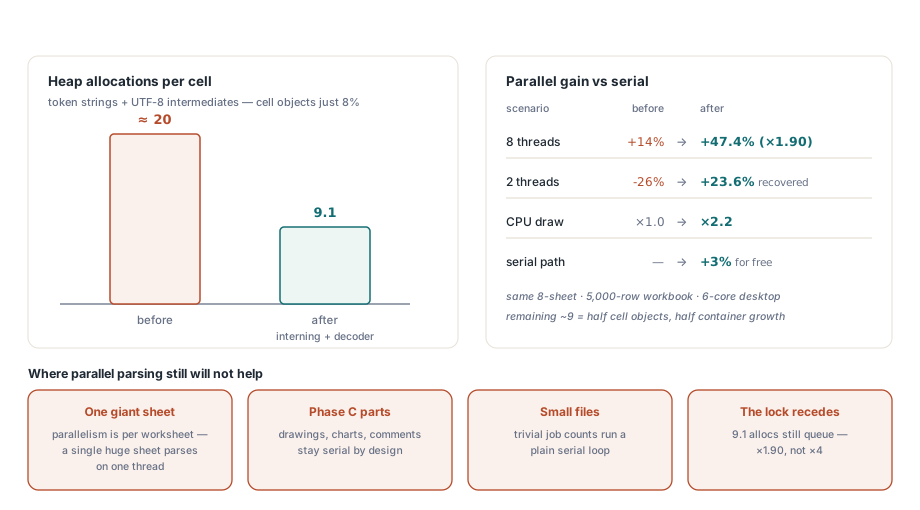
1度に1冊のワークブックを開くデスクトップツールやバッチジョブでは、ParallelParse を有効のままにしてください。デフォルトのこちらが安全側です。結果は直列パスと一致し、スレッドの疑問が持ち上がったらプロパティ1つで切れます。すでに複数のワークブックを同時に開くサーバーは別物です。リクエストスレッドもそれぞれ割り当てているため、パースワーカーを1本増やすたびに、同じメモリマネージャプールの取り合いが1人増えます。そこでは ParallelParseThreads を 2 に設定し、上の掃引をそのサーバーで通常負荷のまま走らせて、追加ワーカーが採算に合うと示せたときだけ上げてください。セルあたりの割り当てを減らすと、天井は取り除かれないまま高くなります。セルオブジェクトとコンテナの成長は今も Delphi のプールを通るので、8ワーカーでの向上が8倍から大きく下回る理由です。スタイルの再利用から一括行コールバックまで、ロードとセーブの残りの道具立てについては、Delphi での大規模ワークブックのパフォーマンスガイドを参照してください
ワーカープール、ParallelParse と ParallelParseThreads の各スイッチ、割り当ての瘦せた XML リーダーは、すべて HotXLS Delphi Excel Component に同梱されています。マシンに Excel をインストールせずに、Delphi と C++Builder のコードから XLS、XLSX、ODS を直接読み書きできるコンポーネントです