Excelでは="a-b">"ab"はTRUE、="a~b"<"ab"もTRUEです。同じ組をDelphiのCompareTextに渡すと、答えはどちらも逆になります。ハイフンはコードポイント順で英字より下、チルドは英字より上にいるからです。ExcelはテキストをWindowsユーザーロケールの大文字小文字を無視する「word sort」で比較します。ハイフンとアポストロフィは同点を崩すときしか効かず、それ以外の記号はすべて数字と英字の前に並びます
届く症状に「照合順序」という言葉はまず出てきません。サーバーで計算したCOUNTIF(A:A,">M")は、Excelで同じ式を評価したときより2行多く数える。帳票サービスが並べ替えた価格表では、X-100がExcelなら置かない位置に来る。列に明らかにabcがあるのにVLOOKUP("ABC",...)が#N/Aを返す。3つとも1つの疑問に帰着します。両オペランドがテキストのとき、どちらが小さいのか。Excelには正確な答えがあり、それはDelphiコードがデフォルトで返す答えとはたいてい食い違います
Excelは2つのテキスト文字列を比較するとき、どんなルールを使うのか
Excelは2つのテキスト値を、現在のWindowsユーザーロケールのword sortで大文字小文字を無視して比較します。word sortはWindowsのNLS比較関数がデフォルトで使う照合順序です。英字はコードポイント順ではなく言語学的な順で比較されるので、éはeとfの間に収まり、大文字小文字は折り畳まれます。特別扱いされるのは2文字です。ハイフン-とアポストロフィ'は最初のパスでスキップされるため、co-opはcoopのすぐ隣に来ます。残りの文字で同点になったときだけ、この2文字の有無と位置が順序を決めます。それ以外の記号はフルウェイトで数えられ、数字の前に並びます。数字は英字の前です
表は、ExcelがIF(A<B,...)に対して下す判定を、Delphi開発者が最初に書きがちな2つの比較と並べて示したものです
| A vs B | Excel / HotXLS | CompareStr(順序比較) | CompareText |
|---|---|---|---|
"a-b" vs "ab" | より大きい | より小さい | より小さい |
"a'b" vs "ab" | より大きい | より小さい | より小さい |
"a~b" vs "ab" | より小さい | より大きい | より大きい |
"a_b" vs "ab" | より小さい | より小さい | より大きい |
"ab" vs "AB" | 等しい | より大きい | 等しい |
"é" vs "f" | より小さい | より大きい | より大きい |
"Z" vs "f" | より大きい | より小さい | より大きい |
ここで人は2つの点でつまずきます。ハイフンは同点を崩すだけなので、="a-b"="ab"はFALSE。並べ替えると隣り合う2つの文字列なのに、等しくはありません。大文字小文字は完全に折り畳まれるので、ab、AB、Abはどの比較演算子にとっても1つのキーです。英語ユーザーロケールの下で20個の厄介な単語を並べ替えると、a b、a.b、a_b、a~b、a0、a1b、ab / AB / Ab、ab-、a'b、a-b、-ab、ab1、abc、b、e、é、f、Zの順になります。abグループの内部では、スキップされた文字の位置が順を決めます。末尾ハイフンがいちばん先、先頭ハイフンがいちばん後です
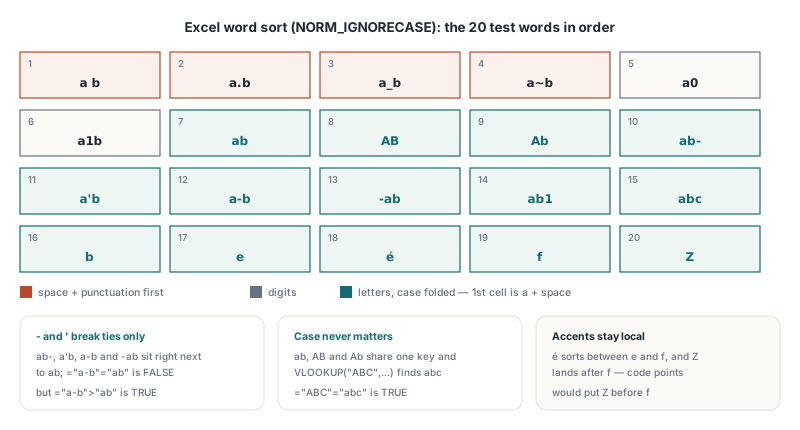
照合順序を自分でExcelに照らして確かめる
Excelのドキュメントは使っている照合順序を名指ししません。だから自分のマシンで確かめるいちばん確実な方法は、文字列ペアの判定をExcelに任せ、その判定をさまざまなフラグ組み合わせのCompareStringWと突き合わせることです。ペアを2列に置き、各行で=IF(A1<B1,-1,IF(A1=B1,0,1))をExcelに評価させ、同じペアをAPIに通します。生成する価値のあるペアは、ASCII記号、数字、大文字小文字両方、スペース、é、ß、äのようなアクセント付き文字、CJK文字、全角形、ノーブレークスペースを混ぜ、1文字だけ違う「あと一歩」のペアをたっぷり含めることです。辞書から引いた無難な単語はサンプルとして貧弱です。ここで扱うどのルールでも、普通の英字は同じ順になるからです
フラグの組み合わせによって結果は明確に分かれます:
LOCALE_USER_DEFAULT付きのNORM_IGNORECASEだけが素のword sortで、Excelが従うのはこれですSORT_STRINGSORTを加えるとstring sortに切り替わり、ハイフンとアポストロフィがフルウェイトの普通の記号に戻るので、a-b/ab型のペアはすべて逆の判定になりますNORM_IGNOREWIDTHを加えると全角英字と半角英字が等しく扱われます。Excelはこの2つを区別したままです
罠はテストハーネス自身にもあります。Excelはセルに入力された先頭のアポストロフィを「文字列として格納」プレフィックスとして扱うので、入力全体が'だけのセルは空になり、そのように作ったペアは照合順序とは無関係の不一致を報告します。そういうペアは式の中で文字列リテラル(="'")で作るか、諦めて外します
なぜCompareTextと順序比較は間違えるのか
CompareTextと順序比較がExcelの順序を見逃すのは、UTF-16コードユニットを比較しており、コードポイント順は記号をアルファベットの周りに散らばらせるからです。ハイフンはU+002D、アポストロフィはU+0027で、どちらもすべての英字より下です。だから順序比較は"a-b"を"ab"より小さいと判定しますが、Excelはハイフンをタイブレーカーとして扱います。チルドはU+007Eですべての英字より上にあり、"a~b"は大きいと判定されます。Excelの逆です。CompareTextはさらに独自の歪みを上乗せします。a..zだけを大文字に折り畳んでからコードユニットを比較しますが、アンダースコア(U+005F)は大文字範囲と小文字範囲の間にあるため、折り畳みによって"a_b"は"ab"より下から上へ移動します。どちらの関数も、éがeとfの間に属することは知りません
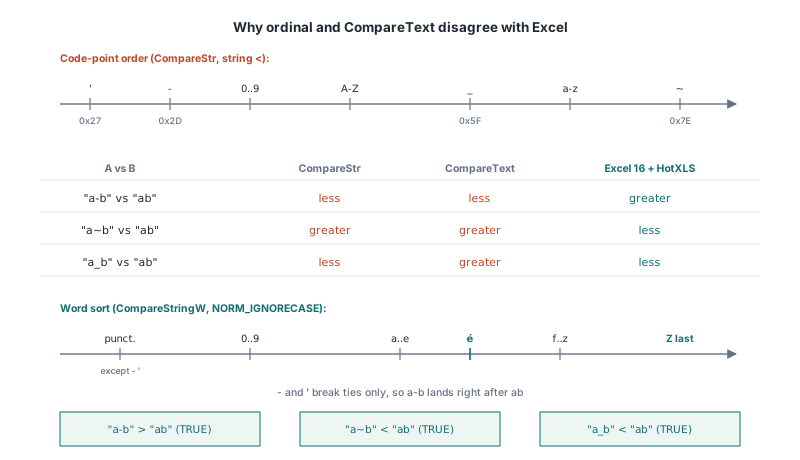
いつものDelphiの道具立ては、線の両側に散らばっています:
CompareStr、文字列の<演算子、TComparer<string>.Defaultは順序比較で大文字小文字を区別します。コンパレラなしのTArray.Sort<string>はZをfより先に置きますCompareTextとSameTextは、ASCIIのみの大文字小文字折り畳みのあとで順序比較します- WindowsのDelphi RTLにある
AnsiCompareTextとWideCompareTextはCompareString(LOCALE_USER_DEFAULT, NORM_IGNORECASE, ...)を呼びます。Excelと一致する呼び出しです。デフォルト設定(UseLocaleTrue、CaseSensitiveFalse)のソート済みTStringListもAnsiCompareTextを経由するので、やはりExcelと一致します - POSIXターゲットではDelphi RTLは
AnsiCompareTextをICUコレータに回します。記号の規則が異なる別アルゴリズムです。WindowsのFree PascalのAnsiCompareTextはANSIコードページへ変換してCompareStringAを呼ぶため、そのコードページで表現できない文字はすべて失われます
つまりロケール対応RTL関数がWindowsでたまたま正しいのは、今日の実装がそうなっているからです。Excelと一致しなければならないコードは、API呼び出しを明示的に書いて、そう意図したことを示すべきです。より厄介な問題は、各コードパスが手近な比較を掴む式エンジンならどこでも顔を出します。=や<の演算子では大文字化してコードポイント比較、COUNTIFクライテリアの> / <分岐では大文字小文字を区別するVariant比較、VLOOKUPの中ではまた別の比較(VLOOKUP("ABC",A1:A20,1,FALSE)がabcを見つけられないのはまさにこのためです)、範囲の並べ替えではロケール呼び出し。1つ1つは弁護できます。合わせると、同じ列の上に3つの異なる順序ができあがります
数式、ルックアップ、並べ替えの背後にある1つの比較
HotXLSは計算と並べ替えのコードにおけるテキスト対テキストの比較をすべて、lxStandard.pasの1つの関数XlsCompareTextに集約します。この関数はCompareStringW(LOCALE_USER_DEFAULT, NORM_IGNORECASE, ...)を呼んでCSTR_EQUALを引きます。6つの比較演算子がこれを使い、配列数式の要素ごとの比較、COUNTIF系クライテリアの>、<、>=、<=の各分岐とデータベース関数、完全一致と近似の両モードのVLOOKUPとHLOOKUP、動的配列関数とXLOOKUP / XMATCHの背後の順序付け、TXLSWorksheetとTXLSXWorksheet双方のSortRangeも同じです。範囲の並べ替えをこの関数に載せたのが決め手となった設計判断でした。テキストの近似VLOOKUPがまともな答えを返すのは、列がルックアップの比較順で並べ替えられているときだけです。1つの関数を共有すれば、2つの順序が乖離することは構造上あり得ません
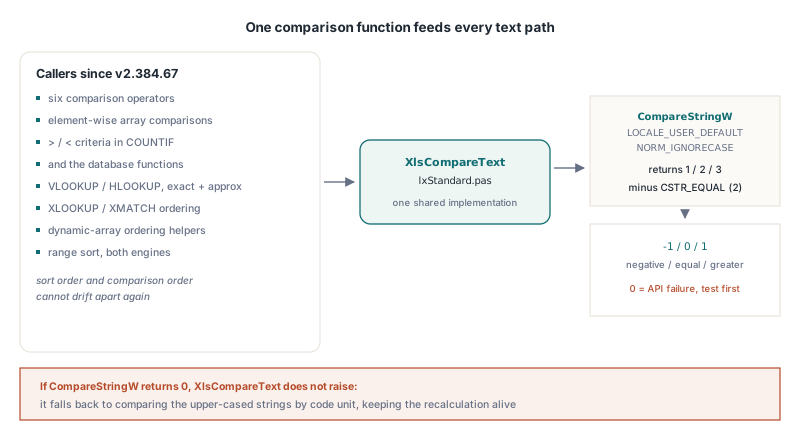
Delphiからこのルールをいちばん手っ取り早く確認するのはTXLSXWorkbook.Calculateです。数式文字列をアクティブシートに対して評価し、結果をVariantで返します
uses
  System.Variants, lxHandleX;

var
  Book: TXLSXWorkbook;
begin
  Book := TXLSXWorkbook.Create;
  try
    Book.Sheets.Add('Data');  // Calculateはアクティブシートに対して評価する
    Writeln(VarToStr(Book.Calculate('="a-b">"ab"')));   // True:ハイフンは同点だけ崩す
    Writeln(VarToStr(Book.Calculate('="a-b"="ab"')));   // False:同点は崩されるが等しくはない
    Writeln(VarToStr(Book.Calculate('="a~b"<"ab"')));   // True:記号が先
    Writeln(VarToStr(Book.Calculate('="ABC"="abc"')));  // True:大文字小文字は無視
  finally
    Book.Free;
  end;
end;
word sortが適用されるのは、両オペランドがテキストのときだけです。型が混在するときは固定の順位付けに従い、数値はすべてテキストより下、テキストはすべてブーリアンより下になります。詳細は比較チェーン、空オペランド、SUMIFを扱った記事で解説しています。"a*"や"=ab"のようなワイルドカードクライテリアは独自のルールを持つパターン照合と等値判定で、COUNTIF、MATCH、DSUMのExcelワイルドカードガイドで扱います。ここで扱う照合順序が決めるのは、順序を比較する演算子です
次の例は20個の単語をシートのA列に読み込み、3つのクライテリアのカウントと1つのルックアップを確認してから、TXLSXWorksheet.SortRangeでその列を並べ替えます。期待するカウントは先ほどの並びから直接導けます。abグループより後に並ぶのは11語、a-bより前に並ぶのも11語、>=ABはabグループの3語と11語を合わせた14です
const
  Words: array [0..19] of string = ('ab', 'a-b', 'a~b', 'a_b', 'AB', 'a b',
    'ab1', 'ab-', '-ab', 'abc', 'a''b', 'Ab', 'b', 'a.b', 'a1b', 'a0',
    #$00E9, 'e', 'f', 'Z');
var
  Book: TXLSXWorkbook;
  Sheet: TXLSXWorksheet;
  i: Integer;
begin
  Book := TXLSXWorkbook.Create;
  try
    Sheet := Book.Sheets.Add('Words');
    for i := 0 to High(Words) do
      Sheet.Cells[i + 1, 1].Value := WideString(Words[i]);

    // word sortの順から期待するカウント:11、11、14
    Writeln(VarToStr(Book.Calculate('=COUNTIF(A1:A20,">ab")')));
    Writeln(VarToStr(Book.Calculate('=COUNTIF(A1:A20,"<a-b")')));
    Writeln(VarToStr(Book.Calculate('=COUNTIF(A1:A20,">=AB")')));

    // abcが見つかる:ルックアップはExcelと同じく大文字小文字を無視して比較する
    Sheet.Cells[1, 3].Formula := '=VLOOKUP("ABC",A1:A20,1,FALSE)';
    Book.Recalculate;
    Writeln(VarToStr(Sheet.Cells[1, 3].Value));                // abc

    // キー1列、昇順:a b, a.b, a_b, a~b, a0, a1b, ab, AB, Ab, ...
    Sheet.SortRange(1, 1, 20, 1, [1], [False]);
    for i := 1 to 20 do
      Writeln(VarToStr(Sheet.Cells[i, 1].Value));
  finally
    Book.Free;
  end;
end;SortRangeは安定マージソートです。等しいと判定されるab、AB、Abは、並べ替え前の相対順を保ちます。空セルはキーが昇順でも降順でも最後に置かれます。Excelもそこに置きます
自分のDelphiコードでExcelの並べ替え順に合わせるには
ワークブックの外でExcelのテキスト順を再現するには、LOCALE_USER_DEFAULTとNORM_IGNORECASEでCompareStringWを呼び、SORT_STRINGSORTとNORM_IGNOREWIDTHは付けません。戻り値に注意してください。このAPIは符号付きの結果を返しません。CSTR_LESS_THAN(1)、CSTR_EQUAL(2)、CSTR_GREATER_THAN(3)を返し、呼び出しに失敗したときは0を返します。2を引けば慣習的な負 / ゼロ / 正の約束になりますが、それは0のケースを先に処理してからの話です。そうしないと失敗した呼び出しが-2になり、「より小さい」と読めてしまいます
uses
  Winapi.Windows, System.SysUtils, System.Generics.Defaults,
  System.Generics.Collections;

// Excelのテキスト順:ユーザーロケールのword sort、大文字小文字を無視
function ExcelCompareText(const A, B: string): Integer;
var
  R: Integer;
begin
  R := CompareStringW(LOCALE_USER_DEFAULT, NORM_IGNORECASE,
    PWideChar(A), Length(A), PWideChar(B), Length(B));
  if R = 0 then
    RaiseLastOSError;          // 0は失敗であって比較結果ではない
  Result := R - CSTR_EQUAL;    // 1/2/3が-1/0/1になる
end;

var
  Keys: TArray<string>;
begin
  Keys := ['abc', 'a-b', 'AB', 'a~b', '-ab', 'ab'];
  TArray.Sort<string>(Keys, TComparer<string>.Construct(
    function(const L, R: string): Integer
    begin
      Result := ExcelCompareText(L, R);
    end));
  // a~b, ab / AB(等しい。どちらの順でも), a-b, -ab, abc
end;uses節にHotXLSがすでにあるなら、lxStandard.XlsCompareTextは公開関数で、同じ順序を返します。2つの違いはAPI呼び出しの失敗時だけです。上の関数はraiseしますが、XlsCompareTextは大文字化した文字列をコードユニットで比較するフォールバックに落ち、再計算が途中で止まりません。スタンドアロンの並べ替えではraiseするほうが良い選択です。黙って間違った順序のほうが、例外より追跡が面倒だからです
TArray.Sortは安定ソートではありません。等しいキー(abとABなど)はどちらの順に出てもおかしくありません。等しいキーの元の順が重要なら、インデックス配列を並べ替えて、元の位置を第2キーに使います
列によっては、意図的にExcelの順序を無視したいことがあります。型番がその代表で、X-100とX100は別のコードなので、コードポイント順で並べるべきものです。SortRangeにはTXLSSortCompareEvent(function(const Left, Right: Variant): Integer of objectとして宣言)を受け取るオーバーロードがあり、組み込みの比較の代わりにそれを使います
uses
  System.SysUtils, System.Variants, lxStandard, lxHandleX;

type
  TPartNumberOrder = class
    function Compare(const Left, Right: Variant): Integer;
  end;

function TPartNumberOrder.Compare(const Left, Right: Variant): Integer;
begin
  // カスタム比較器にも空セル(Null)が渡る:配置は自分で決める
  if VarIsNull(Left) or VarIsNull(Right) then
    Exit(Ord(VarIsNull(Left)) - Ord(VarIsNull(Right)));
  Result := CompareStr(VarToStr(Left), VarToStr(Right));   // 順序比較、大文字小文字を区別
end;

var
  Sheet: TXLSXWorksheet;   // 埋まったシート。行2..501、列A..D
  Order: TPartNumberOrder;
begin
  // ...
  Order := TPartNumberOrder.Create;
  try
    // 列Aをキーに昇順
    Sheet.SortRange(2, 1, 501, 4, [1], [False], xlsSortByRows,
      xlsSortExcelLike, Order.Compare);
  finally
    Order.Free;
  end;
end;カスタム比較器を渡すと、SortRangeは生のキー値をそのまま渡し、空セルの配置は比較器に任せます。だから上の比較器は最初にNullを処理します。降順キーでは、比較器が返した値をソート側が反転するので、比較器が対処しない限り空セルは先頭へ動きます。こうして並べた列は、近似VLOOKUPやバイナリサーチのXLOOKUPが期待する順ではなくなります。別の順に並んだデータでそれらのモードで何が起きるかは、XLOOKUPとXMATCHのバイナリサーチモードのガイドで扱っています
同じワークブックが別のマシンで違う並びになるのはなぜか
同じワークブックが別のマシンで違う並びになることがあるのは、Excelのテキスト順がWindowsユーザーロケールに依存し、HotXLSがその依存を意図的に踏襲しているからです。word sortは言語ごとに変わります。たとえばスウェーデン語の照合順序はäをzの後に置きますが、英語とドイツ語はaのそばに置きます。ストックホルムの同僚が再計算したファイルは、シカゴのデスクトップにある同じファイルとCOUNTIF(...,">y")の結果が違いうるのです。HotXLSはLOCALE_USER_DEFAULTを渡します。同じマシン上でExcelと同じ答えにするためです。固定ロケールをピン留めするほうが整然と見えますが、そうすると設定の違うすべてのマシンでHotXLSがExcelと食い違います
サーバーサイド生成では、ここから実務上の帰結が3つ出てきます:
- 効いてくるロケールは、プロセスが実行されるアカウントのものです。WindowsサービスやIISアプリケーションプールは、開発者のデスクトップと地域設定が違うことがあります。IDEで見た結果がそのまま本番の計算結果だとは限りません
- ファイルに書き込まれるキャッシュ済み数式結果は、生成マシンのロケールを反映します。Excelは自分のロケールで再計算するので、ファイルを別の場所で開いて再計算すると値が変わることがあります。Excel自身のファイルでも同じことが起きます
- ロケールが食い違うのは、たいていアクセント付き文字、一部の言語で1文字として扱われる文字の組み合わせ、非ラテン文字体系です。普通の英語単語だけのテストデータでは違いは永遠に顕在化しません。サンプルに
ÅngströmやÖbergのような名前をいくつか入れておきます
Excelと一致するパスはWindowsのものです。Delphi、C++Builder、LazarusとFree Pascalのどれでコンパイルしても、Win32とWin64の全ビルドが同じCompareStringWを呼びます。ビルドターゲットが非Windowsプラットフォームのとき、XlsCompareTextはRTLのWideCompareTextを使い、その順序はそのプラットフォーム自身の照合ライブラリから来ます
ありふれた単語はどのルールでも同じ順になるので、間違った照合順序はテストをすり抜け、ハイフン入りの型番や記号、アクセント付きの顧客名が現れて初めて顔を出しがちです。HotXLSはそういう入力に対して、比較演算子からSortRangeまで、XLSとXLSX両エンジンでExcelの答えを返します。対応するDelphiとC++Builderのバージョン、ライセンス、トライアルダウンロードはHotXLS Delphi Excel componentページに一覧があります