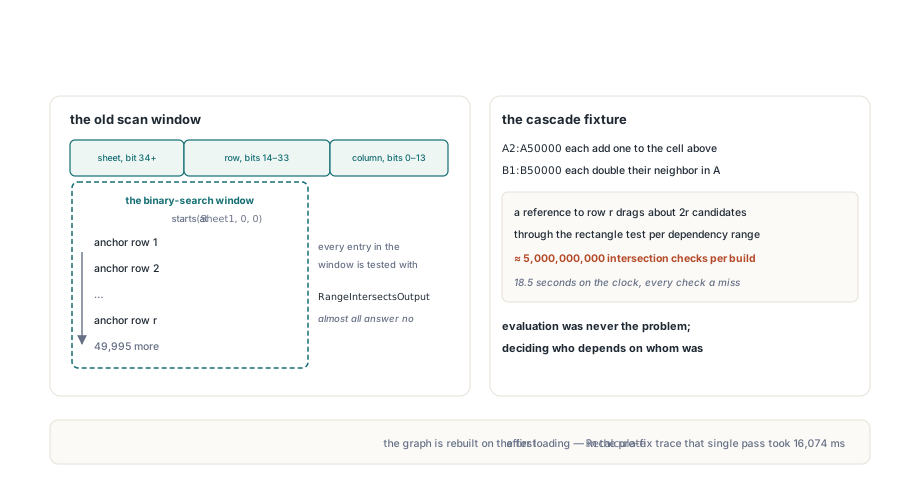
列 A に5万個の数式が並び、それぞれが上のセルに1を足す。列 B にもう5万個が並び、それぞれが隣のセルを2倍する。これほど素直なスプレッドシートモデルはありません。評価そのものは10万回の加算と乗算で済みます。ところが評価順序の決定は、エッジビルダーが素直に書かれていると桁違いに掛かります。参照シートの先頭から参照行まで全数式をなぞり、1つ1つ重なりをテストし、ヒットを集めるのです。この1枚のシートだけで矩形テストはおよそ50億回に達し、そのほとんどすべてが「ノー」で終わります
50億という数はストップウォッチの読みではなく計算です。行 r への参照は、その上の各行について列ごとに1つ、およそ 2r 個の候補を探索ウィンドウへ引きずり込みます。10万の参照について合計すれば数十億に届きます。面白いのは、このウィンドウが本当にシートの先頭から始まる必要があるという点です。手抜きとは何の関係もない理由で
依存グラフの再構築はどこに時間を使うのか
HotXLS の再計算エンジンは、数式のトポロジが変わるたびに数式依存グラフを作り直します。ワークブックのロードや生成の後の最初の Recalculate、数式の書き換え、シートの追加や削除、セルブロックの複製の後の最初の1回です。両方のワークブッククラス、TXLSWorkbook と TXLSXWorkbook は、このためにユニット lxDepGraph の TXLSDepGraph を組みます。数式セル1つが1つのノードになり、アンカー(Row、Col)と、(OutRow2、OutCol2)まで続く出力矩形を持ちます。普通の数式なら、矩形はアンカーセルそのものです
ノードは XLSDepMakeKey が詰め込んだ64ビットキーで順序付けられます。列がビット0–13、行がビット14–33、シートインデックスがビット34以降です。このキーでソートするとシート優先・行優先の順になるため、参照に関係しうる最後の数式を探すのは(Sheet2、Row2、16383)への二分探索1回で済みます。問題は最初の1件のほうです。下限は(Sheet1、0、0)、つまり参照シートの本当に一番上でなければならず、2つの境界の間にあるすべてが候補になります
探索は参照行から始められないのか
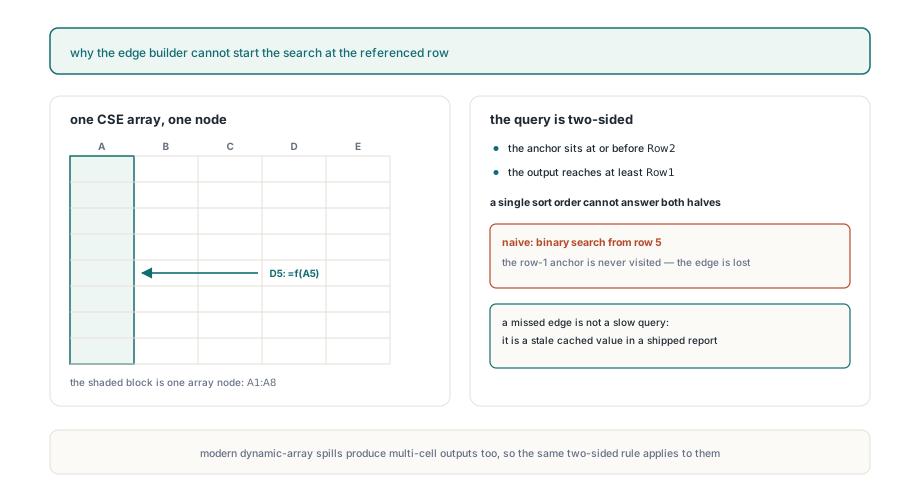
範囲の上にアンカーされた配列数式は、その内部のセルを所有できます。TXLSXWorkbook では、A1:A8 に入力された CSE 配列は1つのノードで、アンカーは A1、出力は行8まで届きます。増分再計算と依存グラフの記事のとおりです。A5 だけを読む D5 の数式にも、そのノードからのエッジが必要です。二分探索を行5から始めると、行1のアンカーは一度も訪問されず、エッジは記録されず、D5 は依存先の配列より先に評価されえます。症状は保存されたワークブックに残る古いキャッシュ値で、遅い再計算よりずっと気付きにくいものです
つまり本当の問い合わせは両側あります。ノードが候補になるのは、アンカーが Row2 以下にあり、出力が Row1 以上に届き、参照の中にあるシートで、列が重なるときです。アンカーによるソートは前者半分に答えます。アンカー順は後者半分について何も語りません。行3の数式が1セルを出力することも、1,000行を出力することもあるからです。what-if データテーブルも同じ形です。TXLSXWorkbook は各データテーブルを、結果領域全体を覆う1つのノードとして登録します。動的配列数式は別の道を行き、volatile の印が付くため毎パス再計算されます。スピル範囲の振る舞いは動的配列スピル数式の記事が扱います
TXLSDepGraph は公開クラスなので、このケースはワークブックなしで簡単に再現できます。シートインデックスは1始まり、行と列は0始まりで、計算器の座標系と一致します。下のプローブは配列ルートとリーダーを登録してエッジを構築し、さらに同じグラフ型で逆向きの点参照チェーンを走らせて、次のセクションが頼りにするカウンタを見せます
uses
  System.SysUtils, lxDepGraph;

function PointRef(ASheet, ARow, ACol: Integer): TXLSDepRange;
begin
  Result.Sheet1 := ASheet;
  Result.Sheet2 := ASheet;
  Result.Row1 := ARow;
  Result.Row2 := ARow;
  Result.Col1 := ACol;
  Result.Col2 := ACol;
  Result.LookupScan := False;
end;

procedure ProbeOutputIndex;
const
  N = 100000;
var
  G: TXLSDepGraph;
  Deps: TXLSDepRangeList;
  Reader, Row: Integer;
begin
  Deps := TXLSDepRangeList.Create;
  G := TXLSDepGraph.Create;
  try
    // CSE 配列: アンカー A1(行 0、列 0)、出力は A8(行 7)まで
    G.AddNode(1, 0, 0, 7, 0, False, nil);
    // D5(行 4、列 3)は A5 だけを読む
    Deps.Add(PointRef(1, 4, 0));
    Reader := G.AddNode(1, 4, 3, 4, 3, False, Deps);
    G.BuildEdges;
    Writeln('D5 precedents: ', G.Nodes[Reader].PrecedentCount);  // 1、A1 のルート
    Writeln('rectangles tested: ', G.EdgeCandidateChecks);       // 2: A1 のルートと D5 自身
  finally
    G.Free;
  end;

  // A1..A100000 のチェーン。各セルは上のセルを読む。下から上へ追加
  G := TXLSDepGraph.Create;
  try
    for Row := N - 1 downto 0 do
    begin
      Deps.Clear;
      if Row > 0 then
        Deps.Add(PointRef(1, Row - 1, 0));
      G.AddNode(1, Row, 0, Row, 0, False, Deps);
    end;
    G.BuildEdges;
    Writeln('chain checks: ', G.EdgeCandidateChecks);  // N - 1 = 99999
  finally
    G.Free;
    Deps.Free;
  end;
end;
最大出力行による部分木の枝刈り
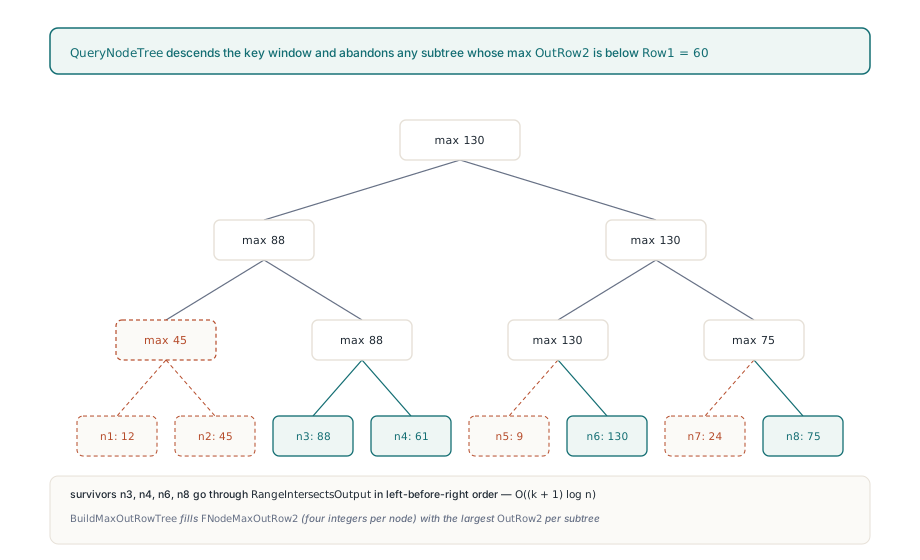
TXLSDepGraph.BuildEdges は上限のためにアンカーソートを保ち、下限には、ソート順に敷いた max 拡張セグメントツリーで答えます。ツリーの各エントリは、その下にある全ノードの OutRow2 の最大値を保持します。問い合わせはキーウィンドウの内部だけを降り、保持している最大値が Row1 より上の行にとどまる部分木は捨てます。その部分木のどの数式も参照行に届かないからです。生き残ったノードはそれでも完全な矩形テストを受けます。シート範囲と列のチェックは以前とまったく同じです
この技法は全部を見せられる大きさです。下のスケッチはこの記事のために書いた最小版で、独自の名前を付けてあります。どれも HotXLS の API ではなく、配列の中身は読者自身が、アンカーキーでソート済みの出力行のリストから埋めます
uses
  System.Math, System.Generics.Collections;

// スケッチ専用: アンカーキー順にソートされたノード上の max 拡張セグメントツリー。
// OutRow2[i] はソート順で i 番目のノードの最後の出力行。
type
  TOutputIndex = record
    OutRow2: TArray<Integer>;
    MaxRow: TArray<Integer>;   // SetLength(MaxRow, 4 * Length(OutRow2))
  end;

procedure BuildMax(var Ix: TOutputIndex; Node, L, R: Integer);
var
  M: Integer;
begin
  if L = R then
  begin
    Ix.MaxRow[Node] := Ix.OutRow2[L];
    Exit;
  end;
  M := (L + R) shr 1;
  BuildMax(Ix, Node * 2, L, M);
  BuildMax(Ix, Node * 2 + 1, M + 1, R);
  Ix.MaxRow[Node] := Max(Ix.MaxRow[Node * 2], Ix.MaxRow[Node * 2 + 1]);
end;

// [Lo, Hi) の中で出力が Row1 に届くノードを、左から右へ集める
procedure Query(const Ix: TOutputIndex; Node, L, R, Lo, Hi, Row1: Integer;
  Hits: TList<Integer>);
var
  M: Integer;
begin
  if (R < Lo) or (L >= Hi) or (Ix.MaxRow[Node] < Row1) then
    Exit;                        // ウィンドウの外、または Row1 に届くものがない
  if L = R then
  begin
    Hits.Add(L);                 // 完全な矩形テストは呼び出し側が改めて走らせる
    Exit;
  end;
  M := (L + R) shr 1;
  Query(Ix, Node * 2, L, M, Lo, Hi, Row1, Hits);           // 先に左
  Query(Ix, Node * 2 + 1, M + 1, R, Lo, Hi, Row1, Hits);   // 走査順を維持
end;

// BuildMax(Ix, 1, 0, Count - 1) で一度構築し、
// 参照ごとに Query(Ix, 1, 0, Count - 1, Lo, Hi, Row1, Hits) を呼ぶ
参照1つあたりの作業は、ウィンドウのサイズから O((k + 1) log n) まで落ちます。k は出力が実際に参照行へ届くノード数です。冒頭のモデルに戻ると、Br から Ar への参照は今や2つの矩形、Ar と Br 自身をテストし、Ar から上のセルへの参照はその行の2ノードをテストします。手計算でも、全構築は50億の代わりに約20万回のテストです
同じエッジを、同じ順序で
左を先にする再帰は、見た目以上に重要です。生き残ったノードは、ウィンドウを素直にループしたときとまったく同じ順序で訪問されるため、各ノードの Dependents と Precedents 配列は同じシーケンスで満たされ、そこから組み立てるトポロジカル順序は毎回同じに出ます。この順序は内部の帳簿だけの話ではありません。グラフが最新のとき、XLSX ライターは FullTopoOrder が返す順序で xl/calcChain.xml を書き出します。非決定的な訪問順序は、無変更のワークブックの2回の保存の間に、うるさい diff として表面化するでしょう
エッジ種別の規則も保たれます。VLOOKUP、MATCH、XLOOKUP などの関数のルックアップ配列引数に置かれた参照は、ルックアップスキャンエッジを生みます。汚れは伝播させますが、循環検出には関与しません。ノードが同じ先行に対してハード参照とルックアップ参照の双方を持つとき、先に記録されたハードエッジは後から来るスキャンエッジを抑制し、先に記録されたスキャンエッジはスロットを保ったまま、ハードエッジは改めて追加されます。この順序制約こそが、ルックアップ範囲が偽の循環参照を生まないための仕組みで、枝刈りされた走査が走査順に候補を訪問するときにのみ成立します
EdgeCandidateChecks プロパティのおかげで、枝刈りは観測可能です。直近の BuildEdges 呼び出しが実際にテストした出力矩形を数え、構築のたびに冒頭でリセットします。上のプローブでは、逆向きチェーンはノードを下から上へ追加し、ソートが全ノードを並べ替えたにもかかわらず、参照1回につき1テストの 99,999 を報告します。AddNode はソートとエッジの双方に古い印を付けるため、次の BuildEdges や NodeIndexOf はインデックスを継ぎ足さずに作り直します
残ったコストの在り処
ツリーが枝刈りするのは行だけです。この選択が、大きなモデルがそれでも払うものを形作ります
- 列のミスは葉で支払う:
A100:Z200を埋める2,626個の数式はすべて行100に届くため、AA100:AA200への参照は列で拒否する前に各数式をテストする - 列全体などの広い参照は、実際に多くの先行を持ちます。インデックスが取り除くのは無駄なテストであって、本物のエッジの構築コストは個数に比例したままです
- 複数シートにまたがる参照は、最初のシート全体を覆うウィンドウを開くため、そこで深い出力を持つ数式は葉のテストまで届きます。エッジの結果は同じで、弱くなるのは枝刈りだけです
- ツリーはノードあたり整数4つ、10万数式で約1.6 MB を取り、トポロジが変わると、次のエッジ構築で完全な O(n log n) の再ソートと O(n) のツリー構築を支払います
インデックスを張る1次元としては行が適切です。生成されるレポート、帳簿、財務モデルは下向きに育つため、無駄な候補のほぼすべては行距離から来ます。一方、列のミスは矩形テストが数回の整数比較で拒絶します。2次元目をツリーに足すと、すでに安価なテストを節約するために、すべての問い合わせが複雑になります
呼び出し側で高くつくのは再構築であり、値の編集はそれを誘発しません。Recalculate は最初の呼び出しでグラフを構築し、以降の呼び出しは、変更された値の下流にある数式と volatile のものだけを再評価します。狙うべきパターンは、全数式を先に書いて再計算は1回にすることです。下のハーネスはクラシックエンジンで両種のパスを計測します。クラシックエンジンの Recalculate は評価できなかった数式セルの数を返します。絶対時間はマシンに強く依存するため、バッチジョブを載せる予定のハードウェアで走らせてください
uses
  System.SysUtils, System.Diagnostics, lxHandle;

procedure TimeCascadeRecalc;
var
  Wb: TXLSWorkbook;
  Sh: TXLSWorksheet;
  I, Failed: Integer;
  Watch: TStopwatch;
begin
  Wb := TXLSWorkbook.Create;
  try
    Sh := Wb.Sheets.Add;
    Sh.Cells[1, 1].Value := 1;
    for I := 2 to 50000 do                     // 列 A の 49,999 リンク鎖
      Sh.Cells[I, 1].Formula := '=A' + IntToStr(I - 1) + '+1';
    for I := 1 to 50000 do                     // 列 B の 50,000 の依存先
      Sh.Cells[I, 2].Formula := '=A' + IntToStr(I) + '*2';

    Watch := TStopwatch.StartNew;
    Failed := Wb.Recalculate;                  // グラフを構築し、全部を評価
    Writeln(Format('first pass: %d not evaluated, %.1f ms',
      [Failed, Watch.Elapsed.TotalMilliseconds]));

    Sh.Cells[1, 1].Value := 10;                // 値の編集: グラフは再利用
    Watch := TStopwatch.StartNew;
    Failed := Wb.Recalculate;                  // 汚れたサブグラフだけ
    Writeln(Format('value pass: %d not evaluated, %.1f ms',
      [Failed, Watch.Elapsed.TotalMilliseconds]));
  finally
    Wb.Free;
  end;
end;
このモデルでは、列 A 全体が A1 にぶら下がっているため、値パスも全99,999数式を再評価します。スキップするのはグラフの構築のほうです。数式セルを平の値で上書きするのは別問題です。トポロジが変わるため、次の Recalculate はグラフをゼロから作り直します
複製された定義名にもあった同じ2次の形
レポートバンドは、同じパターンを別の場所に隠しています。TXLSXWorksheet.CloneRangeTo は、複製ブロック内の範囲を直接指す定義名をコピーします。コピー1つ1つが、そのスコープで一意な名前を必要とし、Total_2、Total_3 と続きます。コピーのたびに _2 から探索をやり直す方式では、毎回もう1人分の候補を調べることになり、何百もの複製バンドから組まれたシートは、名付けだけで2次回数の名前検索を払います
TXLSXDefinedNames は、名前インデックスに保持したサフィックスヒント、ベース名とスコープごとに1つで、これを回避します。次の探索は最後に返したサフィックスから始め、まずそれを再チェックします。呼び出し側はその名前を追加しない選択もできるからです。名前の削除、Name での改名、SheetIndex での移動、コレクションのクリアは、インデックスを全ヒントごと落とします。次の複製は最初の空きサフィックスに戻り、この変更が開けた穴を埋めていきます
大きなスプレッドシートを生成または再計算する Delphi と C++Builder のアプリケーションにとって、Delphi と C++Builder 向け HotXLS Excel コンポーネントは、このインデックス化された依存グラフを、クラシックと XLSX の両ワークブッククラスの再計算エンジンで使っています