HotXLSはBIFF8 XLUnicodeStringを、まずcchとfHigh flagを読み、encodingに合うreaderを選んでdecodeします。fHighが1ならbyte count cch * 2でTXLSBlob.GetWideStringを使い、fHighが0ならTXLSBlob.GetStringを使います。逆の組み合わせにするとrecordはemptyまたはhalf-length stringを返しますが、exceptionは決して発生しません
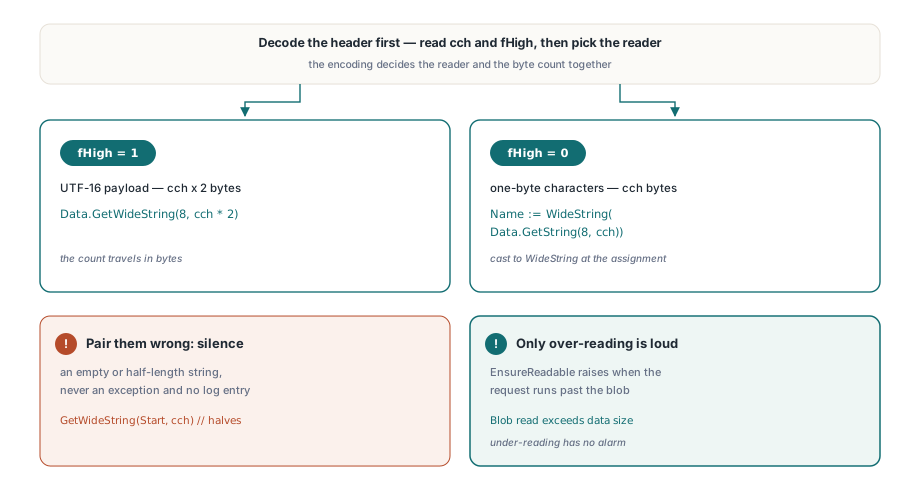
この種類のbugが高くつくのはそのためです。chartは開き、seriesは正しくdrawされ、axisも正しいのに、trendline captionの1つだけが空白になります。logにもexception handlerにも何もなく、corrupt-file dialogも出ません。fileは最初から正常でした。readerが間違ったbyte数を求め、要求した通りのものを受け取っただけです
BIFF8 stringがemptyで返る理由
BIFF8 stringがemptyで返る理由は、readが行われる前にlength guardがpayloadをrejectしたか、readerが最初に見つけたNULで停止したかのどちらかです。どちらのpathも構造上silentです。HotXLSではguardはrecord handler内の明示的なDataLength checkであることが多く、encodingごとに計算しなければなりません。16-bit payloadのSXViewLink bodyには8 + cch * 2 byteが必要ですが、8-bit payloadには8 + cch byteだけが必要です。wide-character arithmeticを8-bit recordに適用すると、短いnameはすべてgateに失敗します。2つ目のtrapはNULの動作です。TXLSBlob.GetStringとTXLSBlob.GetWideStringはどちらもdecode resultをterminatorまでscanして、そこでtruncateします。terminatorがposition 1にあればempty stringです。16-bit bodyを半分のbyte countで読むと最初のcch div 2 characterだけが残り、8-bit bodyをwide readerで読むとbyte pairが任意のcode pointになります。over-long readだけは明るみに出ます。requestがblobを越えるとTXLSBlob.EnsureReadableがBlob read exceeds data sizeをraiseします。under-readにはそのようなalarmがありません
GetWideStringが数えるのはcharacterではなくbyte
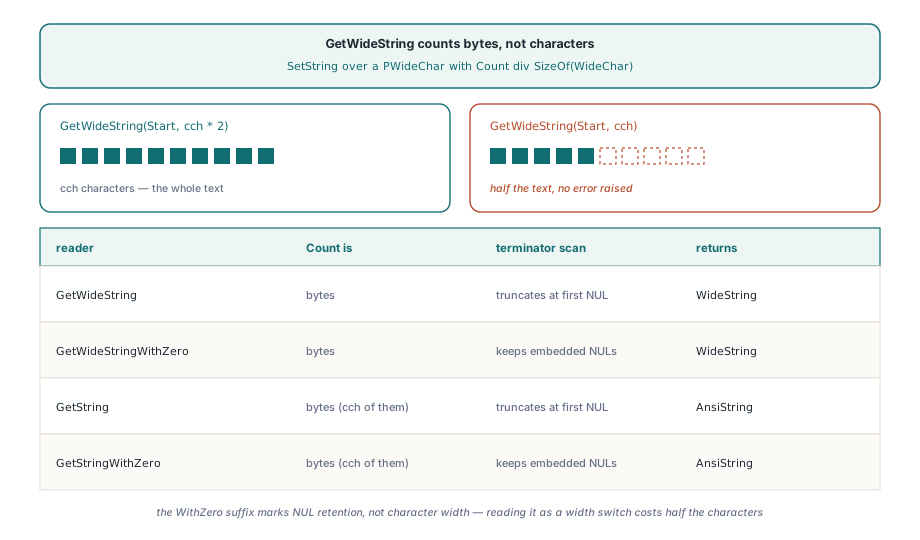
TXLSBlob.GetWideString(Index, Count)のCountはbyteで指定します。内部ではPWideCharに対するSetStringをCount div SizeOf(WideChar)で行うため、character countを渡すとstringは静かに半分になります。一方、BIFF8 record layoutはstring lengthをcharacterで表します。したがってすべての16-bit call siteは自分で* 2 conversionを持ち、8-bit call siteはそれを持ってはいけません。これはreadではなくtextをwriteするときにも現れるencoding boundaryです。stringを両方向へ動かすpipelineなら、DelphiでUnicode-safeなspreadsheet exportと合わせて読む価値があります
// 16-bit XLUnicodeStringNoCch:cch character、cch * 2 byte
Name := Data.GetWideString(Start, cch * 2);        // correct
Name := Data.GetWideString(Start, cch);            // textは半分になるがerrorなし

// 8-bit XLUnicodeStringNoCch:cch character、cch byte
Name := WideString(Data.GetString(Start, cch));    // correct
Name := Data.GetWideStringWithZero(Start, cch);    // wide readerのまま
このconventionは、byte streamを手でwalkする場所すべてで成り立ちます。HotXLSがlong String record($0207、[MS-XLS] 2.4.268)をContinue record($003C)から再構成するとき、wide branchはsegment lengthからsegChを計算し、その後GetWideString(3, segCh * 2)を呼びます。record bodyの開始offsetが3で、countは今もbyteだからです。rich-text readerも最初のContinue segmentのoffset 1から同じことをします。[MS-XLS] 2.5.293はfHighByteが1のときbreakがdouble-byte character boundaryに置かれることを保証するため、partial-character bookkeepingは不要です。それでもbyte arithmeticを正しく行う責任は残ります
GetWideStringWithZeroが実際に行うこと
TXLSBlob.GetWideStringWithZeroはembedded NULを保持するwide-character readerです。WithZero suffixが示すのはNUL retentionであり、character widthではありません。内部ではGetWideStringと同じく、Count div SizeOf(WideChar)を使ってPWideCharにSetStringを行いますが、terminator scanだけを省きます。one-byte counterpartはTXLSBlob.GetStringWithZeroで、AnsiStringを返します。nameだけではどちらか分からず、その曖昧さがこのcodebaseに現実のbugを生みました。具体的な誤読を名前に出す価値があります。「GetWideStringはcch * 2が必要だから、GetWideStringWithZeroはcchをそのまま受け取るほうだろう」というものです。実際、文句を言わずcchを受け取り、WideStringを返し、compilerも喜びます。しかし返るのはcharacterが半分になったstringで、間違ったbyte pairから組み立てられています。正しい8-bit pathはplain cch byte countのTXLSBlob.GetStringを使い、assignment時にWideStringへcastする方法です。HotXLS 2.376.0では、2つのchart decoderでまさにこの誤用が修正されました
SXViewLinkとencodingごとのlength gate
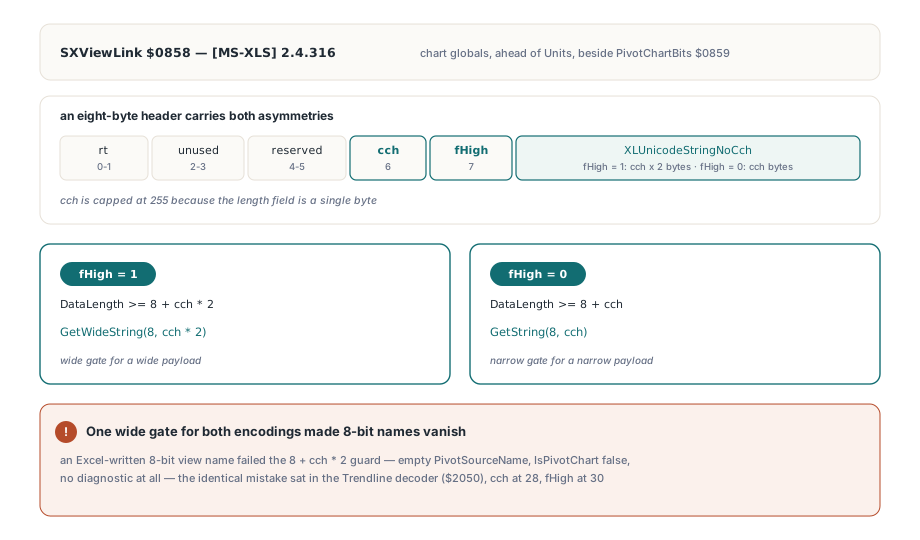
SXViewLink($0858、[MS-XLS] 2.4.316)は、両方のasymmetryを8-byte headerに詰めるため、最も分かりやすいworked exampleです。layoutはrt(2)、unused(2)、reserved(2)、cch(1)、fHigh(1)、続いてXLUnicodeStringNoCch bodyです。fHigh = 1はcch * 2 byteのUTF-16、fHigh = 0はcch byteのone-byte characterを意味し、length fieldがsingle byteなのでcchは255でcapされます。chart sheetがPivotTable viewへlinkするとき、HotXLSはUnitsの前、chart globalsへこのrecordを書きます。PivotChartBits($0859、[MS-XLS] 2.4.196)の隣です。この仕組みをrecord levelで見る説明はDelphiでBIFF8 PivotTable recordを書き出す方法にあります
// SXViewLink([MS-XLS] 2.4.316):rt(2) unused(2) reserved(2) cch(1)
// 続いてXLUnicodeStringNoCch - fHigh(1)とcharacter
PivCch := Item.FData.GetByte(6);
if (PivCch > 0) and (Item.FData.GetByte(7) <> 0) and
   (Item.FData.DataLength >= LongWord(8 + PivCch * 2)) then
begin
  Result.PivotSourceName := Item.FData.GetWideString(8, PivCch * 2);
  Result.IsPivotChart := True;
end
else if (PivCch > 0) and (Item.FData.GetByte(7) = 0) and
   (Item.FData.DataLength >= LongWord(8 + PivCch)) then
begin
  Result.PivotSourceName := WideString(Item.FData.GetString(8, PivCch));
  Result.IsPivotChart := True;
end;
2つのbranchは見た目だけの違いではありません。以前のversionでは両encodingをwide-character expression 8 + cch * 2の下でgateしていたため、Excelが書いた8-bit view nameはguardに失敗し、decoderはemptyのPivotSourceNameを返し、IsPivotChartはfalseのままでした。pivot linkはdiagnosticなしにmodelから消えました。同じmistakeはTrendline decoder($2050、[MS-XLS] 2.4.328)にもありました。name fieldはnumeric payload 28 byteの後、offset 28の2-byte cch、offset 30のfHigh、offset 31のcharacterに続きます。Excelが8-bit characterで書いたtrendline captionはempty stringへdecodeされました。両方とも同じreleaseで修正されています。8-bit caseはExcel 2.0から4.0 fileだけに閉じたlegacy curiosityでもありません。すべてのcharacterが1 byteに収まる場合、現在のExcelもなお8-bit BIFF8 payloadを書きます
Delphiで新しいBIFF8 recordを安全にdecodeする方法
fieldがstandard XLUnicodeStringなら、branchを手作りせずTXLSBlob.GetBiffStringを使ってください。これはlength fieldを読み、option byteを読み、合うreaderへdispatchし、bodyの後ろへcursorを進めます。2つのBoolean parameterは注意して読む部分です。is8bitはcharacterのwidthではなくlength fieldのwidthを表し、iswideはfHigh option byteがそもそも存在するかを示します。$0600未満のBIFF versionにはどちらもありません
var
  Offset: LongWord;
begin
  Offset := 6;  // SXViewLinkではここからcch byteが始まる
  // is8bit = length fieldが1 byte幅
  // iswide = length fieldの後にfHigh option byteが続く
  Name := Data.GetBiffString(Offset, True, True);
  // Offsetはstring bodyの直後の最初のbyteを指す
hand-rolled branchにも、truncatedまたはhostile inputに耐える必要があるときは役割があります。GetBiffStringは自分で制御するbounds checkではなく、EnsureReadableがraiseすることに依存するためです。そのためHotXLS chart decoderはDataLengthでgateし、throwするのではなく何も返しません。malformed third-party workbookの被害をdocument全体ではなくcaption 1つにとどめるためです。このtrade-offは意図的で、encoding-specific guardが正しくなければならない理由でもあります。guardこそがbad readをsilenceへ変換するものだからです
同じreleaseで苦い経験から学んだprocess上の最後の要素があります。assertするのは今作ったin-memory modelではなく、saveしてreopenしたworkbookにしてください。2.376.0 batchでは、SXEx emitter([MS-XLS] 2.4.282)が24-byte bodyを宣言して22 byteしか書かない問題も見つかりました。PivotTable view以降のすべてのrecord、worksheet EOF、続くchart sheet substreamがずれます。既存のpivot testが見逃したのはすべてmemoryに対してassertしていたためです。string decodingも同じ性質を持ちます。byte countを実際にexerciseするのは、fileを通したround tripだけです
DelphiまたはC++Builderでclassic XLS internalsを扱い、自分のBIFF8 record readerを保守したくないなら、上記encoding ruleはHotXLS Delphi spreadsheet componentにすでに実装され、regression testされています。ExcelやOLE automationなしでXLSとXLSXをreadとwriteできます