PDFがフォントを埋め込んでいないとき、HotPDFコンポーネントはそのテキストを、HPDFMapBaseFontToSystemが選んだインストール済みWindowsフォントで描画します。このマッパーは/BaseFont名をデコードし、スタイル部分を剥ぎ、GDIがファミリーのインストールを確認するまでいくつかの綴りを試し、欠けている標準14フォントの幅をメトリック互換フォントから測り、描画の前に1バイトコードをUnicodeへ変換します。これらのステップの1つ1つは、素直なやり方が実在のファイルで失敗するから存在します。RenderLoadedPageToBitmapページレンダラーは埋め込みプログラムをよく扱います。ここは、ファイルの中にまったくないフォントの話です
GDIはなぜ非埋め込みフォントに黙って間違った書体を描くのか
GDIは欠落フォントを報告しません。知らない書体名をCreateFontIndirectへ渡すと、黙って代替品を選びます。しばしばボールドの重みのない別のセリフ体です。PDF名をほぼそのまま渡すと、TimesNewRoman,Bold、TimesNewRomanPS-BoldMT、SegoeUI-Semiboldはどれも何にもマッチせず、GDIが選んだもので出てきます。名前はもっとひどいこともあります。ISO 32000-1 §7.3.5は、名前が任意のバイトを#xxとして書くことを許し、CJKのプロデューサーはフォント名をエスケープしたUTF-8やレガシーコードページのバイトで綴るのが日常です。デコードのステップを飛ばすマッパーは、エスケープ自体を名前に持つ書体をGDIに頼みます。HPDFMapBaseFontToSystemはエスケープをまずデコードし、有効なUTF-8バイト列を文字として返し、その他の高位バイトはシステムコードページで読みます
スタイルを切り離すところで、ヒューリスティックが歯を立てます。カンマは常にファミリーを終えます(Arial,BoldはArialに)。しかしハイフンは、後ろの単語がスタイルであるときだけ終えます。Bold、Italic、Oblique、Regular、Roman、Medium、Light、Black、Heavy、Semi、Demi、Thin、Extra、Ultra、Condensed。このルールはMS-Minchoをそのまま保ちつつ、Calibri-LightをCalibriへ変えます。HotPDFは次に、ファミリーの綴りを試し、続いてPSMT、MT、PSのサフィックスを取り除いたファミリーの綴りを試します。これらの綴りは、単語が始まりうる場所のあらゆるスペースの選択を網羅します。小文字の後に来る大文字の前(MyriadProはMyriad Proへ)、小文字が後に続くランの最後の大文字(UIGothic)、先頭のMSの後(MSPGothic)。完全にスペース入りの形から、書かれたままの名前まで。そのような場所が4つを超えると、完全スペース入りと結合形だけが試されます。スペースは盲目的に適用できません。Windowsは一部の単語を結合したまま保つからです。SimSunはまさにその綴りでインストールされており、MicrosoftYaHei、MicrosoftJhengHei、MSPGothicはMicrosoft YaHei、Microsoft JhengHei、MS PGothicに属します。すべての内側の大文字の前にスペースを入れるマッパーは、MicrosoftYaHeiをMicrosoft Ya Heiとして検索し、決して見つけられません。候補がインストール済みと数えられるのは、CreateFontIndirectに続くGetTextFaceが要求した名前を返すとき、あるいは選択されたフォントのnameテーブルがそれをファミリー、完全またはタイポグラフィックファミリー名として任意の言語で載せているときです。答えは名前ごとにキャッシュされるので、インストールされていないフォントを多く持つ文書が、ページごとにWindowsへ名前の数だけ問い合わせることはありません
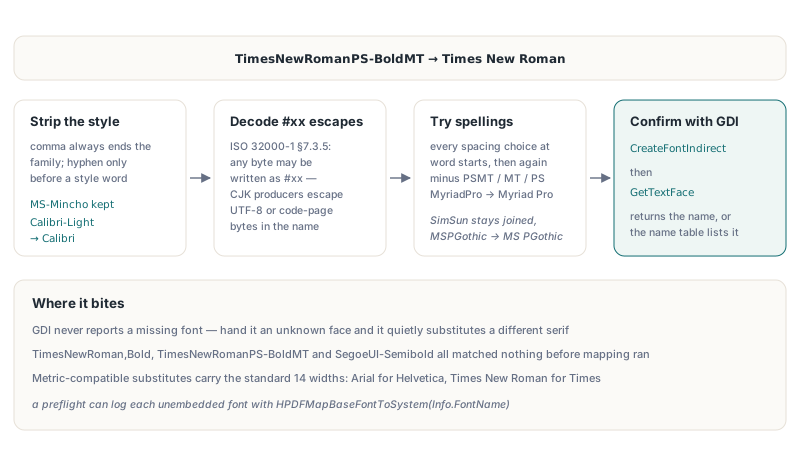
マッピング関数はHPDFRenderFontMetricsユニットで公開されているので、プリフライトレポートは、各非埋め込みフォントがどのインストール済みファミリーで描かれるかを示せます。THotPDFがロード済み文書のためにすでに公開しているフォント列挙を使って:
uses
  HPDFDoc, HPDFRenderFontMetrics;

procedure ListSystemFontMappings(Pdf: THotPDF; Log: TStrings);
var
  Page, I: Integer;
  Info: THPDFLoadedFontInfo;
begin
  for Page := 0 to Pdf.LoadedPageCount - 1 do
    for I := 0 to Pdf.GetLoadedFontCount(Page) - 1 do
      if Pdf.GetLoadedFontInfo(Page, I, Info) and not Info.IsEmbedded then
        Log.Add(Format('page %d  /%s  %s -> %s',
          [Page + 1, string(Info.ResourceName), string(Info.FontName),
           HPDFMapBaseFontToSystem(Info.FontName)]));
end;
/Widthsを持たない標準14フォントをHotPDFはどう測るか
HotPDFは欠けているアドバンスを、同じメトリックを持つインストール済みフォントで測ります。ISO 32000-1 §9.6.2.2は標準14フォントが/Widthsを省略することを許し、ライブラリはAFMテーブルを同梱しないからです。ArialはHelveticaのメトリックを、Times New RomanはTimesを、Courier NewはCourierを運ぶので、HPDFMeasureBaseFontWidthsはlfHeight = -1000で対応する書体を作り、GetCharWidth32Wを呼びます。その高さでは結果が、PDFの幅が使う1/1000 em単位ですでに得られます。レンダラーはまず、各コードを/Encoding、/BaseEncoding、/Differencesを通ってUnicodeへ変え、StandardEncodingへデフォルトします。SVGエクスポートとテキスト抽出にはもう1つの罠があります。/Encodingをまったく持たない標準Type 1フォントにも、暗黙のStandardEncodingがあります。それなしに作られたデコーダーはエンコーディング情報を持たず、測られた幅はすべて未使用になります。HotPDFは暗黙のStandardEncodingを供給し、事前定義エンコーディングとしてマークします。CMap名の経路へ流すと、すべてのコードが0としてデコードされ、すべての幅がそれに従います
ボールド、イタリック、そして1ベースのフォントディスクリプターフラグ
フォントディスクリプターの/Flagsエントリーは、ビットを0でなく1から番号付けします。だからForceBoldはビット19($40000)、Italicはビット7($40)です。ISO 32000-1 Table 123のとおり。1ビットのずれは起こしやすいものです。ゼロから数えると$20000はForceBoldに見えますが、実際はビット18のSmallCapで、これに対するウェイトテストはすべてのスモールキャップス書体をボールドで描きます。この罠は隠れやすくもあります。/FontDescriptorはほとんど常に間接参照で、直接オブジェクトしか読まないコードは、フラグ分岐にそもそも届きません。同じ盲さは/Widths 12 0 Rも無視し、テキストをフォールバックアドバンスで組みます。間接参照の解決と、ビット定数をTable 123に固定することは、セットで行うべき作業です:
const
  // ISO 32000-1 Table 123はビット位置を1から数える
  FD_ITALIC     = $00040;  // ビット7
  FD_SMALLCAP   = $20000;  // ビット18、ウェイトではない
  FD_FORCEBOLD  = $40000;  // ビット19

procedure ApplyDescriptorFlags(Flags: Integer; var LF: TLogFont);
begin
  if (Flags and FD_FORCEBOLD) <> 0 then
    LF.lfWeight := FW_BOLD;
  if (Flags and FD_ITALIC) <> 0 then
    LF.lfItalic := 1;
end;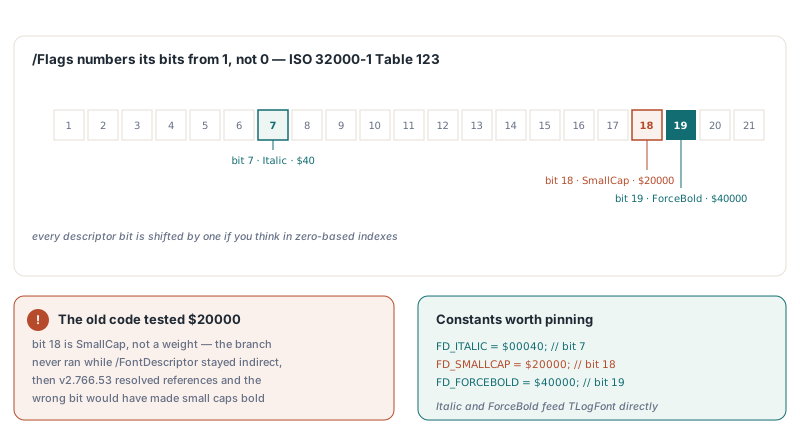
UCS2 CMapを持つCJKフォントはなぜ間違った幅を得るのか
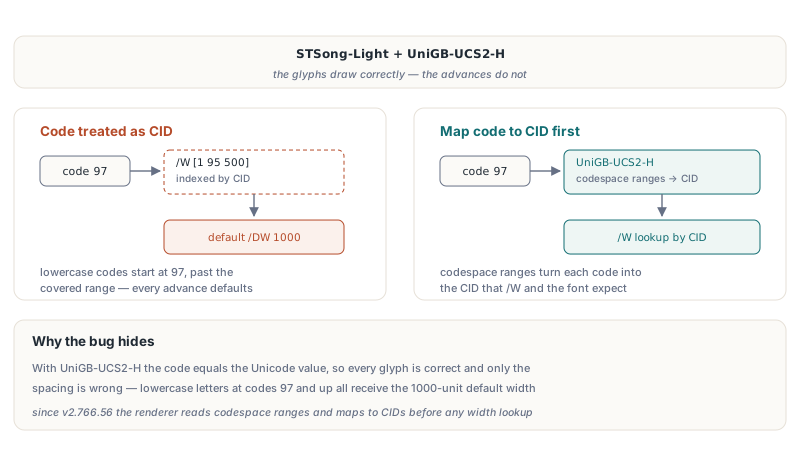
事前定義UCS2 CMapを持つCJKテキストは、レンダラーがコードをCIDとして扱うと、正しいグリフを間違ったスペーシングで描きます。/Wは文字コードでなくCIDでインデックスされるからです。STSong-LightとUniGB-UCS2-Hでは、コードがたまたまUnicode値と等しいので、GDIは正しい文字を描き、間違いはアドバンスに隠れます。小文字はコード97以上として届き、[1 95 500]のような/Wエントリーの外に落ち、すべてがデフォルト幅/DWの1000を受け取ります。HotPDFレンダラーは、コードをCMapのcodespaceレンジ(ISO 32000-1 §9.7.6.2)を通って読み、幅を検索する前にCIDへマップします。使うのは内蔵のUCS2とUTF16テーブル、そして埋め込みCMapストリームです。GBK-EUC-Hのようなものへのidentity近似は、対応しているように見えるだけで間違った出力を出すので、意図的に使っていません
中国語Windowsでアクセント付き文字が疑問符になる理由
1バイトコードは、ANSI(「A」)のGDI関数へ決して届いてはなりません。GetGlyphOutlineAとGetGlyphIndicesAはバイトをシステムコードページで解釈し、TextOutAは選択されたフォントの文字セットを使うからです。中国語のシステムでは、Arialのバイト$A9(Windows-1252の著作権記号)がGBKのリードバイトになり、「?」として描かれます。A関数を呼ぶアウトライン経路は、みなまっすぐ踏み込みます。HotPDFは、実体化されたフォントにGetTextCharsetで文字セットを問い、TranslateCharsetInfoでコードページへ変え、バイトをMultiByteToWideCharに通し、W関数を呼びます。シンボルフォントは代わりにU+F000プラスコードを使います。Windows-1252と食い違うエンコーディング、つまり/Differences、StandardEncoding、MacRomanEncodingは、システムフォントが見る前にUnicodeへマップされます
システムフォントでの描画はどこまで届くのか
システムフォント描画は本質的に近似であり、ローカライズされたWindowsがひねりを足します。GetTextFaceはファミリー名をシステム言語で報告するので、名前比較だけでは、中国語WindowsのMicrosoft YaHeiや日本語WindowsのYu Minchoが欠落と判定されます。だから別の名前で戻ってきた書体も、フォントのnameテーブルで検索するのです。メトリック互換があるのはHelvetica、Times、Courierのファミリーです。SymbolはSymbolへ、ZapfDingbatsはWingdingsへマップされます。マッチでなくその場しのぎです。上のプリフライトは各ページの/Resources辞書を歩くので、フォームXObjectの内側からだけ参照されるフォントには、自分用のパスが要ります。コードがどうしても描けないとき、描画時の未解決グリフ追跡がそれを報告します。サムネイルを睨むより良いシグナルです
恒久的な答えは、作成側にあります。HotPDF自身はFontEmbeddingをデフォルトでTrueにして書き出します。コードがHelveticaでSetFontを呼んでも、埋め込みArialで代替します。埋め込みテキストは、上の推測のどれでもなく、埋め込みフォントグリフレンダラーを通ります。入ってくるファイルのための手軽なガードは、マップされたファミリーがスクリーンフォントリストにないとき、描画の前に警告することです:
// VCL:Screen.Fontsがインストール済みファミリー名を列挙する(Formsユニット)
function MissingSystemFamily(const BaseFont: AnsiString): Boolean;
begin
  Result := Screen.Fonts.IndexOf(HPDFMapBaseFontToSystem(BaseFont)) < 0;
end;ページレンダリング、テキスト抽出、書き出し側のフォントサブセット化を含むコンポーネントの全体は、HotPDF Delphi PDF componentの製品ページへ