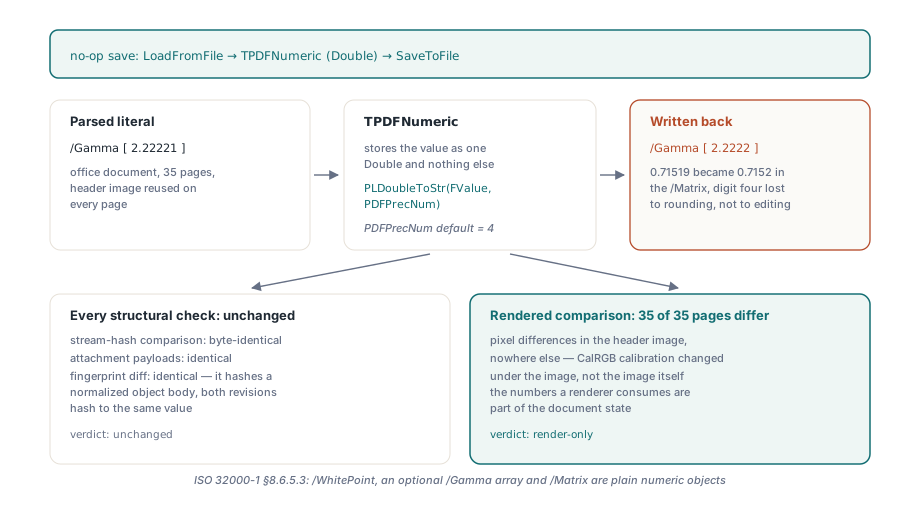
キャリブレーション済みのPDFを読み込み、何も変更せずに別名で保存し、カラースペース辞書をdiffしてみてください。/Gamma [2.22221 2.22221 2.22221] が入って、/Gamma [2.2222 2.2222 2.2222] が出てきます。ライタは触れる必要のなかった数値を勝手に再フォーマットし、ページはわずかに違う色で描画されるようになります。治し方は、解析したすべての小数を、演算用の値と出力用のリテラルという2つの顔で同時に扱い、誰かが実際に新しい値を代入するまでリテラルを出し続けることです
何も変えない保存でCalRGBの色がずれる理由
ピクセルがずれるのは、画像バイトはそのままなのに、レンダラに渡されるキャリブレーションデータがわずかに違うからです。ISO 32000-1 §8.6.5.3 は CalRGB カラースペースを、必須の /WhitePoint、省略可能な3要素の /Gamma 配列、省略可能な9要素の /Matrix で定義しており、いずれもカラースペース辞書内の単なる数値オブジェクトです。これを Double で通し、小数第4位固定のフォーマッタに流すと、2.22221 は 2.2222 になり、0.71519 のマトリクス要素は 0.7152 になります。ガンマ値は、そのスペースを通る全ピクセルの全成分に適用される指数であるため、変更はスペースが使われている場所すべてに現れます
35ページで再利用されるヘッダー画像のために1つの CalRGB スペースを宣言しているファイルなら、35ページすべてのヘッダーがずれた色で描画され、それ以外は何も変わりません。最初に思いつくチェックはすべて無傷で通ります。デコード済みストリームバイトのハッシュは画像データを比較しますが、画像データは本当に同一であり、損傷は辞書の中にあります。修正レベルの記事で述べたリビジョンdiffは正規化したオブジェクト本文のフィンガープリントを取るため、ここでも2つのリビジョンは同じ値にハッシュされます。これを捉えるのは描画結果の比較です。他社製ソフトウェアが作ったPDFを書き換えるパイプラインなら、構造チェックすべての前にページごとの描画比較を置くことを勧めます
PDFの実数はどのような形を許されるのか
ISO 32000-1 §7.3.3 は実数を小数文字列と定義します。オプションの符号、数字、ピリオド、さらに数字です。基数表記はなく、指数形式もありません。実装限界を列挙する Annex C は、小数部でおよそ5桁の有効10進数字が尊重されることを期待しています。したがって4桁という既定の出力精度は、仕様がリーダに守るよう求めている桁より1つ下に最初からあり、5桁を使ったファイルに落ち度はありません
ゼロ近傍では、素朴なフォーマッタは1桁失うよりもひどいことをします。Double をN桁で印字するよくある方法は、10^N を掛けて整数に丸め、桁を書き出すもので、その整数がゼロになると出力は 0 になります。0.00001 0 0 1 0 0 cm の最初のオペランドを4桁で渡すと、結果は 0 0 0 1 0 0 cm となり、特異行列のもとで描かれるものはすべて消えます。-0.000012345 という /Matrix 要素も同じ道を辿ります
PDF Library for Delphi(PDFlibPas)が自前で Double をフォーマットしなければならないときは、精度ステップより小さい非ゼロ値について要求された有効桁数を保ち、0 とは書きません。4桁設定で 0.00001 は 0.00001 と、0.0000123 は 0.0000123 と書かれ、およそ 5E-16 を下回る桁だけが 0 として出てきます。新規に書く数値はこれで健全です。一方、再フォーマットの必要のない解析済み数値は話が別で、ライブラリは「そもそも再フォーマットしない」という方法でこれを扱います
PDFlibPasが解析したリテラルを保持する仕組み
TPDFStructure.Decode は、トークナイズしたすべての標準実数、つまり小数点を含み指数マーカーを含まないトークンのソーステキストを、変換後の Double の隣に保持します。TPDFNumeric.Output は、そのテキストがあればそれを書き戻し、なければ初めて Double を構造の PDFPrecNum でフォーマットします。TPDFNumeric.SetTo はテキストを破棄します。編集された数値は新しい数値であり、現在の出力精度に従うべきだからです
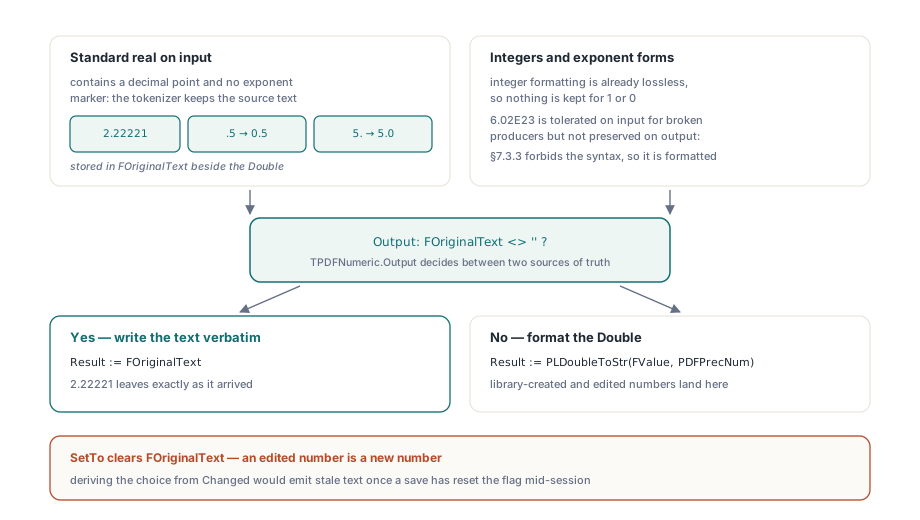
リセットを SetTo に結び付けたのは意図的な判断です。魅力的な近道は、オブジェクトの Changed フラグが立っていない限り元テキストを出すやり方です。そのフラグはすべてのオブジェクトに既に存在します。しかし保存パイプラインはオブジェクトを書き出した時点で Changed をクリアするため、同じセッション内で値を編集・保存・再編集すると、2回目の保存で古いリテラルを出力する状態に逆戻りします。代入そのものの中でテキストをクリアすれば、リテラルと値が食い違うことは永遠にありません
意図的な境界がいくつかあります。整数はテキストとして格納しません。整数のフォーマットはすでに無損失だからです。6.02E23 のような指数形式は、そう書くプロデューサーのために入力で受け付けますが、出力ではライブラリ生成の数値と同様にフォーマットされます。そのままコピーし戻すと、§7.3.3 が排除する構文を永続させることになるからです。トークナイザはテキストを格納する前に通常の小さな修復も適用します。.5 のような先頭ドットのリテラルは 0.5 として、5. のような末尾ドットのリテラルは 5.0 として保持されます。どのリーダも各ペアを同じ数値として扱い、修復された綴りのほうがはるかに広く受け入れられます
以下のスニペットは CalRGB の値をオブジェクト層へ直接通すため、PDFファイルを開かずに各規則を確認できます。Assert の行は、自分のテストに追加することを勧めるチェックであり、ライブラリへの呼び出しではありません
uses
  PDFlibStruct;

var
  Structure: TPDFStructure;
  Values: TPDFArray;
  Number: TPDFNumeric;
begin
  Structure := TPDFStructure.Create;
  try
    Structure.PDFPrecNum := 4;
    Values := TPDFArray(Structure.Decode('[2.22221 0.71519 -0.000012345 1 0.12567]'));

    // 自前のチェック:未編集の入力はそのまま生き残る。素朴な4桁
    // フォーマッタなら 0 に潰れる値も含めて
    Assert(Values.Output = '[ 2.22221 0.71519 -0.000012345 1 0.12567 ]');

    // 編集すると元テキストは破棄され、PDFPrecNum に従う
    Number := TPDFNumeric(Values.Item[0]);
    Number.SetTo(0.123456);
    Assert(Number.Output = '0.1235');
    Assert(Structure.NewNumeric(0.123456).Output = '0.1235');

    // 微小な新規値は 0 になる代わりに有効桁を保つ
    Assert(Structure.NewNumeric(0.0000123).Output = '0.0000123');

    // 後から精度を下げても未編集の入力には届かない
    Structure.PDFPrecNum := 2;
    Assert(TPDFNumeric(Values.Item[1]).Output = '0.71519');
  finally
    Structure.Free;
  end;
end;
こうしたアサーションを書くときの罠が1つあります。Delphi の Round は銀行家の丸めを使い、0.000012345 * 1e8 は2進では 1234.4999… と評価され、1234.5 にはなりません。ゼロ近傍のフォーマット経路を調べていたとき、この値にそのままぶつかりました。最後の1桁の丸め方に依存するアサーションでは、2進の中間点にならないテスト入力を選んでください
SetPrecisionは何を制御するのか
TPDFlib.SetPrecision は、ライブラリが書き出す数値の小数桁数を設定します。ペインター経由で描かれるグラフィックス、NewNumeric など Double から作られる数値、そして SetTo で後から変更された解析済み値が対象です。2から8を受け付け、その範囲外には 0 を返します。誰も編集していない解析済み小数は、設定が何であれ入力テキストを保ち、LoadFromFile の後に設定を変えても過去の入力には届きません。SetObjectFromString に渡されたソースも同じトークナイザを通り、同じ方法で保持されます
私たちのおすすめは、生成するジオメトリがより細かいステップを必要としない限り SetPrecision に手を触れないことです。入力ファイルを守るつもりで上げても得るものはありません。未編集の入力は既に自分の桁を保っており、上げれば描くすべての数値が長くなるだけです。ポイント未満の描画作業には5桁が妥当な選択で、8は主にコンテンツストリームを膨らませます
uses
  PDFlibrary;

var
  PDF: TPDFlib;
begin
  PDF := TPDFlib.Create;
  try
    if PDF.LoadFromFile('calibrated.pdf', '') <> 1 then
      Exit;

    // これ以降に書き出す数値に効く。解析済みの /Gamma、
    // /Matrix、/WhitePoint 配列は元のテキストを保つ
    PDF.SetPrecision(5);

    PDF.SelectPage(1);
    PDF.SetLineWidth(0.123456);       // 描画される数値は5桁を使う
    PDF.DrawLine(72, 72, 300, 72);

    PDF.SaveToFile('calibrated-out.pdf');
  finally
    PDF.Free;
  end;
end;
コンテンツストリーム:編集はオペランドを保ち、正規化はオプトイン
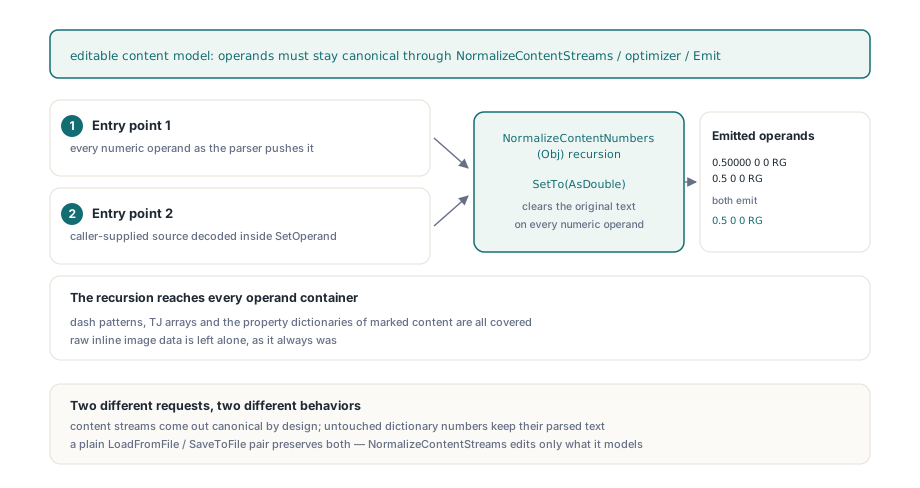
編集可能なコンテンツモデルは、既定ではオペランドのテキストを保持し、正規化された出力が呼び出しの目的である場合にのみ数値を正規化します。TPDFContentProgram.CanonicalNumbers の既定値は False です。したがって ParsePageContentLayer が返すレイヤー、グラフィックスステートトラッカーの土台と同じモデルは、触れていない数値オペランドを書かれたとおりにそのまま再出力します。レイヤー全体を書き換えるページ編集、つまり ScalePage、TransformPageElement、DeletePageElement、RedactRegion、ConvertTextToPaths、そして WritePageContentLayer で書き戻す自分のプログラムは、その編集が触れたオペランドだけを変更します
もう1つの既定、つまりパースのたびに正規化して編集経路と NormalizeContentStreams が常に同じ綴りを出すやり方は、整然として見えます。編集用としては間違った既定だと私たちは考えます。0.123456 w を含むレイヤーへの ScalePage 呼び出しは 0.1235 w を書き戻し、呼び出しが求めたのはスケーリングだけなのに、レイヤー内の他のすべてのオペランドも書き直されることになります。正規形が属するのは、比較可能な出力を目的とする操作です
そうした操作は今でも正規形を得られます。NormalizeContentStreams と保存時のコンテンツオプティマイザは、CanonicalNumbers を True にしてパースします。任意の入力から安定した出力を出すのが仕事だからです。0.50000 0 0 RG と 0.5 0 0 RG が違う綴りで出てきたら、下流の比較はすべてプロデューサーのフォーマット習慣に引きずられてずれていきます。正規化は配列と辞書を再帰的にたどるため、ダッシュパターン、TJ 配列、マーク付きコンテンツのプロパティ辞書もカバーされ、生のインライン画像データは放置されます。SetOperand 経由で与えられたオペランドは、フラグの値にかかわらず正規化されます。コンテンツプログラムは SetPrecision とは独立に、小数第4位固定の独自の数値ストアを持つため、編集されたオペランドは4桁で出てきます。フラグを読むのは Parse だけなので、パース前に設定しなければなりません。ParsePageContentLayer が既にパースしたプログラムでは、フラグを設定してから Parse(Emit) を呼びます
uses
  PDFlibrary, PDFlibContentModel, PDFlibContentOps;

var
  PDF: TPDFlib;
  Prog: TPDFContentProgram;
  I: Integer;
begin
  PDF := TPDFlib.Create;
  try
    if PDF.LoadFromFile('calibrated.pdf', '') <> 1 then
      Exit;
    PDF.SelectPage(1);
    Prog := PDF.ParsePageContentLayer(1);
    if Prog = nil then
      Exit;
    try
      // 線幅を1つ変える。他のオペランドはソーステキストを保つ
      I := Prog.FindNextOp(0, coLineWidth);
      if I >= 0 then
        Prog.SetOperand(I, 0, '0.123456');   // 0.1235 として出力される
      PDF.WritePageContentLayer(1, Prog);

      // 比較専用の正規コピー。書き戻しはしない:
      // フラグを読むのは Parse だけなので、設定後に再パースする
      Prog.CanonicalNumbers := True;
      Prog.Parse(Prog.Emit);
      // Prog.Emit は 0.50000 と 0.5 を同じ綴りで出すようになる
    finally
      Prog.Free;
    end;
    PDF.SaveToFile('calibrated-out.pdf');
  finally
    PDF.Free;
  end;
end;
まとめると、呼び出し側の規則は短いです。素朴な LoadFromFile に SaveToFile を続ければ、触れていないコンテンツストリームと触れていない辞書数値は元のままです。コンテンツモデル経由で編集したページは、その編集が変更しなかったすべてのオペランドのテキストを保ちます。NormalizeContentStreams、保存時にコンテンツを圧縮する際に走るオプティマイザ、そして CanonicalNumbers を True にしてパースされたプログラムは設計どおり正規化された数値を出し、文書のそれ以外は引き続き保存されます
何を犠牲にし、保証はどこで止まるのか
すべての TPDFNumeric は AnsiString の参照を1つ余分に持ち、解析されたすべての小数はオブジェクトが生きている間、ソーステキストを生かし続けます。数百万の実数を含む文書では測定可能なメモリ量であり、実行する大規模文書ベンチマークには織り込んでおくべきものです。保証の範囲は、数値の属する文書単位でもあります。文書間でオブジェクトをコピーしたり、オブジェクト API 経由で値を作り直したりすると新しい数値が生まれ、新しい数値は出力精度に従います
保持された数値とバイト単位で同一な出力は、別の性質です。未編集の文書のロード・アンド・セーブは、レンダラが消費するキャリブレーション数値を保ちますが、バイト単位の同一性はさらに、オブジェクト番号、ストリーム圧縮、決定論的 PDF ID の記事で扱うトレイラー識別子にも依存します。フィンガープリントdiffは正規化した本文をハッシュし続けるため、他社ツールが書いたファイルでの丸めの違いは比較対象の外側です。それを見るのは描画比較のままです
数値の扱いと正確な SetPrecision のセマンティクスは、losLab PDF Developer Library のリファレンスで、上記で使ったコンテンツモデルの呼び出しとともに解説されています