LZWエンコーダの辞書は、その出力を読むデコーダより常に1エントリ先行しているため、両側で単一のコード幅しきい値を共有できません。PDFlibPasはTPLLZWEncoderとTPDFLZWDecompressorに、同じEarlyChangeフラグから導出した別々のしきい値を持たせています。この1エントリの先行こそ、そのフラグが存在する理由のすべてです
手書きのLZW実装は、ほとんどすべて同じ場所を間違えます。まずデコーダを書きます。ファイルを開くために必要なのはそちらだからです。それは動きます。次にエンコーダを書きます。LZWは対称的だからと、デコーダのロジックを1行ずつ写します。ラウンドトリップテストを実行すると通ります。出荷します。6か月後、顧客があなたの出力を他所のビューアで開くと、ストリームの途中から先はすべてゴミです。バグの正体はミラーリングでした。LZWの2つの半分は対称ではなく、対称だと思い込むと、自分のコードでしか読めないストリームができあがります
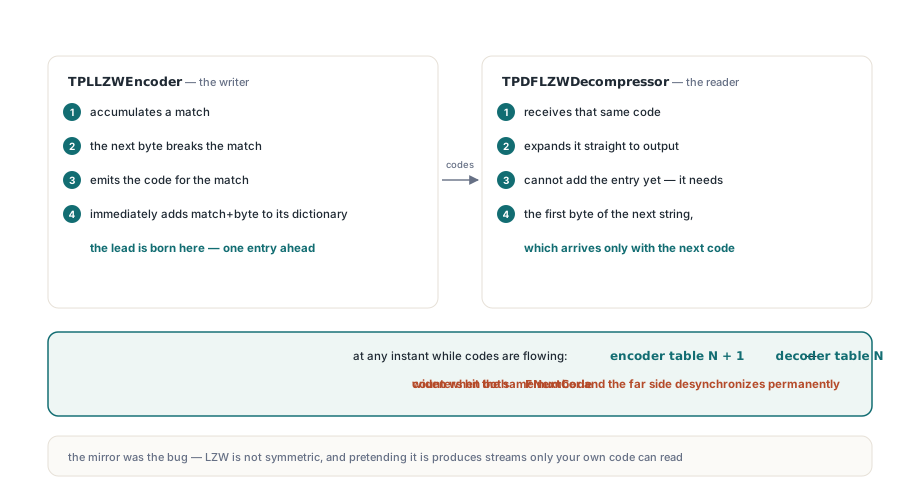
エンコーダはなぜデコーダと異なるしきい値が必要なのか
エンコーダは各辞書エントリを、デコーダより1ステップ先に学習するからです。これはPDFlibPasの設計判断ではなく、LZWの仕組みに内在する性質で、正しい実装はどこかで必ずこれを補正しています。ループを追いかけると先行の出所が見えます。エンコーダはマッチを蓄積し、次のバイトがそれを壊すことを見つけ、マッチのコードを出力し、すぐにマッチ+バイトを辞書に追加します。デコーダは同じコードを受け取って展開しますが、対応するエントリはまだ追加できません。新しいエントリには次の文字列の先頭バイトが必要で、それは次のコードとともにしか届かないからです。したがってコードが流れている間、エンコーダのテーブルは常にデコーダより1エントリ多くなります。両側が自分のFNextCodeで同じ数値に達したときにコードを9ビットから10ビットへ広げると、1コード分ずれて広がり、遠い側のビットリーダは永久に同期を失います。TPDFLZWDecompressor.ResetDictionaryでは、デコーダ側のしきい値が一度だけ計算され、FChangeCodeに格納されます
// TPDFLZWDecompressor.ResetDictionary:しきい値のデコーダ側
FCodeSize := FInitialCodeSize;                 // PDFのLZWDecodeでは9
FBitMask  := (Cardinal(1) shl FCodeSize) - 1;  // 511
if FEarlyChange then
  FChangeCode := FBitMask                      // FNextCodeが511に達したら広げる
else
  FChangeCode := FBitMask + 1;                 // FNextCodeが512に達したら広げる
FClearCode := 1 shl (FCodeSize - 1);           // 256
FEOICode   := FClearCode + 1;                  // 257
FNextCode := FClearCode + 2; // 258デコードループはエントリを追加した直後に幅を広げ、(FNextCode = FChangeCode) and (FCodeSize < 12)を検査して、新しい幅に合わせてFBitMaskとFChangeCodeの両方を再計算します。9ビットは511または512で切り替わり、10ビットは1023または1024、11ビットは2047または2048です。12ビットが上限で、そこでは辞書を成長させる代わりにClearCodeでフラッシュしなければなりません。エンコーダはこれらの数値をそのまま再利用できません。GrowCodeSizeは先行を補正するために1を足すので、EarlyChangeが設定されていればデコーダが511で広げるのに対し、エンコーダは512で広げます
procedure GrowCodeSize(FinalDataCode: Boolean);
var
  ChangeCode: Cardinal;
begin
  if FCodeSize >= 12 then
    Exit;
  if FEarlyChange then
    ChangeCode := Cardinal(1) shl FCodeSize          // 9ビット時は512
  else
    ChangeCode := (Cardinal(1) shl FCodeSize) + 1;   // 9ビット時は513
  // デコーダはEOIを読む前に最後の保留エントリを追加する
  if FinalDataCode then
    Dec(ChangeCode);
  if FNextCode = ChangeCode then
    Inc(FCodeSize);
  end;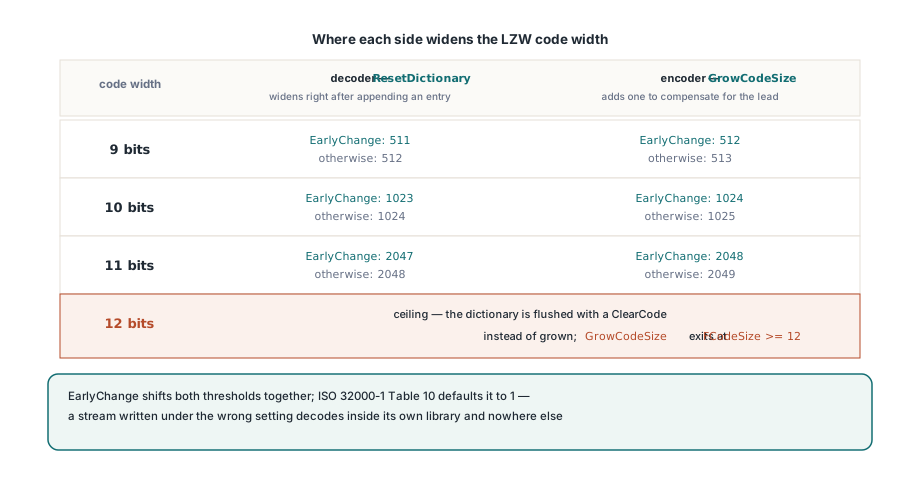
最後のデータコードで両側がようやく合流する
ストリームの末尾は、エンコーダが先行をやめてデコーダのように考える必要がある唯一の場所で、GrowCodeSizeのFinalDataCodeパラメータはそのためのものです。間違った幅でEOIコードを出力しても、その前のすべては依然として完全に有効なため、欠陥は何千バイトもの正しいデータの陰に隠れます。流れはこうです。エンコーダは最後のデータコードを出力し、それまでの反復とは違ってその後は自分の辞書に何も追加しません。マッチを拡張するための後続バイトが残っていないからです。デコーダは逆のことをします。その最後のコードを受け取り、前のコードから保持してきたエントリをようやく完成させられます。最後のステップでデコーダが追いつき、先行はゼロに縮まり、EOIを読むために使う幅は、エンコーダが作ったことのないエントリによって決まります。Dec(ChangeCode)は、まさに1回の呼び出しだけ、エンコーダがデコーダのふりをする部分です
// TPLLZWEncoder.Compress、ストリームの末尾
EmitCode(CurCode);      // 最後のデータコード。現在の幅のまま
GrowCodeSize(True);     // 減算されたしきい値で広がる可能性がある
EmitCode(FEOICode);     // デコーダが実際に読む幅でEOIを出力
FlushBits;
FlushOutput;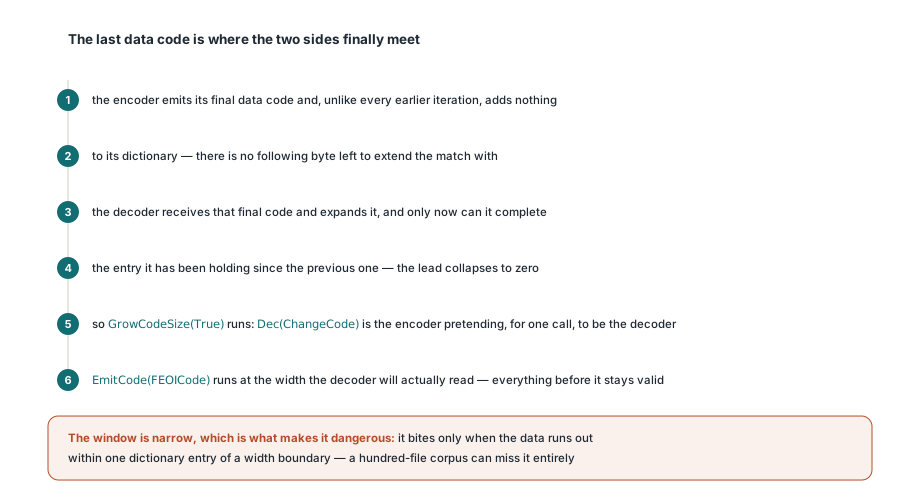
これが重要になる窓は狭く、そこが危険な理由です。データが偶然、幅の境界から辞書エントリ1つ分以内で尽きたときだけ噛みつくため、100ファイルのテストコーパスは完全に見逃しても、顧客の1ファイルは毎回当たります。Compressの境界ケースは意図的に駆動する必要があります。辞書が510、511、512エントリに落ち着く入力を作り、成功したデコードから推測するのではなく、出力されたEOIのビット幅をストリームから手で読み取ります
ラウンドトリップテストが通っても壊れたストリームを隠せるのはなぜか
同じ間違いを犯した2つの実装は、互いに一致するからです。エンコーダとデコーダがどちらも1コード早く広げる、あるいはどちらも1コード遅く広げるなら、両者は完全に同期したままで、ラウンドトリップは入力を1バイトずつ再現し、スイートは緑のまま、あなたが生成したストリームは他の何にも読めません。この一連の作業から得られる最も価値のある教訓はこれだけです。LZWでは、自己整合性は証拠として無価値です。だから自己ラウンドトリップを主要なテストにできず、PDFlibPasはLZW経路を別の3つの方法で検証しています。1つ目は、期待されるビットパターンを手で書き出した手組みコードストリームで、アサーションがデコード結果ではなくバイトそのものについて行われます。2つ目は、独立した実装との双方向相互運用で、このエンコーダが生成したストリームが他所でデコードされ、他所で生成されたストリームがTPDFLZWDecompressorでデコードされます。3つ目は差分デコードで、EarlyChangeを両方向に設定して同じバイトを2回読みます。間違った設定で素直にデコードできるストリームは、幅の境界が一度も行使されていないことを教えてくれます
Dec := TPDFLZWDecompressor.Create;
try
  Dec.EarlyChange := True;
  A := Dec.Decompress(Stream);
finally
  Dec.Free;
end;
Dec := TPDFLZWDecompressor.Create;
try
  Dec.EarlyChange := False;   // PDFには意図的に間違った規則を使う
  B := Dec.Decompress(Stream);
finally
  Dec.Free;
end;
// Aはソースと一致しなければならない。Bは一致してはならない。Bも一致するなら
// 入力が短すぎてコード幅の境界を越えていない
実際にこのカバレッジを与えるのは外部入力です。現在のテスト素材は9、10、11、12ビット幅を横断し、1つのストリーム内で34回の辞書リセットを強制します。4095の天井でのClearCode経路が本当に動くことを証明する現実的な方法はこれだけです。フィクスチャが数キロバイトを超えないなら、そのコードは一度も実行されたことがありません。そして修正がエンコーダの出力を変える場合、古い出力は互換性のベースラインとして保存する価値のあるものではなく、壊れたものとして扱ってください。コード幅を誤って混ぜたストリームはレガシーフォーマットではなく、たまたまディスクに書き込まれたバグです
PDFは1と定め、TIFFは場合による
PDFlibPasがTPLLZWEncoderとTPDFLZWDecompressorの両方でEarlyChangeをTrueにデフォルトするのは、ISO 32000-1のTable 10がEarlyChangeをデフォルト値1のLZWDecodeデコードパラメータと定義し、コード長が1コード早く増えることを意味するためです。これはISO 32000-1 section 7.4.4.2でpredictorパラメータと並んで規定されており、反対の挙動を望むPDFは/DecodeParms辞書で明示的に/EarlyChange 0と書かなければなりません。フラグが定数ではなくプロパティになっている理由はTIFFです。TIFF 6.0 section 13はLZW圧縮を同じような明確な記述なしで説明しており、実世界のエンコーダは歴史的にこの点で分かれています。PDF仕様がわざわざパラメータに名前を付けたのは、おそらくそのためでしょう。TIFFからPDFへのパイプラインでは、この設定はどちらかの端にハードコードできるものではありません。TIFF側が結局必要としたものを、PDFの/DecodeParmsへ明示的に持ち込む必要があり、そうしなければ、問題なく開けていたファイルを開けないファイルへ変換することになります。同じ注意はFillOrderにも当てはまります。foTopとfoBottomはビットリーダがバイトのどちらの端から埋めるかを選びます。TIFF Predictor 2の水平差分も同様で、TPDFLZWParmsはPredictor、Colors、BitsPerComponent、Columnsを通じて持ち運びます。その経路の残りは、BigTIFFとタイルレイアウト向けに組み込みTIFFデコーダを堅牢化するのノートでカバーしています
名前を挙げる価値のある小さな罠が2つ
エンコーダとデコーダのオブジェクトを並べて開き、ここでも対称性が成り立つと思い込むと、どちらも簡単に間違って配線されます
InitialCodeSizeは両クラスで同じ意味ではありません。TPLLZWEncoder.InitialCodeSizeはルートシンボルの幅で、2から8までで検証され、InitDictionaryがFClearCodeを1 shl FInitialCodeSizeとして導出し、FCodeSizeをFInitialCodeSize + 1に設定します。TPDFLZWDecompressor.InitialCodeSizeは最初のコード幅で、2から9までで検証され、ResetDictionaryがFClearCodeを1 shl (FCodeSize - 1)として導出します。通常の8ビットPDFデータではデフォルトはそれぞれ8と9で、気づくことはありません。手で同じ数値に設定すると、不整合なペアを組んだことになります- 信頼できないLZWのデコードは、正しさの問題である前にメモリ安全性の問題です。辞書インデックスがファイルから直接来るからです。
TPDFLZWDecompressorは4095を超えるコード、またはFNextCode以上のコードを拒否し、4095を超えるエントリの追加を拒否し、GetNextCodeのたびに残りの入力をビット単位で検査し、SawExplicitEOIを公開して、呼び出し側が正しく終端されたストリームと単にバイトが尽きたストリームを見分けられるようにします。切り詰められたストリームは部分的な成功ではありません。悪意のあるファイルに備えてPascal PDFパーサを堅牢化するの広範な調査が、これらのガードが塞ぐ欠陥のクラスをカバーしています
結局何が残るのか
LZWは対称に見えて、実際は違います。エンコーダ辞書はストリームの本体を通じて1エントリ先行し、先行は最後のコードで消えます。だから正しい実装は2つのしきい値と1つの特殊ケースを持ち、EarlyChangeフラグが両方のしきい値をまとめてずらします。どちらかが1コードずれると、有効なままで有効でなくなる出力ができあがります。どこにもエラーも例外もなく、どこかのビューアがノイズを描画するだけです。正直な限界は、これらはどれも内部からはテストできないことです。自分のスイートの中に、正しいストリームと一貫して間違ったストリームを区別できるものは何もありません。相互運用の検査は任意の追加パスではなく、手に入る唯一の本当の証拠です。両クラスはPDF Library for Delphiに同梱され、ライブラリがサポートするコンパイラバージョンにわたるDelphiとC++Builder向けに、オブジェクトストリームとクロスリファレンスストリームのノートで説明した周辺構造の作業も処理します