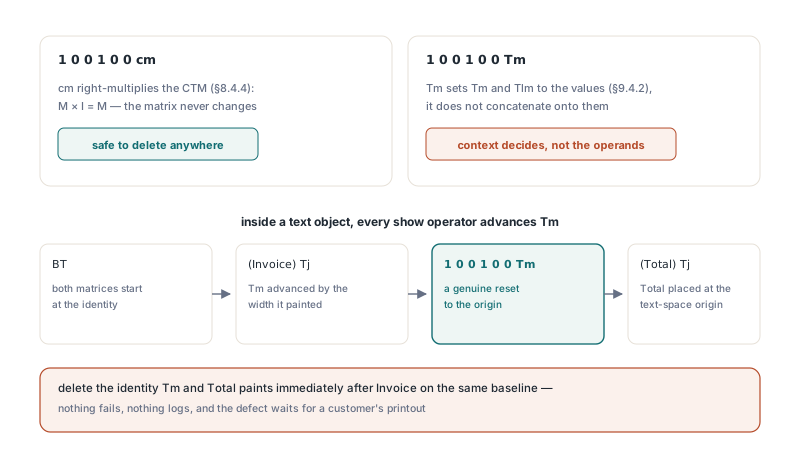
レポートジェネレーターが書きそうなコンテンツストリーム、BT (Invoice) Tj 1 0 0 1 0 0 Tm (Total) Tj ETを取り上げ、6つの数値が単位行列を綴っているという理由で1 0 0 1 0 0 Tmを剥ぎ取ったとします。結果を描画すると、"Total"はもうテキスト空間の原点から始まりません。"Invoice"が終わった場所、同じベースライン上から始まります。identityのTmが冗長なのは、テキスト行列とテキストライン行列がすでにidentityを保持している間だけです。BTの直後、あるいは別のidentityTmの直後です
削除は誘惑的です。同じ6つの数字は、cmの前では本当に死に重りだからです。2つの演算子を同じように扱うコンテンツストリーム最適化器は、多数のストリームを正しく縮めます。それから、identityのTmを復帰改行として使うジェネレーターに出会い、テキストが動きます
なぜ1 0 0 1 0 0 Tmは常にno-opではないのか
2つの演算子は違う算術をします。ISO 32000-1の§8.4.4はcmを、オペランドと現在の変換行列の連結と定義します。任意の行列にidentityを掛ければ同じ行列が戻るため、1 0 0 1 0 0 cmは現れた場所ならどこでも削除できます。Tmは代入です。§9.4.2の下で、テキスト行列とテキストライン行列の両方をオペランドに設定し、それらが保持していたものを捨てます。つまり、何かを変えるかどうかは、完全にその手前の演算子次第です
§9.4.1は、BTが両方の行列をidentityから始めると述べています。そこから先、テキストオブジェクトの内側のほとんどすべてが、どちらかを少なくとも1つ動かします。Td、TD、T*と非identityのTmはテキストライン行列を再配置します。すべてのテキスト表示演算子(Tj、TJ、'、")は、たった今描いたグリフの幅だけテキスト行列を進め、最後の2つはまず新しい行を始めます。それらのどれかが走った後は、identityのTmは原点への本物の跳ね返りです。上の請求書ストリームはその跳ね返りに依存しています
ストリームを手で追跡すればすぐに片付きます。請求書の例をコンテンツストリームのCTMとテキスト行列状態トラッカーに通すと、記録はcmがCTMへ連結する様子と、Tmが両方のテキスト行列を上書きする様子を示します。同一のオペランドの背後に隠れた2つの違う更新規則です
PDF Library for Delphiがどのidentity Tmを落とすか決める方法
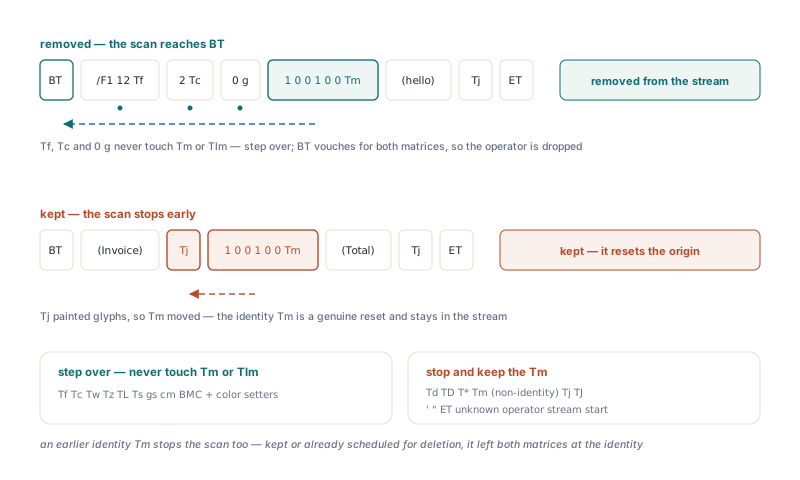
PDF Library for Delphiはピーフホールパスの間にすべてのidentitycmを落とし、identityのTmは、その演算子からの後方スキャンが、テキスト行列を動かし得る何かに出会う前にBTか別のidentityTmへ届いたときに限って落とします。「identity」のテストは数値的です。演算子は1、0、0、1、0、0に等しいちょうど6つの数値オペランドを要するため、1.0 0 0 1.0 0 0 Tmも適格です。後方へ歩くとき、スキャンは出会ったすべての演算子を2つのグループのどちらかへ入れます:
- 停止してTmを保持:
Td、TD、T*、非identityのTm、Tj、TJ、'、"、ET、パーサーが認識しない任意の演算子、またはストリームの先頭 - 読み飛ばしてスキャン継続:テキスト行列やテキストライン行列に決して触れない演算子。たとえば
Tf、Tc、色セッター、gs、marked-content演算子、Do、cm
手前のidentityTmは、オプティマイザーがそれを保持していようが、すでに削除予定に入れていようが、スキャンを削除の側で終わらせます。どちらにせよ、それは両方の行列をidentityに残しました。これはBTが残すのと同じ状態です。だからこそ、BTの直後に並んだ3つのidentityTmの連なりは、何も残さずに潰れます
保守的な停止は意図的です。未知の演算子は何でもあり得るベンダー拡張かもしれないため、スキャンはその先の推論を拒みます。ETの後には開いたテキストオブジェクトがなく、そこに座るidentityTmには、行列の値を保証するBTがありません。スキャンはまた、1度に1つのコンテンツストリームだけを見ます。/Contentsが配列であるページでは重要です。PDFはテキストオブジェクトを1つのストリームで始め、次で続けることを許すため、テキストオブジェクトの途中で、自分のBTなしに開くレイヤーは、前のレイヤーが冗長にしていたとしても、identityのTmを保持します
それが誤るならこちらの側が正しいと考えています。ストリーム境界をまたいで行列を追跡したり、未知の演算子をシミュレートしたりすれば、変なファイル1件あたり、非圧縮テキストのたかだか14バイトを回収するだけです。間違えると、印刷された請求書のグリフが動きます。コストとリスクは同じ級にありません
出力で見えるものを変えるため、知っておく価値のある波及効果が1つあります。同じパスは中身のないテキストオブジェクトも取り除くため、BT 1 0 0 1 0 0 Tm ETは完全に消えます。identityのTmが先に消え、それが残したBT/ETのペアは空だからです
コンテンツストリームの断片でオプティマイザーを走らせる
オプティマイザーは、文字とコンテンツバイトのマッピング解説のように、ページテキストを命令レベルで編集するときに使うのと同じ、パース済みのTPDFContentProgramモデルの上で働きます。そのため、ドキュメント全体を任せる前に、文字列でこの規則を試すのは簡単です。下のヘルパーは復号されたストリームをパースし、TPDFContentPeepholeOptimizerを走らせ、結果を1行に1命令で出力します。Parseの前にCanonicalNumbersを設定するのは、固定精度ですべての数値を書き直す保存時パスを写すためです
uses
  PDFlibContentModel, PDFlibContentOptimize;

function OptimizeSnippet(const Source: AnsiString): AnsiString;
var
  Prog: TPDFContentProgram;
  Optimizer: TPDFContentPeepholeOptimizer;
begin
  Result := Source;
  Prog := TPDFContentProgram.Create;
  try
    Prog.CanonicalNumbers := True; // 保存パスと同じ数値処理
    if not Prog.Parse(Source) then
      Exit; // 重大な構造損傷:バイトはそのまま
    Optimizer := TPDFContentPeepholeOptimizer.Create(Prog);
    try
      Optimizer.Run; // 削除した命令数を返す
    finally
      Optimizer.Free;
    end;
    Result := Prog.Emit; // 1行に1命令、#10区切り
  finally
    Prog.Free;
  end;
end;

// 削除される:BT直後のTm、連続する2つのidentity Tmの2番目
//   OptimizeSnippet('BT /F1 12 Tf 1 0 0 1 0 0 Tm (hello) Tj ET')
// 保持される:Tdの後、Tjの後、非identityのTmの後、BTの外側のTm
// OptimizeSnippet('BT (Invoice) Tj 1 0 0 1 0 0 Tm (Total) Tj ET')請求書ストリームをこれに通すと、identityのTmは生き残ります。後方スキャンはBTに届くずっと手前でTjに当たるからです。BTとidentityのTmの間に/F1 12 Tf、2 Tc、0 gを置いても、やはり消えます。どれもテキスト行列に触れないからです。面白いケースはBT 10 20 Td 1 0 0 1 0 0 Tm 1 0 0 1 0 0 Tmです。これは正確に1つの演算子を失います。最初のidentityTmがTdの行った移動を打ち消し、冗長なのは2番目だけです
ParseがFalseを返すのは、終端されていない文字列や辞書のような重大な損傷のときだけです。未知の演算子は問題なくパースされ、プログラムに残り、そこでスキャンの硬い停止として振る舞います
ピーフホールオプティマイザーが実際に走るのはいつか
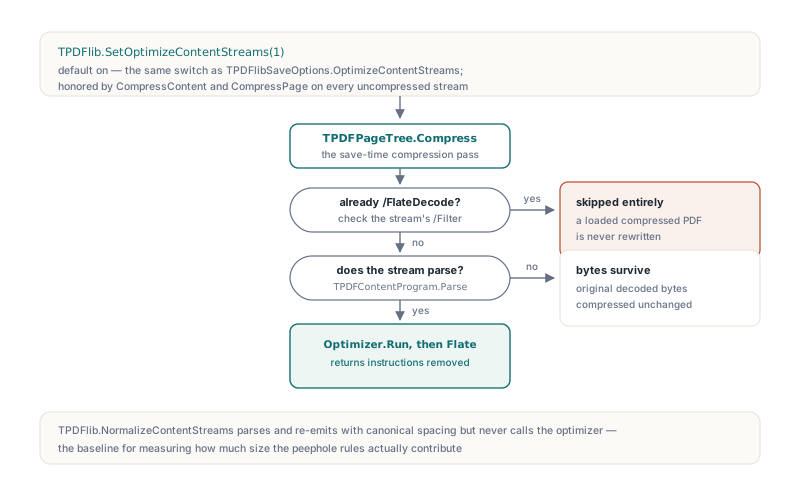
オプティマイザーは圧縮パスの内側だけで、すでにFlate圧縮されていないページコンテンツストリームにだけ走ります。TPDFlib.SetOptimizeContentStreams(1)がデフォルトであり、同じスイッチがTPDFlibSaveOptionsのOptimizeContentStreamsフィールドとして現れます。CompressContentとCompressPageのどちらもこれに従います。/Filterがすでに/FlateDecodeのストリームは完全にスキップされるため、典型的な圧縮済みPDFを読み込んで再保存しても、演算子は元のままであり続けます。非圧縮で保存されたストリームは、復号され、最適化され、それからFlate圧縮されます。ストリームのパースに失敗したとき、元の復号バイトが変更されずに圧縮されます
var
  Lib: TPDFlib;
  Options: TPDFlibSaveOptions;
begin
  Lib := TPDFlib.Create;
  try
    if Lib.LoadFromFile('report.pdf', '') <> 1 then
      Exit;
    // 非圧縮のページストリームはピーフホール規則を通ってからFlateへ
    Lib.SetOptimizeContentStreams(1);
    Lib.CompressContent;
    Lib.SaveToFile('report-optimized.pdf');

    // 同じ選択をバンドルの保存オプションで。Falseでオプトアウト
    Options.CompressContent := True;
    Options.CompressFonts := True;
    Options.CompressImages := True;
    Options.Linearize := False;
    Options.KeepModDate := False;
    Options.OptimizeContentStreams := False;
    Options.GarbageCollect := False;
    Options.PackObjectStreams := True;
    Lib.SaveToFileOptions('report-plain.pdf', Options);
  finally
    Lib.Free;
  end;
end;デフォルトは有効のままにしてください。パス内のすべての変換は出力等価であり、identity行列の規則は、多くのジェネレーターが出すパターン、すべてのテキストオブジェクトをBT 1 0 0 1 0 0 Tmで開くパターンを狙います。オフにする意味があるのは、主として、自分の非圧縮出力を書いたものとdiffしたいとき、あるいはベースラインが要るときです。そのベースラインには、TPDFlib.NormalizeContentStreamsが、正準な間隔と数値で内容をパースして再出力しますが、オプティマイザーは決して呼びません。正規化保存と最適化保存のサイズ差が、ピーフホール規則の寄与分です。フォントサブセット化によるPDFファイルサイズ最適化で述べるより大きな勝ちに比べれば、控えめと見込んでください
1つの形をカバーするテストは規則を定義しない
BT 1 0 0 1 0 0 Tm (hello) Tj ETをオプティマイザーに食わせ、Tmが残らないと主張するテストは、1つの形を固定します。BTの直後のidentityTmは削除される。それはTdの後の、表示テキストの後のidentityTmについては何も語りません。その単一のアサーションを「identityのTmは常に削除可能」と読むのは、簡単で、そして高くつく誤りです。サンプルはどちらに転んでも通るからです。この種の規則のテストには、削除可能な形の隣に、保持される形を書き並べる必要があります
下のヘルパーは生き残るTm演算子を数え、入力の表を検査します。ExpectTmを自分のテストフレームワークのアサーションに差し替えてください。ライブラリの一部ではありません
uses
  SysUtils, PDFlibContentModel, PDFlibContentOps, PDFlibContentOptimize;

function TmCountAfterOptimize(const Source: AnsiString): Integer;
var
  Prog: TPDFContentProgram;
  Optimizer: TPDFContentPeepholeOptimizer;
  I: Integer;
begin
  Result := -1; // -1はパース失敗の合図
  Prog := TPDFContentProgram.Create;
  try
    if not Prog.Parse(Source) then
      Exit;
    Optimizer := TPDFContentPeepholeOptimizer.Create(Prog);
    try
      Optimizer.Run;
    finally
      Optimizer.Free;
    end;
    Result := 0;
    for I := 0 to Prog.Count - 1 do
      if Prog[I].Op = coTextMatrix then
        Inc(Result);
  finally
    Prog.Free;
  end;
end;

// 自前のチェックヘルパー、ここでは提案。本物のアサーションに置き換えること
procedure ExpectTm(const Source: AnsiString; Expected: Integer);
var
  Actual: Integer;
begin
  Actual := TmCountAfterOptimize(Source);
  if Actual <> Expected then
    raise Exception.CreateFmt('%s: expected %d Tm, got %d',
      [string(Source), Expected, Actual]);
end;

procedure CheckIdentityTmRule;
begin
  // 削除可能な形
  ExpectTm('BT /F1 12 Tf 1 0 0 1 0 0 Tm (hello) Tj ET', 0);
  ExpectTm('BT 1 0 0 1 0 0 Tm 1 0 0 1 0 0 Tm (a) Tj ET', 0);
  ExpectTm('BT /F1 12 Tf 2 Tc 0 g 1 0 0 1 0 0 Tm (a) Tj ET', 0);
  // identity Tmを保持しなければならない形
  ExpectTm('BT (Invoice) Tj 1 0 0 1 0 0 Tm (Total) Tj ET', 1);
  ExpectTm('BT 10 20 Td 1 0 0 1 0 0 Tm 1 0 0 1 0 0 Tm (a) Tj ET', 1);
  ExpectTm('BT 2 0 0 2 5 5 Tm (a) Tj 1 0 0 1 0 0 Tm (b) Tj ET', 2);
  ExpectTm('1 0 0 1 0 0 Tm (a) Tj', 1);    // 囲むBTがない
  ExpectTm('BT ET 1 0 0 1 0 0 Tm', 1);     // ETの後
end;最後の2行は、層状の/Contents配列がまさにその断片を作ると思い出すまで、馬鹿げて見えます。テキストオブジェクトの途中で始まるストリームにはBTがなく、ETの後のidentityTmはどのテキストオブジェクトにも属しません。両方とも残ります。最終行の空のBT ETペアは空テキストオブジェクトの規則で取り除かれるため、カウントは文字列全体を比較する代わりにTm演算子を検査するのです
この規則が手放すのは、テキストオブジェクトの途中のたまのidentityTm、Flateが目を付ける前のページあたり数バイトです。買うのは、オプティマイザーの設計が載っている保証です。パス内の変換は、見えるページを変えない。テキストを動かすサイズ最適化器は、良い圧縮率を持つ描画バグです
DelphiやC++BuilderでPDFコンテンツを生成または後処理するなら、DelphiとC++Builder向けPDF Library for Delphiが、コンテンツストリームパーサー、このピーフホールパス、上に示した保存オプションとともに、比較相手のためのきれいな非最適化ベースラインを作るNormalizeContentStreamsを出荷しています