FDF 注釈インポーターは、パースしたエントリ数を返しながら、1つも文書に追加しないことがありえます。数えたのはすべて、落としたのもすべて。TPDFlib.ImportAnnotationsFromFDFStringは losLab PDF Library のもので、キーをどんな順序でも読み、/Rectを正しく、ロケールに依存せずにパースし、実際に追加された注釈の数を返します。対応するエクスポーターは注釈の本物の/Rectを書くので、エクスポート、インポート、再エクスポートはバイト単位で同じ FDF になります。このノートの残りでは、1つの間違った開始オフセットがどう完璧な無言失敗を生むか、その背後にどんな3つの罠が隠れているか、そして戻り値を信用する代わりに自分でインポートをどう検証するかを説明します
シナリオはありふれたものです。レビュアーが契約書に注釈を付け、コメントは FDF ファイル(Acrobat では Export Comments)として旅をし、Delphi のサービスが FDF インポート呼び出しできれいなコピーへマージします。呼び出しは 7 を返し、ログは「7 comments imported」と言い、ジョブは緑になり、出力 PDF にはコメントがまったくありません。例外も警告もなく、その数はもっともらしく見えます。ファイル内のエントリの本当の数だったからです。バグが取り得る最悪の形です。成功の唯一のシグナルが、報告対象の仕事とは独立に計算されたカウンターである関数の話です
FDFインポートが成功を報告しながら何も追加しないことがあるのはなぜか?
理由は、名前リーダーは間違った場所から始め得るし、カウンターは仕事をするコードの外に住めます。/Subtypeの直後の位置を返すキーファインダーは、値の前の空白の上に着地します。その空白から始まって最初の空白文字で止まるReadNameは、何も読まずに止まり、すべての subtype は空で返ります。subtype なしでは注釈を組み立てないAddAnnotationToPageのようなヘルパーは、それ単独では正しい防御的選択です。しかし戻り値のない procedure で、呼び出し側のInc(Result)がその外に座っていると、2つのガードが揃って「何も動かなかった」を「すべて動いた」に変換します。正しい名前リーダーは空白をスキップし、PDF 名前オブジェクトの先頭の/を要求し、[、(、)を含む任意のデリミタで止まります。したがって/Subtype/Textも/Subtype /TextもTextを得ます。losLab PDF Library が名前を読むやり方はこうです
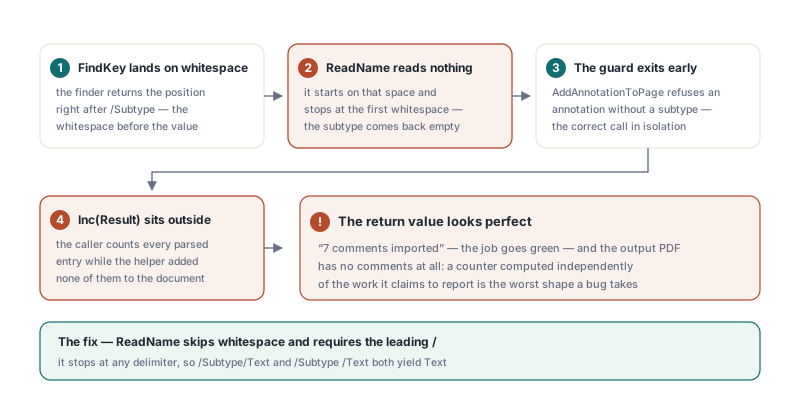
戻り値はそれ以上の手当てにも値します。/Annots配列の整形式辞書ごとに増えるインポーターは、範囲外の0ベースの/Pageを持つエントリや/Subtypeを欠くエントリ、どちらもスキップされるものがあると、それでも過大報告します。losLab PDF Library では、ImportAnnotationsFromFDFStringとImportAnnotationsFromFDFは、XFDF インポートと同じく、実際に追加された注釈の数を返します。FDF のヘルパーAddAnnotationToPageは Boolean を返し、カウンターは成功のときだけ動きます。それでも文書を測るほうが強いチェックです。その数字を出したコードがどれであっても成り立つからです。したがって下のスケッチは、インポートの前後で各ページのAnnotationCountを比べます
function TotalAnnotations(Lib: TPDFlib): Integer;
var
  Page, Saved: Integer;
begin
  Result := 0;
  Saved := Lib.SelectedPage;
  for Page := 1 to Lib.PageCount do
    if Lib.SelectPage(Page) = 1 then
      Inc(Result, Lib.AnnotationCount);   // 選択中のページごと。ウィジェットも含む
  Lib.SelectPage(Saved);
end;

var
  Lib: TPDFlib;
  Before, Reported, Added: Integer;
begin
  Lib := TPDFlib.Create;
  try
    Lib.LoadFromFile('contract.pdf', '');
    Before := TotalAnnotations(Lib);
    Reported := Lib.ImportAnnotationsFromFDF('review-comments.fdf');
    Added := TotalAnnotations(Lib) - Before;
    if Added <> Reported then   // すべてのエントリがページに着地したとき等しくなる
      Writeln(Format('Importer reported %d, %d landed on a page', [Reported, Added]));
    Lib.SaveToFile('contract-reviewed.pdf');
  finally
    Lib.Free;
  end;
end;
最初の罠の背後にある3つの罠
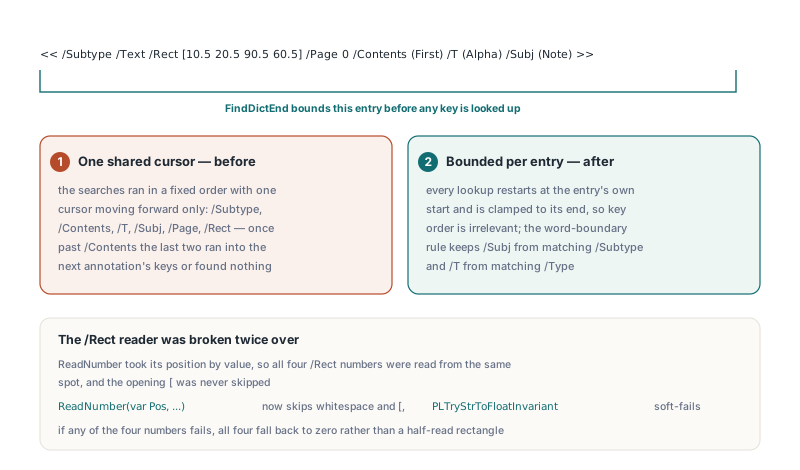
subtype だけを直すと、同じ種類のパーサに3つの罠がさらに姿を現します。注釈が1つもページに届かない限り、どれも見えません。第一に、位置を値パラメータとして受けるReadNumberは、4つの/Rect数値を続けて処理するとき同じ場所を4回読み、先頭の[をスキップしなければ、実際には何も読みません。第二に、すべてのルックアップで1つの前進カーソルを共有するFindKeyは、キー順序に依存します。エクスポーターは/Subtype、/Rect、/Page、/Contents、/T、/Subjの順で書くのに、インポーターは/Subtype、/Contents、/T、/Subj、/Page、/Rectの順で探す、ということがありえます。カーソルが/Contentsを通り過ぎた後、/Pageと/Rectの検索は現在のエントリを越えて走り、何も見つけないか、次の注釈のキーに一致します。インポーターは、自分自身のエクスポーターの出力すら読めません。第三に、システムの小数点区切りに従うPLStrToFloatのようなルーチンを通してパースされた数値は、カンマロケールのマシンで壊れます。ISO 32000-1 §12.7.7 は FDF を PDF オブジェクト構文と定義し、PDF の辞書キーは順序なし(§7.3.7)なので、キー順序を仮定する FDF パーサは、どのツールがファイルを出したかにかかわらず、構成上間違っています
losLab PDF Library はまず各エントリに境界を引きます。FindDictEndは開きの<<から対応する>>まで歩き、ネストした辞書を追跡し、バックスラッシュエスケープ込みでリテラル文字列の本体をスキップします。したがって(see section >> 4)のようなコメントの中の>>は、エントリを早く終わらせられません。すべてのキー検索はエントリ自身の開始から始まり、その終わりに制限されるので、キー順序は無関係になり、1つの注釈が別の注釈の/Pageを借りることも止まります。キー照合は名前の直後のデリミタも受け入れます。/Contents(Hi)は/Contents (Hi)と同じく有効だからです。一方、単語境界の規則が、/Subjが/Subtypeの先頭に一致すること、/Tが/Typeに一致することを防ぎます。ReadNumberは位置をvarパラメータとして受け、空白と[をスキップし、PLTryStrToFloatInvariantでパースします。これは不正なトークンで例外を投げる代わりにソフトに失敗します。4つの矩形数値のどれかが失敗したら、4つすべてがゼロへフォールバックし、半分だけ読んだ矩形は出しません
FDFのラウンドトリップが注釈を自分の高さぶんずらすことがあるのはなぜか?
理由は、矩形を間違った座標モデルで書くのが容易だからです。注釈の/Rectはデフォルトユーザー空間での[llx lly urx ury](ISO 32000-1 §12.5.2、矩形は §7.9.5 で定義)であり、FDF は同じ配列を運びます。しかしGetAnnotRectExが報告するのは、ライブラリの描画座標、つまりSetOriginが支配する空間での Left、Top、Width、Height です。それらを[L T L+W T+H]として直列化するエクスポーターは、インポーターに4つの値を渡し、それを PDF 矩形としてそのまま書き戻すと、上端が左下隅のあるべき場所に来ます。つまりラウンドトリップごとに、注釈は自分の高さぶん上へ動きます。losLab PDF Library のエクスポーターは注釈自身の/Rect数値を、小数3桁、ドット区切り、指数なしでコピーし、保存された配列がないか4つの数値でないときにだけ、計算した矩形へフォールバックします
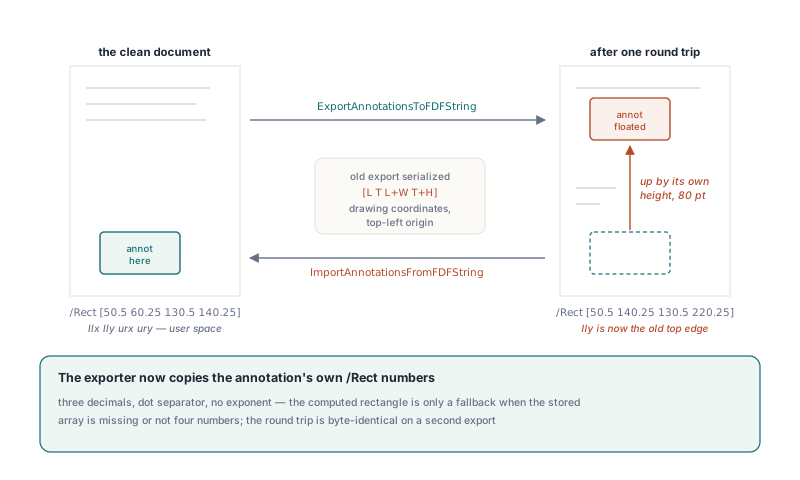
真似する価値のあるラウンドトリップテストは、インポーターの戻り値ではなく、文書と2回目のエクスポートについて assert します。期待数 2 に注意してください。AddNoteAnnotationは Text 注釈とその Popup を作り、両方が旅をします。テストはさらに、エクスポートとインポートをカンマ小数点区切りで走らせます。この話の残りの半分が住んでいるのはそこです
var
  Source, Target: TPDFlib;
  FDF: AnsiString;
  OldSep: Char;
begin
  Source := TPDFlib.Create;
  Target := TPDFlib.Create;
  try
    Source.NewPages(1);                     // これで2ページになる
    Source.SelectPage(2);
    Source.AddNoteAnnotation(50.5, 60.25, 0, 80, 80, 120, 60,
      'Reviewer', 'Check this', 0.25, 0.5, 0.75, 0);
    Target.NewPages(1);

    OldSep := FormatSettings.DecimalSeparator;
    FormatSettings.DecimalSeparator := ',';   // ドイツ語やフランス語のデスクトップをシミュレート
    try
      FDF := Source.ExportAnnotationsToFDFString;   // それでも/Rect [50.5 ... と書く
      Target.ImportAnnotationsFromFDFString(FDF);
    finally
      FormatSettings.DecimalSeparator := OldSep;
    end;

    Target.SelectPage(2);
    Assert(Target.AnnotationCount = 2);           // 注釈とそのポップアップ
    Assert(Target.GetAnnotType(1) = 'Text');
    Assert(Target.ExportAnnotationsToFDFString = Source.ExportAnnotationsToFDFString);
  finally
    Target.Free;
    Source.Free;
  end;
end;
FDF 経路は注釈のコア辞書を中心に組み立てられています。インポーターは各エントリを/Type、/Subtype、/Rect、/Contents、/T、/Subjで組み立て直し、エクスポーターはWidget注釈をフォームフィールドの属するフォームデータメソッドへ委ねます。色、フラグ、罫線スタイル、ポップアップリンク、外観ストリームのために FDF に頼る前に、どのデータがどのメソッドを通って旅するかのより広い地図を、FDF、XFDF、XFA フォームデータ交換の概要で確認してください。実際に届いたものを検査する必要があるなら、GetAnnotType、GetAnnotTitle、GetAnnotContentsExのような添字付きリーダーは、outline、annotation、action イントロスペクションで扱っています
カンマ小数のFDF・XFDFファイルはどう読むのか?
FDF については答えがはっきりしています。カンマは PDF 構文ではデリミタではないので、カンマをちょうど1つ含みドットを含まない数値トークンは、カンマロケールのマシンで書かれた小数でしかあり得ません。そういうファイルは実在します。たとえば、システムロケールで数値を整形したエクスポーターからの/Rect [10,500 20,250 40,750 60,125]です。ReadNumberはパースの前にその単一カンマをドットに変えます。カンマ2つ、またはカンマとドットを持つトークンは、推測ではなく拒否されます。リーダーは指数表記も消費しません。ISO 32000-1 §7.3.3 に一致する振る舞いです。PDF の数値は指数を使いません
XFDF はもっと難しいです。XML 属性ではカンマがセパレータだからです。標準の XFDF(ISO 19444-1)はrect="50.5,80.25,70.75,100.125"やdashes="4,2"と書き、カンマロケールのシステム上のロケール依存ライターはrect="50,500 80,250 70,750 100,125"やopacity="0,600"を出力します。losLab PDF Library は XFDF 数値を双方向で不変に読み書きし、レガシーの形は、属性が空白で分割してちょうど期待された個数のトークンになる(rectは4個、opacityとwidthは1個)とき、かつすべてのトークンが数字-カンマ-数字の形のときに限り、XFDFNormalizeLegacyDecimalsで認識します。標準の rect は決して一致しません。カンマ3つの1トークンか、カンマで終わるトークンです。dashesは意図的にそのままにされます。4,2は2つのダッシュ長かもしれず、レガシーの 4.2 かもしれず、区別する規則は書けないからです
const
  // エクスポーター順と違うキー順、さらにカンマロケール出力由来のカンマ小数
  LegacyFDF: AnsiString = '%FDF-1.2'#10'1 0 obj'#10'<< /FDF << /Annots ['#10 +
    '<< /Rect [10,500 20,250 40,750 60,125] /Page 0 /Contents (First) ' +
    '/Subtype /Text /T (Alpha) /Type /Annot >>'#10 +
    '] >> >>'#10'endobj'#10'trailer'#10'<< /Root 1 0 R >>'#10'%%EOF'#10;
var
  Lib: TPDFlib;
begin
  Lib := TPDFlib.Create;               // 新鮮な文書には1ページある
  try
    Lib.ImportAnnotationsFromFDFString(LegacyFDF);
    Assert(Lib.AnnotationCount = 1);
    Assert(Lib.GetAnnotTitle(1) = 'Alpha');
    // ドット小数の XFDF として再エクスポート:rect="10.500 20.250 40.750 60.125"
    Writeln(Lib.ExportAnnotationsToXFDFString);
  finally
    Lib.Free;
  end;
end;
注釈インポートのテストは何をアサートすべきか
有用なインポートテストは、ターゲット文書の状態について assert し、インポーターが自分について言うことだけを assert することは決してありません。無言ゼロの失敗では、戻り値こそが無傷で残る唯一の数字です。ここで述べたすべての罠は3つの assert で捉えられます。期待ページの注釈数、GetAnnotTypeやGetAnnotContentsExで読み戻す1つのフィールド、そして1回目とバイト単位で比べる2回目のエクスポートです。同じ規律は、文書構造を一括で書き換えるどんな API にも当てはまります。重複フォームフィールドのマージで述べたフィールド統合を含めてです。返された合計ではなく、結果の木を調べてください。FDF と XFDF の注釈メソッドは、ファイル版と文字列版とともに、losLab PDF Library for Delphi and C++Builderに搭載されています