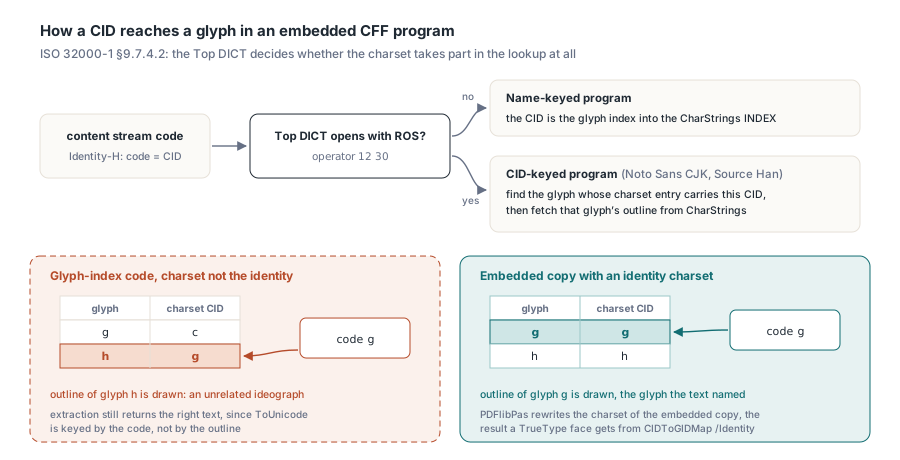
.otf ファイルから Noto Sans SC で組んだ中国語の請求書を mutool で開くと、顧客名があるべき位置に無関係な漢字が出てくることがあります。同じページでも TrueType フォントなら正しく描けます。原因はフォントの CFF charset です。PDFlibPas は埋め込みコピーの charset を identity に書き換えるので、glyph-index コードがそのまま狙いのグリフに届きます
フォントによってこの問題が出るか出ないかは、作られ方次第です。CIDFontType2 フォントとして埋め込まれた TrueType プログラムには CIDToGIDMap として Identity が与えられ、content stream のコードはそのまま狙いのグリフに着地します。CFF アウトラインを持つ大半の欧文 OpenType フォントは name-keyed で、name-keyed の CFF プログラムは入ってきた CID をそのまま glyph index として使います。ISO 32000-1 の §9.7.4.2 ですら「多くのフォントでは CID と GID が一致する」と但し書きを添えるほどです。ただし全部ではありません。CID-keyed フォントとして作られた大型 CJK ファミリー(Noto Sans CJK とその Source Han シリーズなど)は独自の CID 番号を持っていて、glyph index をその番号空間へ直送する writer は、一致する CID を持つどんなグリフでも引っ張ってきます
CID-keyed CFF プログラムは CID をどう扱うか
ISO 32000-1 の §9.7.4.2 は、Top DICT を見て埋め込み CFF プログラムを 2 つのケースに振り分けます。Top DICT が CIDFont オペレータを使う——実際には ROS(オペレータ 12 30:registry、ordering、supplement)で始まる——なら、リーダーは content stream から CID を取り出し、その CID を charset エントリに持つグリフを探し、それから CharStrings INDEX へアウトラインを取りに行きます。CIDFont オペレータがなければ、CID がそのまま glyph index で、charset は出番なし。したがって §9.7.4.2 の文章どおりに従うリーダーは、charset が identity でない限り、どのビューアに切り替えても glyph-index コードに誤ったグリフを描くことになります。Adobe Technical Note #5176 で定義される charset 自体は、3 つのレイアウトと 2 つの特殊ケースから成ります:
- format 0 はグリフごとに 2 バイトの SID または CID を glyph 順に 1 つずつ格納します
- format 1 は範囲で格納します。先頭の CID に、それに続く連番 CID のグリフ数を 1 バイトで置いたものです
- format 2 は同じ範囲レイアウトでカウントだけ 2 バイトになり、長い連なりを持つフォントに向いています
- グリフ 0 は
.notdefで、どの format にもエントリを持ちません。0、1、2 の charset オフセットはデータを指す代わりに定義済み charset の 1 つを名指します
まず手持ちのフォントがどの種類かを見分けるところから始めましょう。PDF 側の Identity-H が語るのは「2 バイトのコードが CID と等しい」ことだけです。その CID がどうグリフへ届くかは、すべてフォントプログラムの中にあります。下の関数は .otf から CFF テーブルを読み出し、Top DICT を ROS のためにたどり、charset がすべてのグリフを同番号の CID へ写しているかを確かめます。必要なのは RTL だけです
uses
  System.SysUtils, System.IOUtils;

type
  TCFFCharsetReport = record
    IsCFF, CIDKeyed, IdentityCharset: Boolean;
    CharsetFormat, GlyphCount: Integer;
  end;

{$RANGECHECKS ON}  // 切り詰められたファイルは誤読ではなく ERangeError を上げる
function InspectOtfCharset(const FileName: string): TCFFCharsetReport;
var
  B: TBytes;
  NumTables, I, Cff, P, Dict, DictEnd, Unused1, Unused2: Integer;
  Op, Operand, CharsetOfs, CharStringsOfs, G, Left: Integer;

  function BE(Pos, Count: Integer): Integer;
  var
    K: Integer;
  begin
    Result := 0;
    for K := 0 to Count - 1 do
      Result := (Result shl 8) or B[Pos + K];
  end;

  // Pos の INDEX の終端を返し、その最初のオブジェクトの範囲を取る
  function SkipIndex(Pos: Integer; out ObjStart, ObjEnd: Integer): Integer;
  var
    Count, OffSize, Base: Integer;
  begin
    Count := BE(Pos, 2);
    if Count = 0 then
    begin
      ObjStart := Pos + 2;
      ObjEnd := ObjStart;
      Exit(Pos + 2);
    end;
    OffSize := B[Pos + 2];
    Base := Pos + 2 + (Count + 1) * OffSize;  // オフセットはここから 1 始まり
    ObjStart := Base + BE(Pos + 3, OffSize);
    ObjEnd := Base + BE(Pos + 3 + OffSize, OffSize);
    Result := Base + BE(Pos + 3 + Count * OffSize, OffSize);
  end;

begin
  Result := Default(TCFFCharsetReport);
  Result.CharsetFormat := -1;
  B := TFile.ReadAllBytes(FileName);
  if (Length(B) < 12) or (BE(0, 4) <> $4F54544F) then  // 'OTTO'
    Exit;
  Cff := -1;
  NumTables := BE(4, 2);
  for I := 0 to NumTables - 1 do
    if BE(12 + I * 16, 4) = $43464620 then               // 'CFF '
      Cff := BE(12 + I * 16 + 8, 4);
  if Cff < 0 then
    Exit;
  Result.IsCFF := True;
  P := SkipIndex(Cff + B[Cff + 2], Unused1, Unused2);    // Name INDEX
  SkipIndex(P, Dict, DictEnd);                           // Top DICT INDEX
  Operand := 0;
  CharsetOfs := 0;
  CharStringsOfs := 0;
  P := Dict;
  while P < DictEnd do
  begin
    Op := B[P];
    case Op of
      12:
        begin
          if B[P + 1] = 30 then
            Result.CIDKeyed := True;                     // ROS
          Inc(P, 2);
        end;
      0..11, 13..21:
        begin
          if Op = 15 then
            CharsetOfs := Operand
          else if Op = 17 then
            CharStringsOfs := Operand;
          Inc(P);
        end;
      28: begin Operand := SmallInt(BE(P + 1, 2)); Inc(P, 3); end;
      29: begin Operand := BE(P + 1, 4); Inc(P, 5); end;
      30:
        begin                                            // 実数
          repeat
            Inc(P);
          until ((B[P] and $F) = $F) or ((B[P] shr 4) = $F);
          Inc(P);
        end;
      32..246: begin Operand := Op - 139; Inc(P); end;
      247..250: begin Operand := (Op - 247) * 256 + B[P + 1] + 108; Inc(P, 2); end;
      251..254: begin Operand := -(Op - 251) * 256 - B[P + 1] - 108; Inc(P, 2); end;
    else
      Exit;                                              // 予約バイト
    end;
  end;
  if (not Result.CIDKeyed) or (CharsetOfs <= 2) or (CharStringsOfs <= 0) then
    Exit;
  Result.GlyphCount := BE(Cff + CharStringsOfs, 2);
  P := Cff + CharsetOfs;
  Result.CharsetFormat := B[P];
  if Result.CharsetFormat > 2 then
    Exit;
  Inc(P);
  Result.IdentityCharset := True;
  G := 1;                                                // .notdef にエントリはない
  while G < Result.GlyphCount do
  begin
    if BE(P, 2) <> G then
      Result.IdentityCharset := False;
    case Result.CharsetFormat of
      0: Left := 0;
      1: Left := B[P + 2];
    else
      Left := BE(P + 2, 2);
    end;
    Inc(P, Result.CharsetFormat + 2);
    Inc(G, Left + 1);
  end;
end;
CIDKeyed = True かつ IdentityCharset = False という結果は、まさにこの記事の主題であるフォントを示します。その charset を織り込まずに glyph index を content stream に書き込む writer はどれも、このフォントで誤ったグリフを描きます。name-keyed という結果、あるいは charset がたまたま identity になっている CID-keyed フォントなら、同じ writer で正しく描けます。製品に入れた 1 つ目の CJK フォントは動くのに 2 つ目が動かない、というのはこうして起こります。ループが比較するのは各範囲の先頭 CID だけです。それで足ります。範囲は連番 CID を持つ連続グリフを覆うので、自分の glyph index から始まった範囲は最後までその上を歩きます
glyph index はフォント辞書の全体を巡る
PDF writer の手元に CID が揃っていることはまれです。cmap テーブルも shaping エンジンも glyph index を返してくるので、素直な設計では、それを 2 バイトの Identity-H コードとして書き込み、残りのすべてをその番号に紐付けます。/W の幅配列、PDF/A が求める /CIDSet ビットマップ、抽出で原文を復元できるようにする ToUnicode CMap がその対象です。TrueType には逃げ道があります。Table 117 は CIDToGIDMap を用意していますが、対象は Type 2 CIDFont だけ。CFF プログラムは CIDFontType0 フォントに住んでいて、PDF 側から CID を付け替える手段を持ちません。これは、TrueType で使われる手——フォント終端の先に再利用グリフへ 2 つ目の「エイリアス」CID を与え、使うごとに ToUnicode で別テキストを貼る——までを塞ぎます。CFF フォントではそのエイリアスが選ぶグリフはなく、mutool は描けないと報告します。U+4E00 と U+2F00(KANGXI RADICAL ONE)を 1 つのアウトラインに束ねるフォントはよくあるケースです。2 つを別々の文字として抽出したいなら、該当箇所を /ActualText(ISO 32000-1 §14.9.4)付きの marked-content スパンで包みましょう。リーダーはフォントの写像の代わりにこれを使います
charset をその場で書き換える
glyph-index コードと CID-keyed プログラムを和解させる道は 2 つあります。1 つは書き込む前にすべての glyph index をフォントの CID へ翻訳する方法で、content stream のコード、/W のキー、/CIDSet のビット位置、ToUnicode の元コード、保存時の全サブセットに手が及びます。もう 1 つは、食い違っている唯一の構造である charset を変更し、name-keyed プログラムと同じ応えをフォントが glyph index に返すようにする方法です。安全なのは 2 つ目です。shaper、幅テーブル、サブセット化、ToUnicode 構築はどれも glyph 空間で働き続け、CID を理解しなければならないコードは、フォントの埋め込みコピーに 1 回だけ走る短いルーチン 1 本に減ります。PDFlibPas はこの道を選んでいます
書き換えは charset の format とバイト長を保ったまま行われます。format 0 では各エントリをそのグリフ自身の glyph index で上書きし、format 1 と 2 では各範囲の先頭 CID だけが変わってカウントはそのまま。伸びる要素も縮む要素もありません。CharStrings、Private DICT、FDArray、FDSelect への Top DICT オフセットは何も再エンコードせずに有効なままですし、glyph index ごとにヒンティング辞書を割り当てる FDSelect は、全グリフを元の FD に留めます。name-keyed プログラム、定義済み charset、CFF2 テーブル(charset を持たない)、パースできないプログラムは触られません。この書き換えを走らせるのは 3 つのコードパスです:
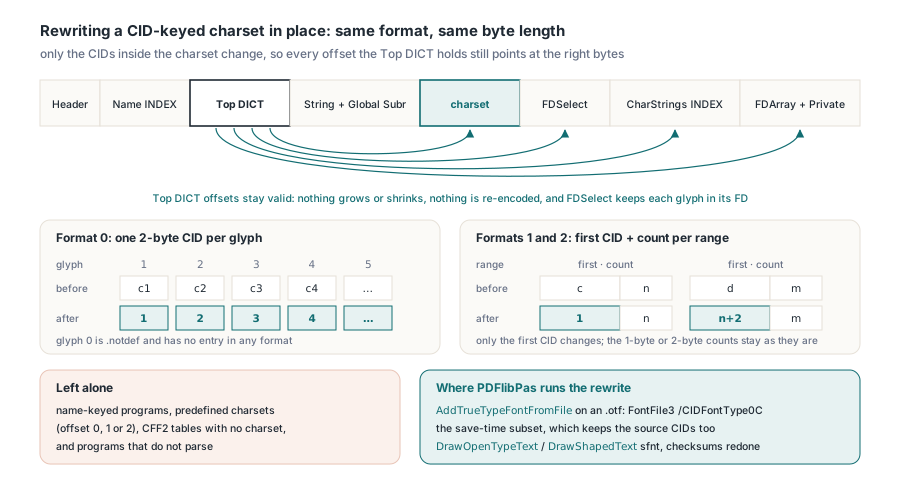
.otfに対するAddTrueTypeFontFromFileは、素のCFFテーブルをサブタイプCIDFontType0CのFontFile3として埋め込み、charset は書き換え済みにします- 保存時のサブセットは元の glyph index を保ちつつ元の CID も抱え込むので、その charset は 2 度目の書き換えを受けます
DrawOpenTypeTextとDrawShapedTextの背後にある shaping 用コンパニオンは sfnt 全体を保持し、書き換えの後でCFFテーブルのチェックサムが再計算され、headテーブルのcheckSumAdjustmentは0xB1B0AFBAからファイル全体の総和を引いた値になります- この調整値は単一フォント用に定義されているので、コレクションから取り出したフェイスはテーブルのチェックサムだけを持ちます
uses
  SysUtils, PDFlibrary;

var
  Lib: TPDFlib;
  FontID: Integer;
begin
  Lib := TPDFlib.Create;
  try
    // CFF 系の .otf は FontFile3 /CIDFontType0C として埋め込まれ、
    // CID-keyed なら埋め込みコピーは identity charset を受け取る
    FontID := Lib.AddTrueTypeFontFromFile('C:\Fonts\NotoSansSC-Regular.otf');
    if FontID = 0 then
      raise Exception.Create('the font file could not be read or parsed');
    Lib.SetTextSize(18);
    Lib.DrawText(56, 760, '季度报表:华东区销售汇总');
    Lib.DrawText(56, 730, '发票号码 2026-11-0187,金额 ¥12,480.00');
    if Lib.SaveToFile('noto-sc.pdf') <> 1 then
      raise Exception.CreateFmt('save failed, error %d', [Lib.LastErrorCode]);
  finally
    Lib.Free;
  end;
end;出力の確認は描画で行います。抽出では問題が見えません。pdftotext をはじめ抽出器はどれも ToUnicode を読みます。それは content stream のコードをキーにしていて、フォントがそのコードにどのアウトラインを当てるかは知らないので、誤った漢字を表示しているページでも正しい文字列が抽出されます。mutool draw -r 150 -o page%d.png noto-sc.pdf がページの実際の姿を見せてくれます。この DrawText パスなら、poppler の pdffonts noto-sc.pdf がフォントを CID Type 0C と一覧するはずです。期待される結果は、2 行とも Noto Sans SC で原文の示すグリフが並ぶことで、Ghostscript でも同じ出力になります
どの埋め込み形態が PDF 1.6 を必要とするか
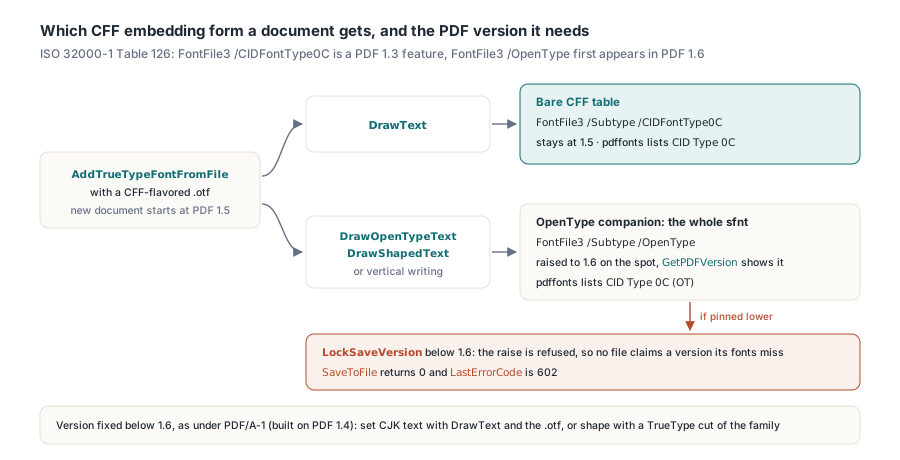
OpenType のほうです。ISO 32000-1 の Table 126 はサブタイプ CIDFontType0C の FontFile3 ストリームを PDF 1.3 の機能として載せていますが、サブタイプ OpenType——CFF テーブルを含む sfnt 全体——は PDF 1.6 で初めて登場します。新しい PDFlibPas 文書はバージョン 1.5 から始まり、素の CFF を使う DrawText パスはこの中に収まります。CFF フェイスでの最初の DrawOpenTypeText、DrawShapedText、縦書き呼び出しが OpenType コンパニオンを作り、その場で文書を 1.6 に引き上げます。GetPDFVersion は即座にそれを報告します。バージョンロックがあると話は変わります。LockSaveVersion が文書をそれより低く固定している場合、引き上げは拒まれ、SaveToFile は 0 を返して LastErrorCode が 602 になります。フォントが満たせないバージョンを名乗るファイルは出ない仕掛けです。納品プロファイルがバージョンを 1.6 未満に固定する場合(PDF 1.4 を土台にする PDF/A-1 が典型です)は、CJK テキストを .otf の DrawText で組むか、shaping が必要な箇所には同ファミリーの TrueType 版を使いましょう
var
  Lib: TPDFlib;
  FontID: Integer;
begin
  Lib := TPDFlib.Create;
  try
    FontID := Lib.AddTrueTypeFontFromFile('NotoSansSC-Regular.otf');
    Writeln('before: ', Lib.GetPDFVersion);      // 期待値: 1.5
    if Lib.DrawOpenTypeText(56, 760, FontID, 18, '《年度报告》第三章', 0) = 1 then
      Writeln('after: ', Lib.GetPDFVersion);     // 期待値: 1.6
    Lib.SaveToFile('shaped.pdf');  // pdffonts での期待値: CID Type 0C (OT)
  finally
    Lib.Free;
  end;

  Lib := TPDFlib.Create;
  try
    Lib.LockSaveVersion('1.5');
    FontID := Lib.AddTrueTypeFontFromFile('NotoSansSC-Regular.otf');
    Lib.DrawOpenTypeText(56, 760, FontID, 18, '《年度报告》第三章', 0);
    if Lib.SaveToFile('locked.pdf') = 0 then
      Writeln('save refused, error ', Lib.LastErrorCode);  // 期待値: 602
  finally
    Lib.Free;
  end;
end;
同じ番号に紐付く幅と ToUnicode
charset が identity になれば、CID と glyph index と content stream コードは 1 つの番号に束ねられ、幅もそれに従います。ISO 32000-1 の §9.7.4.3 は /W を CID そのもので索引付けします。開始 CID に幅の配列を続ける形か、最初の CID、最後の CID、共有幅 1 つの形のグループで、simple font が使う種類の /FirstChar オフセットはありません。配列が置いていった CID は /DW を引き、Table 117 は /DW の既定値を 1000 に定めています。0 では困ります。リスト外の CID に 0 でフォールバックするリーダーは、漢字の 1 行を 1 点に折り畳みます。AddTrueTypeFontFromFile で読み込んだ .otf には、PDFlibPas が CID 0 から始めて全グリフの送り幅を並べる /W 配列を、明示的な /DW 1000 と並べて書き込みます。読み手側では、文字化けして抽出される CJK テキストの不具合はたいてい同じパイプラインの codespace 側で起き、幅、CharSet、CIDSet の PDF/UA フォント監査がこれらの配列を埋め込みプログラムと突き合わせてくれます
ToUnicode には自分専用の番号規則があります。bfrange エントリが保存するのは宛先文字列の最初の 1 個だけで、§9.10.3 は範囲の長さによって最終バイトが 255 を超えないことを求めます。リーダーはその最終バイトだけを 1 ずつ進めて後続の宛先を生成するからです。連続するグリフが U+4EFE、U+4EFF、U+4F00、U+4F01 へ写るなら 1 つの範囲に見えます。そうではありません。3 番目をリーダーは U+4E00 と解読します。PDFlibPas の writer が隣接する glyph-to-Unicode の組を 1 つの bfrange に統合するのは、元コードと宛先が 256 の 1 ブロック内に収まるときだけで、それ以外は連なりを分割します。CJK 縦書きは同じコンパニオンフォントを通るので、縦書きの日本語・中国語テキストも追加呼び出しなしに identity charset とこの ToUnicode 範囲を受け継ぎます
InspectOtfCharset が CID-keyed かつ非 identity の charset と報告したフェイスはすべて、glyph-index コードとフォントが食い違うフェイスです。Delphi 用 PDFlibPas から埋め込まれれば、アウトラインもオフセットも charset 長もそのまま何も変わらず、変わるのはあの 1 つのテーブルの中の CID、sfnt 全体を保持するときはそのチェックサムだけです