Una ricerca di "two-x" in un PDF appena generato può tornare con zero risultati mentre la pagina mostra ben visibili quei cinque caratteri. Fate il dump della stringa estratta come code point e il motivo è lì davanti: il trattino è tornato come U+00AD SOFT HYPHEN, e lo spazio dopo come U+00A0 NO-BREAK SPACE. Entrambi appaiono identici sullo schermo. La differenza vive nella CMap ToUnicode, la tabella che un reader consulta per riconvertire i codici carattere in Unicode, e nasce da un glifo del font condiviso da due code point
Gli strumenti stringa ordinari peggiorano la discrepanza. Un export CSV spezza la riga in modo diverso, uno strumento di diff segnala due righe che si leggono uguali in ogni viewer, e un correttore ortografico tratta "two-x" con un soft hyphen come parola sconosciuta. La normalizzazione Unicode vi soccorre solo a metà: NFKC ripiega U+00A0 in uno spazio ordinario perché NBSP porta una decomposizione di compatibilità, ma U+00AD non ha nessuna decomposizione, quindi il soft hyphen sopravvive a ogni forma di normalizzazione
Perché gli spazi estratti tornano come U+00A0?
Gli spazi estratti diventano U+00A0 quando la CMap ToUnicode è indicizzata per glifo e un glifo può essere raggiunto da due code point. In Arial, il glifo 3 serve sia U+0020 sia U+00A0, e il glifo del trattino serve sia U+002D sia U+00AD. Una CMap costruita dal lato dei glifi deve dire qualcosa sul CID 0003, e il generatore di PDFium in FPDFText_LoadFont finisce per dire due cose: una voce bfchar che lo mappa a U+0020, e un bfrange in forma di array che mappa lo stesso CID a U+00A0
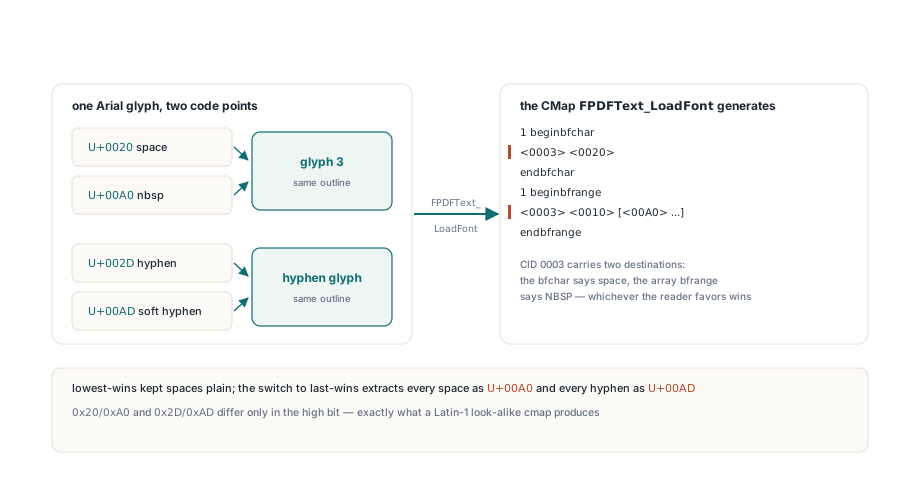
1 beginbfchar
<0003> <0020>
endbfchar
1 beginbfrange
<0003> <0010> [<00A0> ...]
endbfrange
ISO 32000-1 §9.10.3 descrive come bfchar e bfrange mappano codici a Unicode, ma non dice quale voce vinca quando due di loro rivendicano lo stesso CID. I reader si scelgono una regola di precedenza propria. Un reader che conserva la mappatura più bassa o la prima estrae uno spazio normale; il reader di PDFium conserva l'ultima, e dato che il range in forma di array segue il blocco bfchar, ogni spazio scritto attraverso una CMap indicizzata per glifo si estrae come NBSP e ogni trattino come soft hyphen. Lo stesso testo può quindi estrarsi diversamente in due viewer dello stesso file
Le coppie seguono un pattern. 0x20/0xA0 e 0x2D/0xAD differiscono solo nel bit alto, che è ciò che produce un font la cui cmap manda i sosia Latin-1 al contorno già usato per il carattere ASCII. Anche l'Omega maiuscolo greco (U+03A9) e il simbolo Ohm (U+2126) condividono un glifo in Arial. Se un codice di estrazione che passava ora fallisce su caratteri che non riuscite a vedere, stampate i code point invece di fidarvi della vista stringa del debugger; le basi della lettura del testo da una pagina stanno in estrazione del testo dai documenti PDF con PDFium in Delphi
Come PDFium Component indicizza i font di sistema per code point
PDFium Component non chiede mai all'engine di generare quella CMap per i font di sistema che portano una cmap Unicode. Quando TPdf.AddText ha bisogno di un font, il componente legge la tabella sfnt cmap del font stesso, preferendo una sottotabella formato 12 e ricadendo sul formato 4. I code point tornano ordinati e deduplicati, e il CID k+1 viene assegnato al k-esimo code point, con il CID 0 lasciato a .notdef. Un CIDToGIDMap esplicito manda ogni CID al suo glifo. U+0020 e U+00A0 ricevono quindi due CID diversi che disegnano lo stesso contorno, e la CMap ToUnicode che il componente scrive mappa ogni CID a esattamente un code point
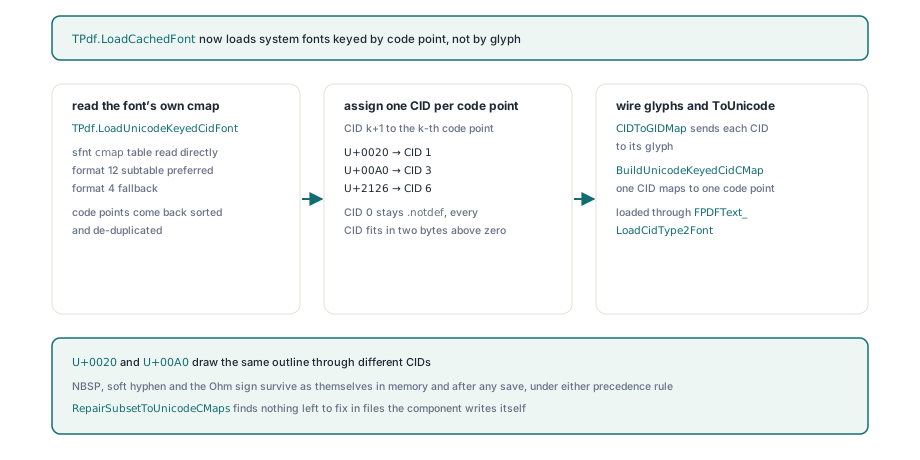
Il font viene caricato attraverso FPDFText_LoadCidType2Font, lo stesso punto di ingresso dietro la scrittura a livello di glifo in embedding di font CID Type 2 con mappe CID-to-GID esplicite. Quando FPDFText_SetText scrive in seguito una stringa, la ricerca inversa atterra su un singolo CID per carattere. Nulla di ciò dipende dalla regola di precedenza del reader, perché non c'è una seconda mappatura fra cui la regola possa scegliere. Il file salvato porta anche lo stream ToUnicode del componente stesso, quindi l'estrazione dopo un ricaricamento vede la stessa tabella uno-a-uno che usava il documento dal vivo
Il costo è un CIDToGIDMap più grande: due byte per code point coperto dal font. Supponete un font che mappa circa 3.000 code point. La mappa arriva quindi a circa 6 KB, consegnata all'engine con ogni font. Un compromesso che vale la pena fare sempre. Pochi kilobyte comprano un'estrazione che si legge uguale in PDFium, nei viewer che tengono la prima mappatura, e nel qualunque indicizzatore che il vostro cliente userà l'anno prossimo
Il round trip qui sotto scrive una stringa che contiene ogni coppia problematica, la estrae dal documento non salvato, salva, ricarica ed estrae di nuovo. Entrambe le stringhe devono coincidere esattamente con l'input; l'helper CodePoints c'è solo per rendere leggibile una discrepanza:
uses
  SysUtils, PDFium;

const
  // Spazio/U+00A0 e trattino/U+00AD condividono un glifo Arial, come
  // l'Omega greco (U+03A9) e il simbolo Ohm (U+2126)
  Sample: WString = 'two-x'#$00A0'y'#$00AD'z '#$03A9#$2126;

function CodePoints(const S: WString): string;
var
  I: Integer;
begin
  Result := '';
  for I := 1 to Length(S) do
    Result := Result + 'U+' + IntToHex(Ord(S[I]), 4) + ' ';
end;

var
  Pdf: TPdf;
  Live, Reloaded: WString;
begin
  Pdf := TPdf.Create(nil);
  try
    Pdf.CreateDocument;
    Pdf.AddPage(1, 595, 842);
    Pdf.AddText(Sample, 'Arial', 12, 72, 770);
    Live := Pdf.Text;                  // documento dal vivo, non salvato
    Pdf.SaveAs('codepoints.pdf');
  finally
    Pdf.Free;
  end;

  Pdf := TPdf.Create(nil);
  try
    Pdf.FileName := 'codepoints.pdf';
    Pdf.Active := True;
    Pdf.PageNumber := 1;
    Reloaded := Pdf.Text;              // dopo un salvataggio completo e un ricaricamento
  finally
    Pdf.Free;
  end;

  if (Live <> Sample) or (Reloaded <> Sample) then
    Writeln('Mismatch: ', CodePoints(Live), '/ ', CodePoints(Reloaded));
end.
Tenete NBSP e soft hyphen nella stringa di prova anche se i vostri documenti li contengono raramente. Un test che scrive solo ASCII passa anche contro una CMap indicizzata per glifo, perché niente in lui chiede mai al reader di scegliere fra due mappature
Perché una sola voce bfrange può cancellare un intero blocco?
Un solo bfrange la cui sequenza di CID attraversa un confine xxFF fa scartare a PDFium l'intero blocco in cui sta. ISO 32000-1 §9.10.3 lascia variare entro un range solo l'ultimo byte della destinazione, e il lato CID ha una trappola corrispondente nel parser di PDFium: deriva il CID alto come (low and $FFFFFF00) or (high and $FF). Una sequenza dal CID 00FE a 0101 viene letta come 00FE a 0001, basso maggiore dell'alto, e l'intero blocco viene marcato invalido. SetText riesce, la pagina si renderizza correttamente, e l'estrazione restituisce U+0000 per ogni carattere del blocco
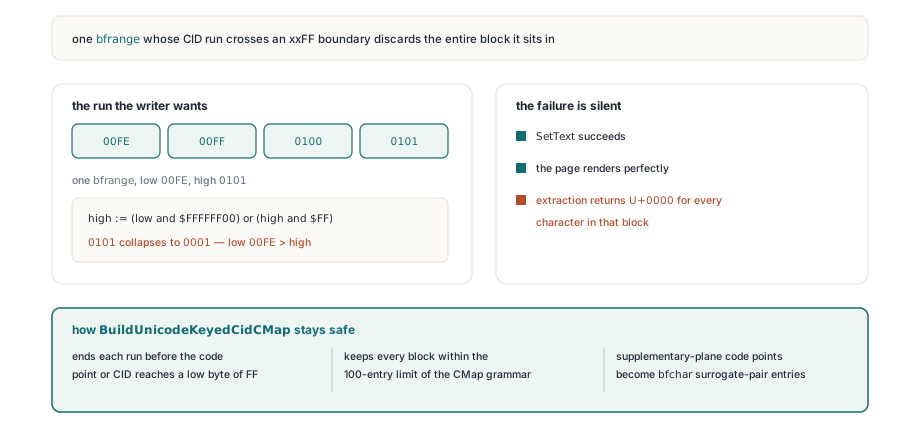
Un font indicizzato per code point è esattamente dove questo morde. I CID sono densi e sequenziali, quindi qualunque font con più di 255 code point produce sequenze di CID che attraverserebbero 00FF, 01FF e così via se il writer si limitasse a fondere le voci consecutive. La CMap che PDFium Component scrive termina una sequenza prima che il code point o il CID raggiunga un byte basso di FF, e spezza le voci in blocchi di al massimo 100, il limite che la grammatica CMap impone a ogni sezione beginbfrange e beginbfchar
I code point sopra U+FFFF ricevono voci bfchar individuali le cui destinazioni sono coppie surrogate UTF-16, visto che incrementare una coppia surrogate dentro un range non ha significato definito. Il lato surrogate della storia sta in emoji, CJK e gestione delle coppie surrogate in Delphi. Una CMap solo bfchar aggirerebbe del tutto il problema del confine, a dimensioni parecchie volte maggiori, ed è per questo che i range restano la forma principale e le regole di spezzamento portano il carico
Riparare i conflitti ToUnicode nei file di altri strumenti
RepairSubsetToUnicodeCMaps nell'unità FPdfCompress corregge il conflitto glyph-keyed nei file che il componente non ha scritto. TPdf.SaveAs la esegue a ogni salvataggio completo, non incrementale, e potete chiamarla direttamente su qualunque stream. Per ogni CID che porta due destinazioni vince la voce bfchar. Senza una bfchar per il CID, una coppia che differisce solo nel bit alto si risolve nel code point base-Latin più piccolo. Qualunque altro conflitto conserva la sua prima mappatura
La riparazione corregge sul posto i valori esadecimali in conflitto, con sostituzioni di uguale lunghezza. Layout dei blocchi, copertura dei CID e ogni altro byte dello stream restano com'erano, quindi la CMap resta nella forma che il reader di PDFium aveva già accettato. Una CMap ricostruita da zero sembrerebbe più ordinata in un dump esadecimale. Cambierebbe anche la struttura di uno stream che un reader severo aveva già accettato, ed è un azzardo senza vantaggi quando sbagliano solo un pugno di valori di destinazione
uses
  Classes, FPdfCompress;

var
  Source, Dest: TFileStream;
begin
  Source := TFileStream.Create('from-other-tool.pdf',
    fmOpenRead or fmShareDenyWrite);
  try
    Dest := TFileStream.Create('repaired.pdf', fmCreate);
    try
      // Solo correzioni di uguale lunghezza; i file senza conflitti
      // riparabili e i file con cross-reference stream o object stream vengono copiati tali e quali
      RepairSubsetToUnicodeCMaps(Source, Dest);
    finally
      Dest.Free;
    end;
  finally
    Source.Free;
  end;
end.
La routine ricostruisce una classica tabella di cross-reference, quindi i documenti che usano cross-reference stream, riferimenti ibridi o object stream passano byte per byte. I salvataggi incrementali (saIncremental) saltano la riparazione di proposito, perché una revisione incrementale deve restare append-only. Per il testo che il componente scrive da sé nessuno dei due casi conta: i suoi font indicizzati per code point non producono mai un conflitto da trovare
Dove si applica il percorso indicizzato per code point
Il percorso indicizzato per code point copre ogni font che espone una sottotabella cmap Unicode, e il caricamento glyph-keyed di PDFium gestisce il resto. Dettagli da conoscere prima di farci affidamento:
- I font symbol che portano solo una cmap (3,0), e qualunque font che il percorso CID non riesce a caricare, passano per
FPDFText_LoadFont, dove un glifo condiviso da due code point è soggetto alla regola di precedenza del reader - Con solo una sottotabella formato 4 la mappa copre il Basic Multilingual Plane; una sottotabella formato 12 sulla piattaforma (3,10) o sulla piattaforma Unicode aggiunge i code point dei piani supplementari
- Il glifo 0 e i code point surrogate restano fuori, e il conteggio delle voci è tappato a 65535 così ogni CID sta in due byte sopra lo zero
- Le TrueType Collection richiedono cura extra: la
GetFontDatadi GDI restituisce l'intero .ttc, eFPDFText_LoadCidType2Fontnon ha un parametro di indice di face, quindi passare la collection intatta incorporerebbe la face 0, SimSun, quando chiedevate NSimSun da simsun.ttc. Il componente confronta il nome della famiglia con la name table del font (nameID 1 e 16) e consegna la face richiesta come sfnt autonomo; una collection che non sa interpretare passa intatta e usa la face 0 - Se nessun font di sistema col nome richiesto è leggibile,
AddTextconsegna il nome del font aFPDFPageObj_NewTextObj, che lo cerca fra i font standard di PDFium
Ripiegate i caratteri invisibili nell'indice, teneteli nel testo
Una volta che l'estrazione restituisce i code point veri, nasce un'altra domanda: che cosa dovrebbe fare un indice di ricerca con un NBSP o un soft hyphen genuini, digitati di proposito dall'autore? Ripiegateli nel livello di indicizzazione e lasciate stare TPdf.Text. La stringa estratta è la registrazione di ciò che il documento dice; un indice è una vista con perdita costruita per il matching, e le regole di ripiegamento appartengono a lui
L'helper qui sotto è una funzione che aggiungete al vostro codice. Mappa NBSP a uno spazio ed elimina il soft hyphen, che secondo lo Unicode Standard marca solo un punto in cui una riga può spezzarsi. Lascia deliberatamente intatto U+2126. La normalizzazione NFC trasformerebbe il simbolo Ohm in Omega, perché U+2126 ha una decomposizione singleton canonica verso U+03A9, e se una ricerca in un datasheet debba trovare entrambi è una decisione di prodotto, non di estrazione:
uses
  SysUtils, Classes, PDFium;

// Il vostro helper per un indice di ricerca; non fa parte di PDFium Component
function FoldForIndex(const S: string): string;
begin
  Result := StringReplace(S, #$00A0, ' ', [rfReplaceAll]);
  Result := StringReplace(Result, #$00AD, '', [rfReplaceAll]);
end;

procedure IndexDocument(const FileName: string; Lines: TStrings);
var
  Pdf: TPdf;
  P: Integer;
begin
  Pdf := TPdf.Create(nil);
  try
    Pdf.FileName := FileName;
    Pdf.Active := True;
    for P := 1 to Pdf.PageCount do
    begin
      Pdf.PageNumber := P;
      Lines.Add(FoldForIndex(Pdf.Text));   // il testo esatto resta in Pdf.Text
    end;
  finally
    Pdf.Free;
  end;
end;
Eseguite IndexDocument sul file codepoints.pdf del primo esempio e la riga indicizzata dovrebbe leggere "two-x yz ΩΩ", undici caratteri con un simbolo Ohm come ultimo, mentre Pdf.Text restituisce ancora tutti i dodici caratteri originali, NBSP e soft hyphen inclusi
Font indicizzati per code point, riparazione della CMap ed estrazione del testo siedono sullo stesso modello di pagina in Delphi, C++Builder e Lazarus; l'API di font e testo è coperta per intero nella pagina del prodotto PDFium Component per Delphi