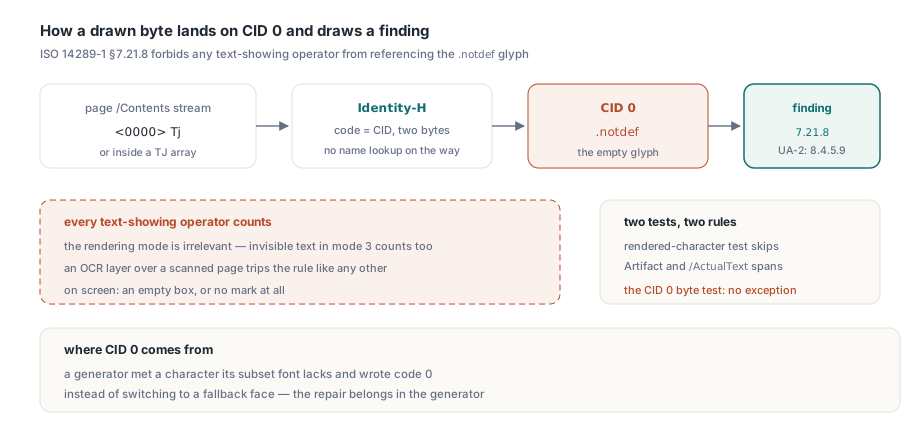
veraPDF boccia un report trimestrale taggato su ISO 14289-1 §7.21.8 perché un singolo operatore Tj mostra i byte <0000>, che sotto Identity-H significano CID 0, il glifo .notdef. Quella clause e la vicina §7.21.6, che limita i nomi di glifo che un array TrueType /Differences può usare, affiorano in Delphi come flag separati nel risultato di TPdf.ValidatePdfUa di PDFium Component
Quali operatori di testo referenziano il glifo .notdef?
Ogni operatore che mostra testo il cui operando mappa al glifo 0 lo fa. In un font semplice, .notdef è un nome di glifo. In un font CID-keyed lo stesso ruolo appartiene a CID 0, e ISO 32000-2 §9.7.4.2 esige che ogni CIDFont contenga una descrizione di glifo per CID 0 "analoga al nome di carattere .notdef nei font semplici". Con la consueta codifica Identity-H, codice di carattere e CID sono gli stessi due byte, così un content stream che mostra <0000> con Tj, o dentro un array TJ, sta disegnando CID 0. ISO 14289-1 §7.21.8 vieta a qualunque operatore che mostra testo di farlo, e PDF/UA-2 enuncia lo stesso requisito in §8.4.5.9. La modalità di rendering del testo è irrilevante. Anche il testo invisibile in modalità 3, come il layer OCR sopra una pagina scansita, conta. Sullo schermo il risultato è di norma una casella vuota larga qualche punto, o nessun segno affatto, e nessuna delle due dice a un correttore vedente che un carattere è sparito
La fonte consueta è un generatore che ha incontrato un carattere assente dal suo font subset e ha scritto il codice 0 dove sarebbe dovuto passare a un font di ripiego. Questo rende il controllo a livello di byte piacevolmente preciso. Decodificate solo gli stream referenziati dal /Contents di ogni pagina, cercate <0000> dato in pasto a Tj o TJ in un documento che usa font Type 0, e lasciate immagini, profili ICC e CMap compressi. Un dettaglio di parsing decide se trovate le pagine. ISO 32000-1 §7.3.5 chiude un token di nome alla prossima delimitatore, così /Type/Page senza spazio è un dizionario di pagina valido, e una ricerca della forma spaziata /Type /Page lo salta. Nominare /.notdef dentro un array Differences non urta da solo questa regola; la urta solo mostrare un codice che atterra su quello slot
Quali nomi di glifo /Differences contano come conformi a Unicode?
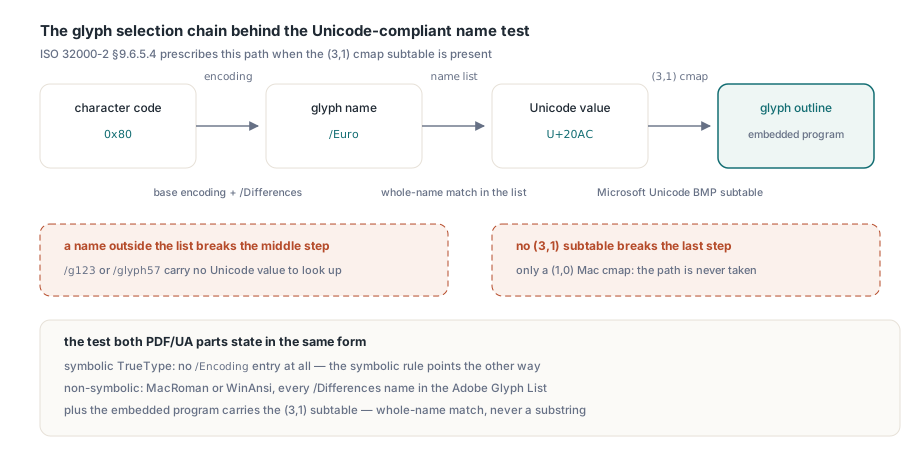
Quelli che compaiono nell'Adobe Glyph List, a condizione che anche il programma font incorporato contenga una subtable cmap (3,1). Il contesto è ISO 32000-2 §9.6.5.4, che raccomanda a un font TrueType non symbolic di usare MacRomanEncoding o WinAnsiEncoding senza array Differences; PDF/UA trasforma quel consiglio in un requisito con una via di fuga. Entrambe le parti PDF/UA enunciano il test nella stessa forma che veraPDF applica: il font è symbolic, oppure la sua codifica è MacRoman o WinAnsi e o non ha array /Differences o ogni nome in quell'array è conforme a Unicode. La condizione (3,1) discende dall'ordine di selezione dei glifi che §9.6.5.4 prescrive quando quella subtable (piattaforma Microsoft, Unicode BMP) è presente. Il codice di carattere va al nome di glifo attraverso la codifica, il nome di glifo va a Unicode attraverso l'Adobe Glyph List, e Unicode va al glifo attraverso la subtable (3,1). Un nome fuori dalla lista rompe il passo di mezzo, e un font senza la subtable non prende mai quella strada. La regola del font symbolic punta dall'altra parte: un font TrueType symbolic non deve portare affatto una voce /Encoding
| Dizionario font | Risultato |
|---|---|
Non symbolic, /Encoding /WinAnsiEncoding, senza Differences | Passa |
Non symbolic, base WinAnsi, Differences con /Euro /bullet /.notdef, il font ha una cmap (3,1) | Passa |
Non symbolic, Differences contenente /g123 o /glyph57 | Fallisce: nomi fuori dalla lista dei glifi |
| Non symbolic, Differences valide, il font incorporato ha solo una cmap Mac (1,0) | Fallisce: nessuna subtable (3,1) |
Non symbolic, base WinAnsi con Differences, senza FontFile2 incorporato | Non deciso da questa regola; la regola di incorporamento (§7.21.4) lo boccia |
Non symbolic, senza voce /Encoding | Fallisce |
Symbolic, qualunque voce /Encoding | Fallisce la regola symbolic |
La seconda riga è dove sbagliano le liste di glifi costruite in casa. La lista che veraPDF spedisce con il suo codice font, font/AdobeGlyphList.txt, ha 4.282 voci, e la sua prima riga è .notdef 0000. Le tabelle assemblate a mano o prese da altre fonti spesso mancano di quella voce, perché .notdef sta per nessun carattere reale. Un checker costruito su una simile tabella riporta ogni font il cui array Differences menziona /.notdef, un nome che spunta di regola nei font subset che riempiono di lui gli slot inutilizzati. Il confronto è per nome intero. Una ricerca di sottostringa accetterebbe /grav solo perché /grave è in lista. Riempite gli slot Differences inutilizzati con .notdef liberamente; un checker che segue veraPDF lo accetta
Le regole sui font si giudicano sui byte che il produttore ha scritto
Una scorciatoia naturale è salvare una copia normalizzata del documento e scansionare quella, dato che un file riscritto è più facile da parsare. Per le regole sui font, fallisce. Qualunque strumento che ri-serializza un PDF è libero di ricostruire i dizionari font: piegare un array Differences in una codifica fresca, rinominare glifi, rinumerare oggetti. Una regola di codifica va quindi verificata contro i byte che il produttore ha scritto. TPdf.ValidatePdfUa fa girare i suoi test sui font sul file o sul buffer di memoria che ha caricato e decodifica direttamente gli stream FontFile2 per raggiungere la directory delle tabelle TrueType. Il test a livello di carattere (un carattere disegnato mappa a Unicode 0?) usa il testo che la pagina renderizza e salta il contenuto marcato come Artifact o coperto da /ActualText; il test sui byte del CID 0 non fa nessuna eccezione del genere. I rilievi arrivano come valori separati nell'issue set, così un report può dire quale regola è scattata:
uses
  SysUtils, PDFium, FPdfPdfua;

procedure ReportFontFindings(const FileName: string);
const
  FontIssues: TPdfUaValidationIssues = [pvuaiPdfiumNotDefGlyph,
    pvuaiTrueTypeEncodingInvalid, pvuaiSymbolicTrueTypeEncoding,
    pvuaiFontNotEmbedded, pvuaiFontMissingToUnicode];
var
  Pdf: TPdf;
  Report: TPdfUaValidationResult;
  Found: TPdfUaValidationIssues;
  Coverage: TPdfUaUnicodeCoverageReport;
  I: Integer;
begin
  Pdf := TPdf.Create(nil);
  try
    Pdf.FileName := FileName;
    Pdf.Active := True;
    if not Pdf.Active then
      raise Exception.CreateFmt('Cannot open %s', [FileName]);
    Report := Pdf.ValidatePdfUa;
    Found := Report.Issues * FontIssues;
    if pvuaiPdfiumNotDefGlyph in Found then
    begin
      Writeln('Text references .notdef / CID 0 (7.21.8, 8.4.5.9)');
      // Localizzate i caratteri renderizzati che non mappano ad alcun valore Unicode
      Coverage := Pdf.InspectPdfUaUnicodeCoverage;
      for I := 0 to High(Coverage.Objects) do
        if Coverage.Objects[I].MissingUnicodeCharacterCount > 0 then
          Writeln(Format('  page %d, object %d: %d character(s)',
            [Coverage.Objects[I].PageNumber,
             Coverage.Objects[I].PageObjectIndex,
             Coverage.Objects[I].MissingUnicodeCharacterCount]));
    end;
    if pvuaiTrueTypeEncodingInvalid in Found then
      Writeln('Non-symbolic TrueType encoding or Differences (7.21.6, 8.4.5.7)');
    if pvuaiSymbolicTrueTypeEncoding in Found then
      Writeln('Symbolic TrueType font carries an /Encoding entry');
    if pvuaiFontNotEmbedded in Found then
      Writeln('A font program is not embedded (7.21.4)');
    if pvuaiFontMissingToUnicode in Found then
      Writeln('A font has no usable Unicode mapping (7.21.7)');
    if Found = [] then
      Writeln('No font findings');
    // Atteso per un file il cui unico difetto è /g123 in un array Differences:
    // la sola riga 7.21.6
  finally
    Pdf.Free;
  end;
end;
Le riparazioni appartengono al programma che ha scritto il file
Nessuno dei due rilievi si ripara in sicurezza dopo, modificando un dizionario. Un riferimento a CID 0 significa che un carattere non aveva glifo nel font usato, quindi il generatore vuole un font di ripiego per quel carattere. Riscrivere <0000> verso un altro codice disegnerebbe un glifo arbitrario e gli attaccherebbe il valore Unicode sbagliato. Un array Differences con nomi come /g123 di norma viene dal subset di un font i cui glifi non portano nomi standard. La riparazione pulita è incorporare quella face come font TrueType CID-keyed, la configurazione usata per l'incorporamento di font CID Type 2, con Identity-H e una CMap /ToUnicode. Questo toglie dalla partita la regola di codifica dei font semplici
Impostare il flag Symbolic per far sparire §7.21.6 è la mossa sbagliata. Un font TrueType symbolic non può portare /Encoding. I nomi Differences che dicevano a uno screen reader quale carattere rappresenta ogni codice spariscono insieme a lui, e ogni viewer allora sceglie i glifi per codice grezzo attraverso la subtable (3,0) o (1,0). Il flag si pulisce. Il significato del testo se ne va con lui
Il programma font incorporato ha una cmap (3,1)?
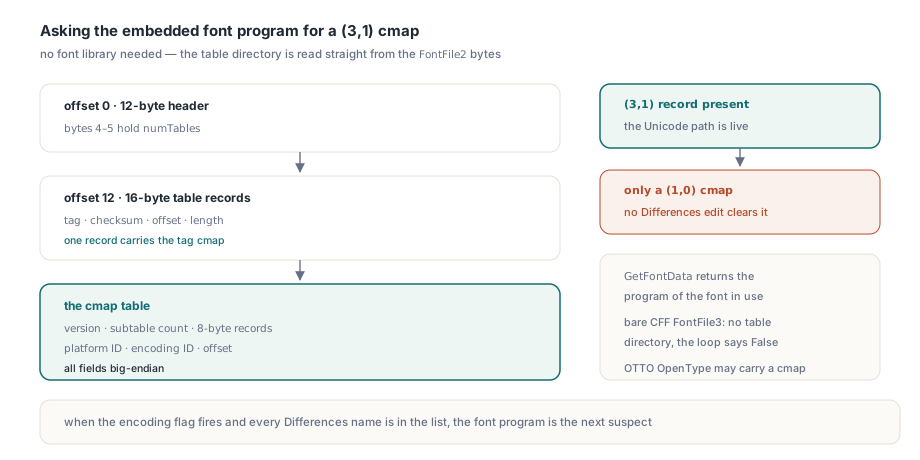
Chiedetelo direttamente al programma font, perché il flag di codifica copre entrambe le metà del test e non sa dire quale sia caduta. Quando scatta e ogni nome Differences è in lista, il programma è il prossimo sospettato. Un file TrueType comincia con un header di 12 byte i cui byte 4–5 tengono il numero di tabelle, seguito da record di tabella da 16 byte (tag, checksum, offset, lunghezza). La tabella cmap comincia con una versione e un conteggio di subtable, seguito da record da 8 byte di platform ID, encoding ID e offset, tutti big-endian. Serve nessuna libreria font. TPdf.GetFontData restituisce il programma incorporato del font usato da un oggetto pagina, così l'helper può girare su ogni oggetto testo di una pagina:
function BE16(const B: TBytes; P: Integer): Integer;
begin
  Result := (B[P] shl 8) or B[P + 1];
end;

function BE32(const B: TBytes; P: Integer): Cardinal;
begin
  Result := (Cardinal(B[P]) shl 24) or (Cardinal(B[P + 1]) shl 16) or
    (Cardinal(B[P + 2]) shl 8) or B[P + 3];
end;

// True quando un programma TrueType ha una subtable cmap per (Platform, Encoding)
function HasCmapSubtable(const Font: TBytes; Platform, Encoding: Integer): Boolean;
var
  Tables, I, Rec, CmapOfs, Count: Integer;
begin
  Result := False;
  if Length(Font) < 12 then
    Exit;
  Tables := BE16(Font, 4);
  CmapOfs := -1;
  for I := 0 to Tables - 1 do
  begin
    Rec := 12 + I * 16;
    if Rec + 16 > Length(Font) then
      Exit;
    if (Font[Rec] = Ord('c')) and (Font[Rec + 1] = Ord('m')) and
       (Font[Rec + 2] = Ord('a')) and (Font[Rec + 3] = Ord('p')) then
      CmapOfs := Integer(BE32(Font, Rec + 8));
  end;
  if (CmapOfs < 0) or (CmapOfs + 4 > Length(Font)) then
    Exit;
  Count := BE16(Font, CmapOfs + 2);
  for I := 0 to Count - 1 do
  begin
    Rec := CmapOfs + 4 + I * 8;
    if Rec + 8 > Length(Font) then
      Exit;
    if (BE16(Font, Rec) = Platform) and (BE16(Font, Rec + 2) = Encoding) then
      Exit(True);
  end;
end;

// Un font con solo una cmap Mac Roman (1,0) stampa cmap(3,1)=False
procedure ListTextFonts(Pdf: TPdf; PageNo: Integer);
var
  I: Integer;
begin
  Pdf.PageNumber := PageNo;
  for I := 0 to Pdf.ObjectCount - 1 do
    if Pdf.ObjectType[I] = otText then
      Writeln(Format('%-32s embedded=%-5s cmap(3,1)=%s', [
        string(Pdf.GetFontBaseName(I)),
        BoolToStr(Pdf.GetFontIsEmbedded(I), True),
        BoolToStr(HasCmapSubtable(Pdf.GetFontData(I), 3, 1), True)]));
end;
Gli oggetti testo che condividono uno stesso font stampano la stessa riga ripetuta. Qui non nuoce. Un programma CFF nudo (FontFile3 con /Type1C o /CIDFontType0C) non ha directory di tabelle, così l'helper risponde False per lui, e dato che la regola riguarda i font TrueType quella risposta non decide mai nulla qui. I font OpenType con outline CFF sono diversi: portano una directory sfnt sotto il tag OTTO e possono includere una cmap, che lo stesso ciclo trova. Mentre il programma è in memoria, le sue larghezze di avanzamento hmtx meritano un confronto anche con le /Widths del dizionario font, perché PDF/UA ha una regola separata di coerenza delle larghezze, e l'audit di larghezze glifo, CharSet e CIDSet la applica dal lato PDFlibPas
Se HasCmapSubtable restituisce False per il font dietro a un flag §7.21.6, nessuna modifica al suo array Differences pulirà il rilievo, e il generatore deve incorporare quel font come Type 0 con una CMap ToUnicode. Fate girare di nuovo la validazione del PDFium Component per Delphi sul file rigenerato e aspettatevi pvuaiTrueTypeEncodingInvalid assente da Report.Issues