Importi un FDF in un modulo e i valori dei campi tornano sbagliati in modo sottile: un bullet arriva come un dagger, un ellissi come un em dash. La PDFium Component ha ricondotto l'intera famiglia di sintomi a una singola riga della sua tabella PDFDocEncoding — il blocco dei caratteri speciali dell'Annex D.2 di ISO 32000-1 parte da $80, non da $7F
Perché un import FDF restituisce il carattere vicino?
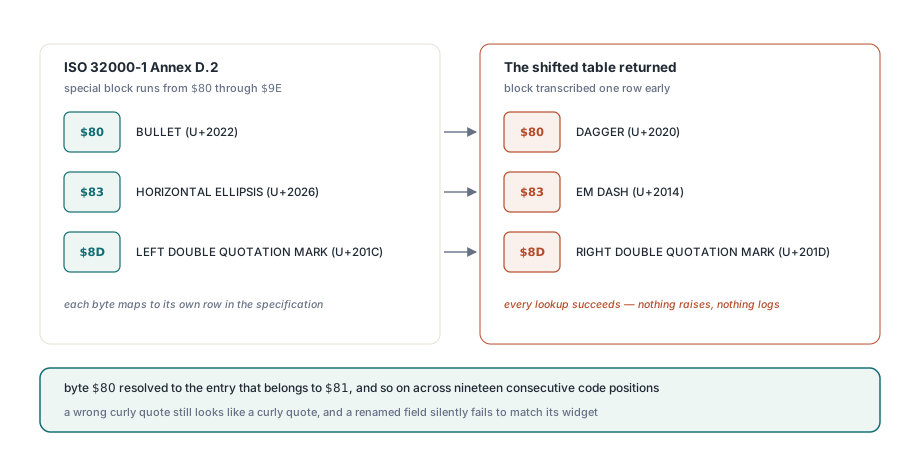
Perché una tabella di codifica spostata di una posizione resta una tabella dall'aria perfettamente valida, e ogni lookup al suo interno riesce. Il blocco che l'Annex D.2 assegna a $80–$9E era stato trascritto una riga prima, quindi il byte $80 risolveva nella voce che appartiene a $81, il byte $81 nella voce di $82, e così via per diciannove posizioni di codice consecutive. Nulla sollevava eccezioni, nulla loggava, e nessun campo è mai stato rifiutato — TPdf.ImportFDF riportava lo stesso conteggio di campi di sempre
Il danno era uniforme e silenzioso. Un byte che porta $80, che l'Annex D.2 definisce come BULLET (U+2022), tornava come DAGGER (U+2020). Il byte $83, HORIZONTAL ELLIPSIS (U+2026), tornava come EM DASH (U+2014). Il byte $8D, LEFT DOUBLE QUOTATION MARK (U+201C), tornava come RIGHT DOUBLE QUOTATION MARK (U+201D) — il caso che nessuno nota, perché una virgoletta curva sbagliata sembra comunque una virgoletta curva in un campo di modulo. I nomi dei campi hanno subito la stessa sorte dei valori, che è peggio: un nome che non corrisponde più al widget nel documento fallisce silenziosamente l'applicazione
Le stringhe di testo PDF portano due codifiche diverse
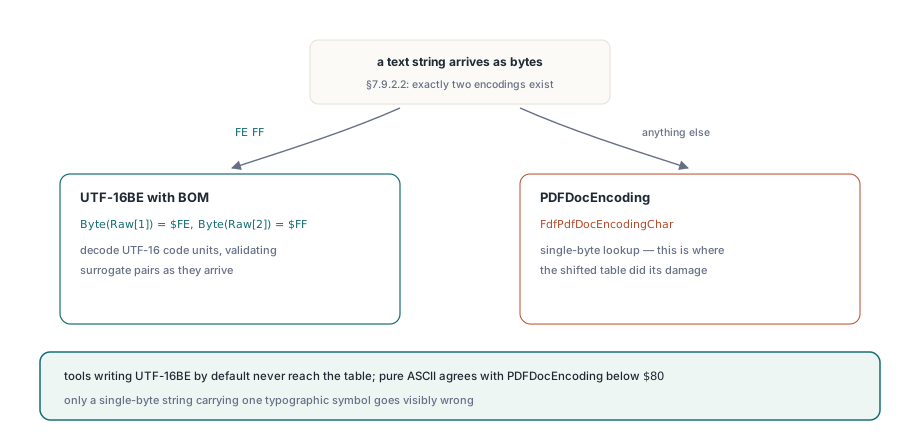
ISO 32000-1 §7.9.2.2 definisce il tipo text string come una di esattamente due codifiche, scelta ispezionando i primi due byte invece che da qualsiasi voce di dizionario. Una stringa che apre con il byte order mark FE FF è UTF-16BE; tutto il resto è PDFDocEncoding. Quel singolo ramo decide quale di due decoder completamente diversi gira, e la PDFium Component lo applica dentro il parser FDF prima di toccare un singolo carattere
// Stringa di testo FDF: UTF-16 quando il BOM è presente, altrimenti PDFDocEncoding
if (Length(Raw) >= 2) and
   (((Byte(Raw[1]) = $FE) and (Byte(Raw[2]) = $FF)) or
    ((Byte(Raw[1]) = $FF) and (Byte(Raw[2]) = $FE))) then
begin
  BigEndian := Byte(Raw[1]) = $FE;
  // ... decodifica le code unit UTF-16, convalidando le coppie di surrogati
end
else
begin
  SetLength(Result, Length(Raw));
  for I := 1 to Length(Raw) do
    Result[I] := FdfPdfDocEncodingChar(Byte(Raw[I]));
end;
È per questo che il bug si è nascosto così a lungo nei test ordinari. Qualsiasi FDF prodotto da uno strumento che scrive UTF-16BE di default non arriva mai a FdfPdfDocEncodingChar, quindi la tabella spostata resta dormiente. Solo le stringhe a byte singolo — che è ciò che molti generatori FDF emettono per i nomi di campo latini semplici, perché sono più corte — scendono nel ramo dove la tabella conta. I nomi di campo ASCII puri decodificano comunque correttamente, visto che sotto $80 PDFDocEncoding e ASCII concordano. Ti serve una stringa a byte singolo che contenga un simbolo tipografico prima che qualcosa vada visibilmente storto
La tabella corretta, e i due ancoraggi che la fissano
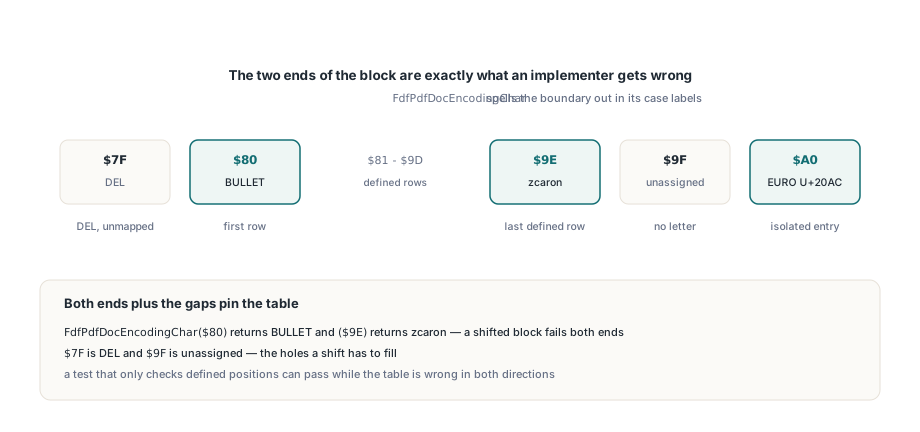
La PDFium Component ora esplicita il confine dentro FdfPdfDocEncodingChar stesso, perché le due estremità del blocco sono esattamente ciò che un implementatore sbaglia. $7F è DEL e non ha alcun significato PDFDocEncoding; il blocco si apre a $80 con BULLET e arriva a $9E con zcaron; $9F è non assegnato; e il segno dell'Euro sta da solo a $A0
function FdfPdfDocEncodingChar(Value: Byte): WideChar;
begin
  case Value of
    // ISO 32000-1, Allegato D.2. Il blocco parte da $80, non da $7F: $7F è DEL e
    // non ha significato in PDFDocEncoding, e l'Euro sta a $A0, che il
    // ramo predefinito restituirebbe altrimenti come spazio unificatore
    $7F: Result := WideChar($FFFD);
    $80: Result := WideChar($2022);   // BULLET, prima riga del blocco
    $81: Result := WideChar($2020);   // DAGGER
    // ... $82 through $9D
    $9E: Result := WideChar($017E);   // zcaron, ultima riga definita
    $9F: Result := WideChar($FFFD);   // non assegnato nell'Allegato D.2
    $A0: Result := WideChar($20AC);   // EURO SIGN
  else
    Result := WideChar(Value);
  end;
end;
Guarda cosa lo spostamento ha fatto a quelle due estremità, perché è lì che un off-by-one smette di essere cosmetico. zcaron stava a $9E nella specifica ma a $9D nella tabella spostata, quindi un byte di documento $9E cadeva oltre l'ultima riga che qualcuno aveva trascritto e precipitava dritto nel fallback identità, restituendo un carattere di controllo C1 invece di una lettera. E $A0, l'Euro, non era mai stato scritto nella tabella in primo luogo — il ramo identità lo restituiva come U+00A0 NO-BREAK SPACE, un carattere che sopravvive a ogni validazione successiva, non stampa nulla, e non corrisponde mai al nome di campo che stai cercando
Come si testa una tabella di codifica trascritta?
Testa la prima riga, l'ultima riga e i buchi — non un campione dal mezzo. È la parte della correzione che vale la pena portare in qualsiasi altra tabella che copi da una specifica, perché un controllo a campione nel mezzo del blocco è precisamente il test che uno spostamento dell'intero blocco supera. Verificare che $8D dia una virgoletta doppia sinistra non prova nulla quando anche $8C dà qualcosa di plausibile; verificare che $80 dia BULLET e $9E dia zcaron fissa entrambe le estremità, e un blocco spostato non può soddisfarle entrambe insieme
procedure CheckPdfDocEncodingAnchors;
begin
  // Entrambe le estremità del blocco speciale dell'Allegato D.2: uno spostamento dell'intero blocco le romperebbe
  Assert(FdfPdfDocEncodingChar($80) = WideChar($2022), 'first row: BULLET');
  Assert(FdfPdfDocEncodingChar($9E) = WideChar($017E), 'last row: zcaron');
  // Le posizioni di codice che la specifica lascia indefinite non devono decodificare in una lettera
  Assert(FdfPdfDocEncodingChar($7F) = WideChar($FFFD), '$7F is DEL, unmapped');
  Assert(FdfPdfDocEncodingChar($9F) = WideChar($FFFD), '$9F is unassigned');
  // La voce isolata sopra il blocco, facile da omettere del tutto
  Assert(FdfPdfDocEncodingChar($A0) = WideChar($20AC), 'EURO SIGN');
end;
Le posizioni non definite meritano i loro assert invece di essere saltate come poco interessanti. Un off-by-one deve mettere qualcosa da qualche parte, e dove lo mette è quasi sempre una posizione di codice che la specifica ha lasciato vuota — $7F davanti, $9F dietro. Un test che controlla solo le posizioni definite può passare mentre la tabella è sbagliata in entrambe le direzioni; un test che fissa i buchi becca lo spostamento alla prima esecuzione
Quanto costa in un workflow di moduli round-trip
Un import FDF che riscrive in silenzio un carattere per simbolo è peggio di uno che fallisce, perché il fallimento riemerge a valle e sembra qualcos'altro. I nomi dei campi sono qui il filo tagliente. TPdf.ImportFDF confronta i nomi in arrivo con i widget del documento aperto, e un nome decodificato con un carattere sbagliato semplicemente non corrisponde — il campo resta vuoto, il valore di ritorno conta comunque il campo come parsato, e il report che esce dalla pipeline è corto di un valore senza nulla nel log che spieghi perché. Chiunque costruisca un loop export-e-reimport del tipo descritto in esportare e importare dati di moduli XFDF e annotazioni con PDFium Component dovrebbe fare round-trip di un nome di campo con un simbolo tipografico, non solo ASCII puro, prima di fidarsi del loop
Vale anche la pena di essere onesti sui limiti della correzione. La tabella ora combacia con l'Annex D.2 per tutti i 256 valori di byte, il che fa decodificare correttamente le stringhe FDF a byte singolo, ma la PDFDocEncoding stessa copre un repertorio latino e nulla più — qualsiasi cosa fuori deve arrivare come UTF-16BE con BOM, che è esattamente ciò che §7.9.2.2 intende. E una stringa UTF-16 ha comunque i suoi pericoli separati lato Delphi, visto che un code point oltre U+FFFF ha bisogno di una coppia di surrogati invece che di un solo WideChar, il problema coperto in perché emoji e caratteri CJK rompono WideChar in Delphi. Il punto più ampio generalizza oltre le tabelle di codifica: un parser PDF può rifiutare qualcosa che dovrebbe accettare, e lo trovi subito, oppure accettare qualcosa e sbagliarla in silenzio, e lo trovi in produzione. Le trappole dei name token descritte in parsing sicuro dei dizionari PDF stanno nella seconda categoria, e così una tabella spostata di una riga — il percorso di codice riesce, il valore di ritorno sembra ragionevole, e solo un test scritto contro la specifica invece che contro l'implementazione dice il contrario
ImportFDF, ExportFDF e ImportXFDF su TPdf, insieme ai parser FDF e XFDF che stanno dietro, fanno parte della PDFium Component standard per Delphi e C++Builder