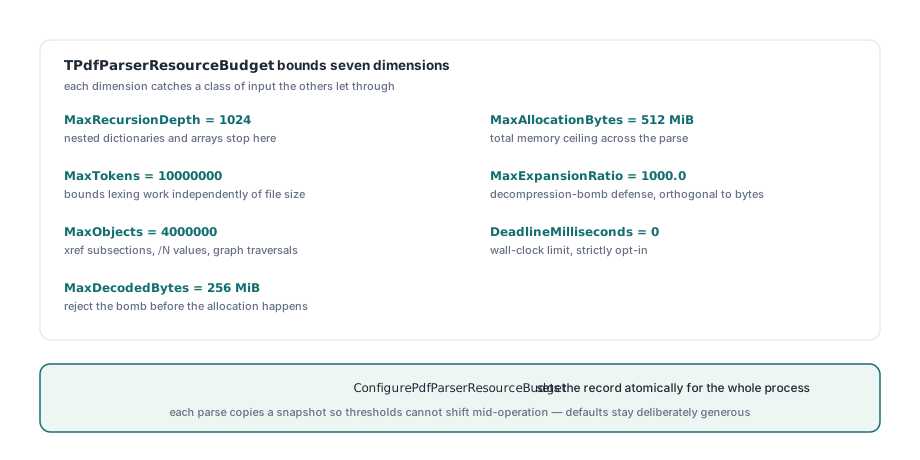
La PDFium Component espone TPdfParserResourceBudget, un singolo record che mette limiti a profondità di ricorsione, conteggio dei token, conteggio degli oggetti, byte decodificati, rapporto di espansione, allocazioni e una scadenza wall-clock per ogni parser PDF della libreria. ConfigurePdfParserResourceBudget lo imposta atomicamente per il processo, e ogni parse copia uno snapshot così le sue soglie non possono spostarsi a operazione in corso
Sei parser, sei soffitti privati
La situazione che lo ha imposto era banale e probabilmente familiare. La traversata dello xref sparse aveva il suo soffitto di oggetti. L'ispettore degli stream aveva il suo cap di byte decodificati. XMP ne aveva uno, XFDF e FDF un altro, la normalizzazione dei contenuti un terzo, e i default di preflight un quarto. Ognuno di quei numeri era difendibile da solo e nessuno era raggiungibile dall'esterno, quindi un chiamante che voleva dire "questo percorso di intake gestisce upload anonimi, qui nulla può allocare più di 64 MiB o girare più di quattro secondi" non aveva dove dirlo. Il secondo problema era peggiore perché silenzioso: dove un limite viveva in un globale mutabile, un parse iniziato sotto una policy poteva finire sotto un'altra. Un thread chiama un setter mentre un altro è a metà di un object stream, e la prima metà di quella traversata è limitata dal vecchio soffitto mentre la seconda metà dal nuovo. Nulla crasha, nulla logga, e dopo non puoi dire sotto quali limiti l'operazione sia davvero girata, che è esattamente la proprietà per cui ti servivano i limiti
Cosa limita davvero TPdfParserResourceBudget?
Sette dimensioni, scelte perché ognuna cattura una classe di input che le altre lasciano passare. MaxRecursionDepth è 1024 di default e impedisce a dizionari e array annidati di trasformare la sintassi degli oggetti di ISO 32000-1 §7.3 in uno stack overflow. MaxTokens è 10.000.000 di default e limita il lavoro di lexing indipendentemente dalla dimensione del file. MaxObjects è 4.000.000 di default e copre i conteggi delle sottosezioni di cross-reference, i valori /N degli object stream e le traversate di grafi. MaxDecodedBytes è 256 MiB di default e MaxAllocationBytes 512 MiB, così un file può essere rifiutato prima dell'allocazione invece che dopo. MaxExpansionRatio è 1000.0 di default ed è quella che la gente sottovaluta: i filtri di stream di ISO 32000-1 §7.4 sono compressione generica, qualche kilobyte di dati Flate può legittimamente espandersi in centinaia di megabyte, e un soffitto sul rapporto è la difesa standard contro una decompression bomb. È ortogonale al cap assoluto sui byte, perché uno stream da 200 KiB che vuole diventare 200 MiB sta sotto il soffitto dei 256 MiB ed è comunque assurdo. DeadlineMilliseconds è 0 di default, cioè nessuna scadenza, quindi quella dimensione è strettamente opt-in. I default come insieme sono volutamente generosi, calibrati per tenere i normali documenti aziendali lontani da qualsiasi inciampo invece di essere un profilo indurito; se il tuo input arriva da un form di upload pubblico ti serve qualcosa di più vicino ai numeri sotto, insieme alle regole descritte in indurire un riquadro di anteprima PDF in Delphi
uses
  FPdfPdfCommon;

procedure ApplyUntrustedIntakeBudget;
var
  Budget: TPdfParserResourceBudget;
begin
  Budget := TPdfParserResourceBudget.Default;
  // Defaults kept: MaxRecursionDepth 1024, MaxTokens 10000000,
  // MaxObjects 4000000
  Budget.MaxDecodedBytes      := Int64(32) * 1024 * 1024;  // default 256 MiB
  Budget.MaxAllocationBytes   := Int64(64) * 1024 * 1024;  // default 512 MiB
  Budget.MaxExpansionRatio    := 50.0;                     // default 1000.0
  Budget.DeadlineMilliseconds := 4000;                     // default 0 = off
  ConfigurePdfParserResourceBudget(Budget);
end;
Perché fare uno snapshot invece di leggere il globale?
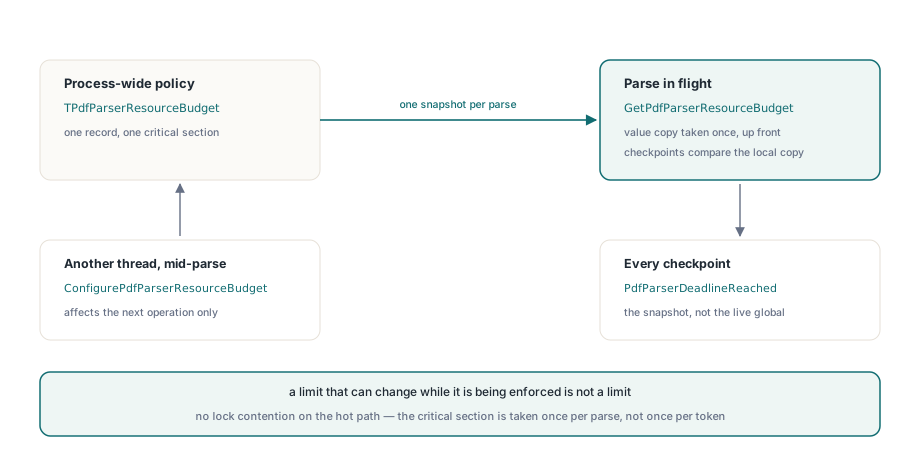
Perché un limite che può cambiare mentre viene applicato non è un limite. È il punto di design centrale di tutta la funzionalità, ed è una riga di disciplina in ogni punto d'ingresso: leggi la policy una volta all'inizio dell'operazione in un TPdfParserResourceBudget locale, poi fai confrontare ogni checkpoint contro quella copia locale. GetPdfParserResourceBudget prende la critical section e restituisce una copia per valore del record, e da lì in poi il parse non tocca più stato globale mutabile. Il risultato è che una chiamata a ConfigurePdfParserResourceBudget da un altro thread influenza l'operazione successiva, mai quella in volo. Parse concorrenti girano sotto policy diverse senza interferire, un'operazione fallita su un limite di risorse è fallita contro un singolo insieme coerente di soglie, e non c'è contesa sul lock nel percorso caldo perché il lock viene preso una volta per parse, non una volta per token
type
  TCustomScanState = record
    Budget: TPdfParserResourceBudget;
    StartTick: Cardinal;
    TokenCount: Int64;
    Depth: Integer;
  end;

procedure BeginScan(var S: TCustomScanState);
begin
  S.Budget := GetPdfParserResourceBudget;  // snapshot acquisito una sola volta, all'inizio
  S.StartTick := PdfParserStartTick;
  S.TokenCount := 0;
  S.Depth := 0;
end;

function ScanCheckpoint(var S: TCustomScanState): Boolean;
begin
  Result := False;
  if PdfParserDeadlineReached(S.StartTick, S.Budget) then
    Exit;
  Inc(S.TokenCount);
  if S.TokenCount > S.Budget.MaxTokens then
    Exit;
  if S.Depth > S.Budget.MaxRecursionDepth then
    Exit;
  Result := True;
end;
Se scrivi un tuo parser sopra la libreria, copia quella forma invece di chiamare GetPdfParserResourceBudget dentro il tuo loop dei token. Chiamarla per token è corretto ma inutile: paghi una critical section a ogni iterazione e reintroduci lo scivolamento a metà operazione che lo snapshot doveva prevenire
Perché un soffitto sui byte non ferma un file patologico?
Perché dimensione e costo sono solo vagamente correlate nel PDF. Un file da 400 KiB con uno stream di cross-reference ISO 32000-1 §7.5.8 i cui array /Index e /W descrivono un conteggio di voci plausibile ma ostile, una catena di object stream che rivisita gli stessi offset, o uno stream di contenuto con operatori che costano più di quanto sembrano, se ne sta comodo sotto ogni soffitto di byte e oggetti che imposti e occupa comunque un worker thread per minuti. I conteggi di byte limitano la memoria; non limitano il tempo. È a questo che servono PdfParserStartTick e PdfParserDeadlineReached. PdfParserStartTick cattura un valore di tick all'inizio dell'operazione e PdfParserDeadlineReached confronta il tempo trascorso con DeadlineMilliseconds, restituendo False ogni volta che la scadenza è 0. La sottrazione gira in aritmetica senza segno, quindi un rollover del contatore di tick non produce un timeout spurious. Il parsing della cross-reference, la decodifica degli object stream, la normalizzazione dei token di contenuto e i reader FDF e XFDF lo controllano tutti in testa al loro loop, così un parse fuori budget si ferma a un checkpoint invece di essere ucciso dall'esterno
Due avvertenze oneste. È tempo wall-clock, non tempo CPU, quindi una macchina che swappa o un build server sotto carico può far scattare una scadenza che una macchina tranquilla supererebbe, il che consiglia di impostarla ben sopra il tuo peggior caso osservato invece che vicino alla mediana. Ed è spenta di default, perché una scadenza che scatta su un documento legittimamente grande durante un batch di fine mese è un guasto peggiore di quello che previene. Attivala per percorso di intake invece che globalmente, e abbinala ai controlli strutturali in validare gli stream di cross-reference
Il budget è un soffitto, non un sostituto dei limiti di formato
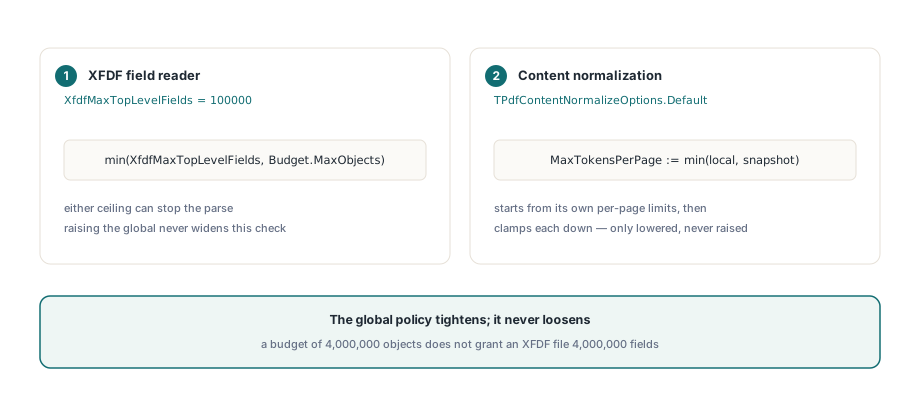
Ogni parser tiene le sue costanti specifiche di formato e applica entrambe. XFDF è l'esempio più chiaro: il reader dei campi impone XfdfMaxTopLevelFields e una costante MaxFieldNodes di 100000 accanto al valore dello snapshot, e l'una o l'altra può fermare il parse
const
  XfdfMaxTopLevelFields = 100000;   // format-local, always applies
...
  // Entrambi i tetti sono attivi; vince quello più basso
  if (FieldCount >= XfdfMaxTopLevelFields) or
     (FieldCount >= Budget.MaxObjects) then
    Exit(False);
È intenzionale e vale la pena interiorizzarlo prima di andare a cercare una manopola che non esiste. Un budget globale di 4.000.000 di oggetti non concede a un file XFDF 4.000.000 di campi, perché 100000 campi è già ben oltre qualsiasi cosa produca un vero export di annotazioni, e alzare un soffitto globale non deve allargare in silenzio un sanity check specifico di formato. La normalizzazione dei contenuti funziona allo stesso modo nella direzione opposta: TPdfContentNormalizeOptions.Default parte dai suoi limiti per pagina e poi blocca ognuno di essi verso il basso allo snapshot, quindi MaxTokensPerPage può solo essere abbassato dal budget, mai alzato. La policy globale stringe; non allenta mai
Una configurazione sbagliata fallisce quando la configuri
ConfigurePdfParserResourceBudget valida prima di assegnare. Un valore non positivo in una qualsiasi delle sei dimensioni numeriche solleva subito un'eccezione, e MaxDecodedBytes sopra High(Integer) viene rifiutato come superamento dei limiti di piattaforma invece di essere troncato in silenzio da qualche parte in fondo a un decoder. Conta più di quanto sembri: un budget costruito da un file di config con una chiave mancante ti dà degli zero, e un soffitto a zero sugli oggetti accettato all'avvio diventa un fallimento di parse incomprensibile sul primo documento tre ore dopo, quando ormai nessuno sospetta la config. La stessa cura vale per qualsiasi codice che stringe il budget temporaneamente, test inclusi. La policy è di processo, quindi lasciare installata una scadenza da 4 secondi dopo che un fixture ha finito avvelena tutti quelli successivi; salva e ripristina attorno alla modifica
var
  Saved: TPdfParserResourceBudget;
begin
  Saved := GetPdfParserResourceBudget;
  try
    ApplyUntrustedIntakeBudget;
    ProcessInboundDocument(FileName);
  finally
    ConfigurePdfParserResourceBudget(Saved);
  end;
end;
ResetPdfParserResourceBudget è la versione più brutale, che ripristina TPdfParserResourceBudget.Default direttamente. Usala nel teardown dei test dove vuoi uno stato noto, e usa salva-e-ripristina nel codice di produzione, dove lo stato a cui devi tornare è quello che l'applicazione host ha configurato all'avvio
Dove il budget smette di aiutare
È una singola policy di processo, e questa è la sua limitazione principale. Non puoi dare a un worker thread un profilo stretto e a un altro uno permissivo, perché c'è un solo record dietro una sola critical section; se ti servono davvero limiti per tenant, la forma che funziona è serializzare ogni classe di policy sul suo processo, oppure delimitare il lavoro con salva-e-ripristina accettando che la delimitazione sia sicura solo quando nessun altro sta facendo parse in concorrenza. Limita anche il parsing, non il rendering: la memoria di rasterizzazione, la crescita della cache dei font e la decodifica delle immagini stanno fuori da queste sette dimensioni e hanno bisogno dei loro controlli. E un budget ti dice che un'operazione è costata troppo, mai perché. Il soffitto che è scattato è il sintomo, e l'array /Index malformato o la catena di filtri scatenata dietro di esso vanno comunque diagnosticati a mano, ed è per questo che il percorso di decodifica descritto in decodifica di object stream e predictor vale la pena capirlo prima di cominciare a muovere numeri. Tratta il budget come la cosa che impedisce a un documento cattivo di trascinare giù il processo con sé, e tieni i tuoi log abbastanza buoni da scoprire cosa stava facendo il documento
L'intera superficie API del parser, il record del budget e una build dal codice sorgente per Delphi, C++Builder e Lazarus sono sulla pagina prodotto: PDFium Component