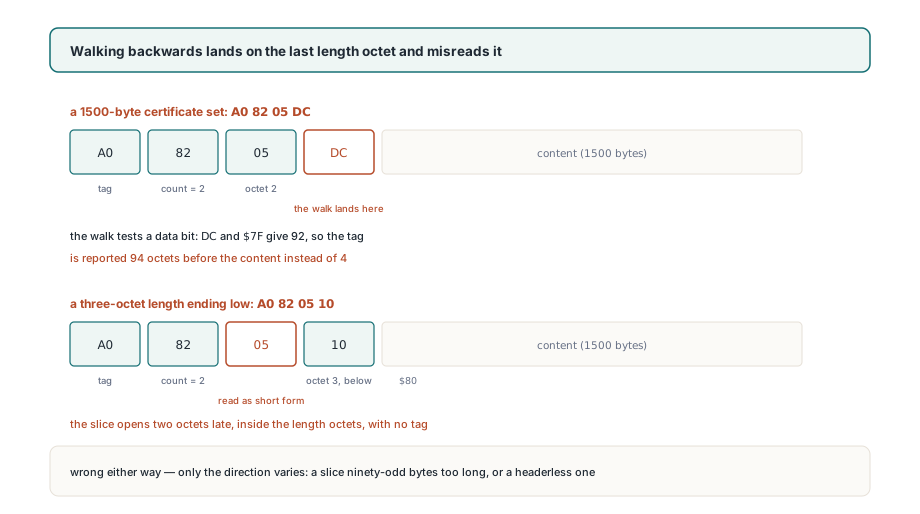
I quattro byte A0 82 05 DC aprono un elemento [0] context-specific che trasporta 1500 byte di contenuto. Letti da sinistra a destra sono inequivocabili: tag A0, un octet di lunghezza iniziale 82 che annuncia due altri, poi 05 DC. Letti da destra a sinistra, partendo dal primo byte di contenuto, il primo octet che incontrate è DC. Il suo bit alto è a uno e i suoi sette bit bassi dicono 92, così un helper che ci si fida riferisce il tag 94 byte prima del contenuto. La distanza vera è 4
Nessuno cammina a ritroso apposta. Succede perché la maggior parte dei reader DER restituisce l'offset e la lunghezza del contenuto di ogni elemento, che è esattamente ciò che serve per scendere dentro, mentre copiare un elemento fratello alla lettera richiede l'offset del suo tag. Sottrarre dall'offset del contenuto sembra un lavoro da due righe, e resta corretto finché ogni lunghezza sta in un solo octet. La lunghezza di un vero insieme di certificati non sta mai in uno
Cosa fa un timestamp di firma a un CMS già firmato
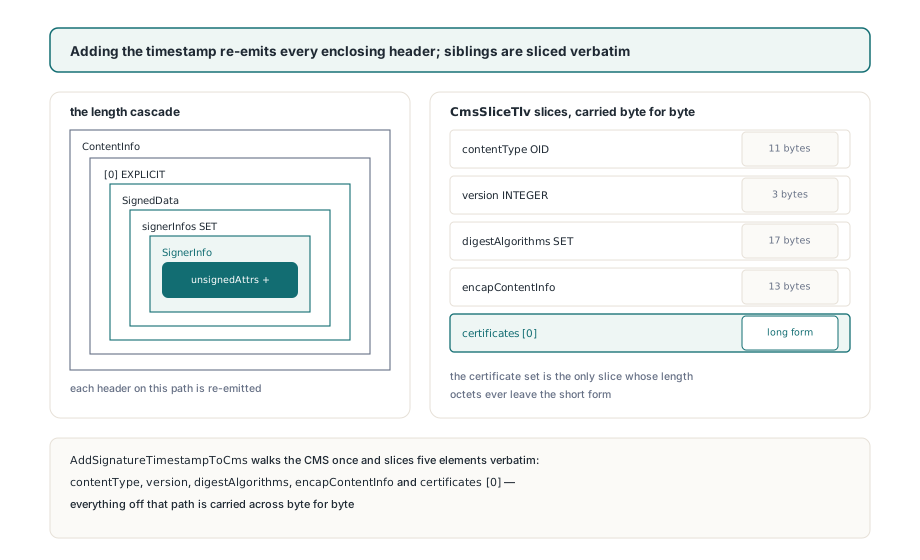
Aggiungere un timestamp PAdES B-T obbliga a ricodificare ogni header che racchiude il CMS mentre cinque elementi fratelli devono attraversare byte per byte. L'attributo signature-time-stamp che la clausola 5.3 di ETSI EN 319 122-1 definisce sotto l'OID 1.2.840.113549.1.9.16.2.14 vive negli unsignedAttrs del SignerInfo della clausola 5.3 di RFC 5652, e il token RFC 3161 dentro di esso viene calcolato sul valore della firma. Quindi il CMS è già costruito e già firmato quando il token arriva dalla TSA. Un attributo in più allunga il SignerInfo, che allunga il SET signerInfos, poi SignedData, poi il wrapper EXPLICIT [0], poi il ContentInfo esterno
Nel PDFium Component quella sequenza è tre chiamate esportate in FPdfCms.pas e FPdfTsa.pas. SignPadesBytes le esegue per voi quando TPadesSignOptions.Level è plB_T o superiore e TsaUrl è impostato, e solleva EPadesCrypto quando viene richiesto un livello B-T con TsaUrl vuota invece di scrivere una firma B-B semplice. Se costruite il CMS da voi con BuildSignedData, la catena appare così
// CmsDer contiene il ContentInfo restituito da BuildSignedData.
// SignPadesBytes esegue gli stessi tre passi quando Options.Level >= plB_T
var
  SigValue: TBytes;
  Ts: TPadesTimestamp;
begin
  if not ExtractSignatureValue(CmsDer, SigValue) then
    raise Exception.Create('CMS carries no signature value');
  // Il messageImprint della TSA viene calcolato sugli octet del valore di firma
  Ts:= RequestTimestamp(TsaUrl, SigValue, Nonce);
  // Ricodifica da SignerInfo fino a ContentInfo, copia i fratelli alla lettera
  AddSignatureTimestampToCms(CmsDer, Ts.TokenDer);
end;
AddSignatureTimestampToCms porta attraverso intatti cinque elementi: l'OID contentType, l'INTEGER version di SignedData, il SET digestAlgorithms, la SEQUENCE encapContentInfo e, quando presente, l'insieme certificates [0]. Nel CMS che BuildSignedData emette con SHA-256, quattro di quelli sono minuscoli: 11 byte per l'OID, 3 per la versione, 17 per l'insieme degli algoritmi di digest, 13 per l'encapContentInfo detached. L'insieme dei certificati contiene il certificato del firmatario seguito da ogni certificato di catena che gli avete passato. Un vero certificato X.509 arriva a parecchie centinaia di byte. È l'unico ritaglio i cui octet di lunghezza usano sempre la forma lunga
Perché gli octet di lunghezza DER non si possono percorrere a ritroso?
Il numero di octet di lunghezza è memorizzato nel primo di essi, e un percorso a ritroso incontra per primo l'ultimo. La clausola 8.1.3.4 di X.690 definisce la forma breve: un octet, bit 8 a zero, bit da 7 a 1 che contengono una lunghezza da 0 a 127. La clausola 8.1.3.5 definisce la forma lunga. Il suo octet iniziale ha il bit 8 a uno, e i bit da 7 a 1 contano gli octet successivi che portano la lunghezza come intero unsigned big-endian. Nulla marca un octet successivo come successivo. Il suo bit 8 è un bit di grandezza come gli altri sette. Così un helper che testa il bit alto di Buf[ContentOffs- 1] sta testando un dato e poi leggendo un dato come un conteggio
// L'helper allettante, a cui viene dato solo l'offset del contenuto. Non spedite questo
function NaiveHeaderStart(const Buf: TBytes; ContentOffs: Integer): Integer;
var
  P, LenByte: Integer;
begin
  P:= ContentOffs- 1;            // atterra sull'ULTIMO octet di lunghezza
  if P< 0 then
    Exit(ContentOffs);
  LenByte:= Buf[P];
  if (LenByte and $80)= 0 then   // significativo solo per il PRIMO
    Result:= P- 1
  else
    Result:= P- (LenByte and $7F)- 1;
end;

// A0 82 05 DC (1500 byte): Buf[ContentOffs- 1]= $DC, $DC and $7F= 92
//   Result= ContentOffs- 94, il tag sta a ContentOffs- 4
// A0 82 05 10 (1296 byte): $10 ha il bit 8 a zero, letto come forma breve
//   Result= ContentOffs- 2, che punta a 05 dentro gli octet di lunghezza
Entrambe le direzioni di fallimento compaiono con dimensioni ordinarie. Un insieme di certificati da 1500 byte chiude la sua intestazione con DC, e l'helper fa partire il ritaglio 90 byte troppo presto. Un insieme da 1296 byte chiude con 10, l'helper lo prende per una lunghezza in forma breve, e il ritaglio parte due byte in ritardo senza alcun tag. Se una data catena cade nel primo o nel secondo caso dipende da niente più che dal byte basso della sua lunghezza totale
Il caso precoce può anche uscire dalla parte anteriore del buffer. Per un CMS disposto come lo dispone BuildSignedData, con ogni lunghezza racchiudente su due octet, il contenuto dell'insieme dei certificati comincia a 60 byte dall'inizio: 4 per l'header del ContentInfo, 11 per l'OID, 4 ciascuno per gli header di [0] e SignedData, poi 3, 17 e 13 per i fratelli piccoli e 4 per l'header dell'insieme dei certificati. Sottraete 94 da 60 e l'helper restituisce -34. La sua unica guardia sta su ContentOffs- 1, così il risultato negativo va dritto nella copia
Cosa fissa la clausola 10.1 di X.690
DER rende la codifica della lunghezza una funzione pura della lunghezza. La clausola 10.1 di X.690 restringe DER alla forma definita e richiede il numero minimo di octet, il che elimina le due libertà che BER concede: la forma indefinita, e una lunghezza in forma lunga riempita con octet zero iniziali. Sotto quella regola una lunghezza di contenuto sotto 128 prende sempre esattamente un octet di lunghezza. Qualunque altra lunghezza prende un octet iniziale più esattamente tanti octet successivi quanti sono i byte significativi del valore. Questo dà 81 80 per 128. A 256 l'header cresce a 82 01 00, e 65536 richiede 83 01 00 00. Il codice che ha già la lunghezza del contenuto può calcolare la dimensione dell'header senza leggere un solo byte del buffer
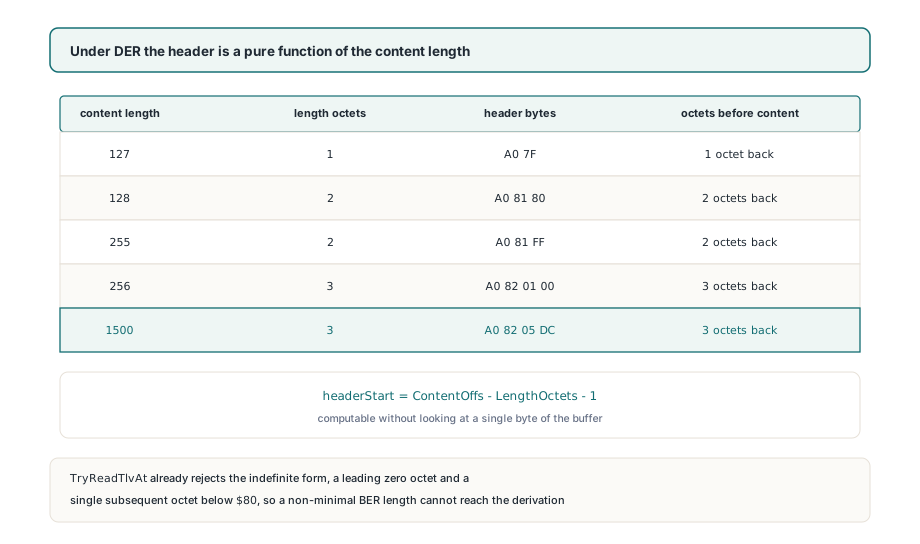
La derivazione vale quanto l'affermazione che l'input sia davvero DER. TDerReader.TryReadTlvAt impone quell'affermazione prima di qualunque ritaglio. Rifiuta un octet di lunghezza iniziale $80 (la forma indefinita), una lunghezza in forma lunga il cui primo octet successivo è zero, un singolo octet successivo sotto $80 che doveva essere una forma breve, e più di quattro octet successivi. ReadTlv è costruito su TryReadTlvAt, così ogni elemento che AddSignatureTimestampToCms percorre ha già superato quei controlli. Una lunghezza riempita in stile BER non raggiunge mai l'aritmetica
Dentro AddSignatureTimestampToCms l'offset del tag di ogni fratello viene derivato dal suo offset e dalla sua lunghezza di contenuto in questo modo. Quando l'inizio derivato cade prima dell'inizio del buffer, a significare che gli offset non possono stare insieme, la procedura solleva un'eccezione con il messaggio CMS: TLV header precedes the buffer start e non produce alcun CMS. Una ricostruzione malformata che valida comunque è molto più difficile da tracciare di un'eccezione nel punto in cui gli offset hanno smesso di essere d'accordo
La derivazione porta con sé un'ulteriore assunzione: l'identificatore occupa un solo octet. X.690 consente identificatori multi-octet per i numeri di tag da 31 in su, e TryReadTlvAt li analizza. Il SignedData del CMS non ne usa mai uno, dato che i suoi tag sono SEQUENCE, SET, INTEGER e OID universali più i context-specific [0] e [1], così l'assunzione vale per ogni elemento che la ricostruzione del timestamp tocca
Copiare gli elementi fratelli nel vostro codice DER
Se scrivete codice contro TDerReader, saltate del tutto la derivazione. PeekTlv e ReadNextTlv riempiono un record TDerTlv il cui Offset punta già al tag e il cui HeaderLength è la dimensione misurata di tag più octet di lunghezza, e EncodedBytes restituisce l'elemento da Offset a NextOffset. Quel percorso regge anche gli identificatori multi-octet, che nessuna aritmetica sulle lunghezze può recuperare. Il ReadTlv a quattro parametri di output è comodo per scendere. Riporta però solo il lato contenuto, quindi usatelo quando vi serve il contenuto e la forma a record quando vi serve l'elemento intero
// Ogni figlio di SignedData come TLV completo: tag, octet di lunghezza, contenuto.
// TDerTlv.Offset punta al tag, quindi nessuna aritmetica sugli header
function SignedDataChildren(const CmsDer: TBytes): TDerByteArrays;
var
  Root, Ci, Explicit0, Sd: TDerReader;
  Tlv: TDerTlv;
begin
  Result:= nil;
  Root.Initialize(CmsDer);
  if not Root.ReadNextTlv(Tlv) or not Root.EnterConstructed(Tlv, Ci) then
    raise Exception.Create('ContentInfo SEQUENCE expected');
  if not Ci.SkipTlv then                            // OID contentType
    raise Exception.Create('contentType OID expected');
  if not Ci.ReadNextTlv(Tlv) or not Ci.EnterConstructed(Tlv, Explicit0) then
    raise Exception.Create('[0] EXPLICIT content expected');
  if not Explicit0.ReadNextTlv(Tlv) or not Explicit0.EnterConstructed(Tlv, Sd) then
    raise Exception.Create('SignedData SEQUENCE expected');
  while not Sd.AtEnd do
  begin
    if not Sd.ReadNextTlv(Tlv) then
      raise Exception.Create('SignedData child malformed');
    SetLength(Result, Length(Result)+ 1);
    Result[High(Result)]:= Sd.EncodedBytes(Tlv);   // ad esempio A0 82 05 DC ...
  end;
end;
Per i casi in cui qualche altra API vi dà nient'altro che un offset di contenuto e una lunghezza, la derivazione in avanti è corta. DerHeaderStart, mostrato col suo controllo sui confini nella prossima sezione, è codice vostro; rispecchia la regola della clausola 10.1 e restituisce -1 per gli offset che non possono essere coerenti, così chi chiama ha un valore che può rifiutare invece di un byte di inizio dall'aspetto plausibile
Perché i certificati di test corti nascondono l'errore?
Un certificato segnaposto piccolo tiene l'insieme dei certificati in forma breve, e il percorso a ritroso è corretto esattamente per quel caso. Un insieme da 32 byte si codifica A0 20 e uno da 64 byte A0 40. Tornando indietro dal contenuto si atterra su quell'unico octet di lunghezza, e il suo bit alto è a zero perché è il primo e unico. Risposta giusta, motivo sbagliato. Un test sul timestamp costruito su certificati così piccoli può riparcolare il risultato, trovare l'attributo, riferire B-T, e non spingere mai un insieme di certificati di dimensioni realistiche attraverso il ritaglio
Qualunque percorso di codice che dipenda da come è codificata una lunghezza richiede input di test che attraversi il confine di codifica. Per DER significa contenuti da 128 byte o più, che forzano la forma lunga, e da 256 byte o più, che forzano un secondo octet successivo. Il controllo qui sotto confronta DerHeaderStart con l'header che il reader ha misurato mentre analizzava, a entrambi i confini e al caso da 1500 byte dell'apertura. Un SET OF non ordinato in signedAttrs scivola oltre i round trip sulla stessa origine per la stessa ragione strutturale: il test somministra solo input su cui codice sbagliato e codice giusto sono d'accordo
// Il vostro helper per le API che riferiscono solo offset e lunghezza del contenuto.
// Presuppone un identificatore di un octet, vero per ogni tag in CMS SignedData
function DerHeaderStart(ContentOffs, ContentLen: Integer): Integer;
var
  LengthOctets, Remaining: Integer;
begin
  LengthOctets:= 1;                  // forma breve, X.690 8.1.3.4
  if ContentLen>= 128 then
  begin
    Remaining:= ContentLen;          // forma lunga, X.690 8.1.3.5
    while Remaining> 0 do
    begin
      Inc(LengthOctets);             // uno per byte significativo
      Remaining:= Remaining shr 8;
    end;
  end;
  Result:= ContentOffs- LengthOctets- 1;
  if Result< 0 then
    Result:= -1;                     // offset incoerenti: lasciate sollevare chi chiama
end;

// Controllo sui confini, scritto come codice di test vostro: l'offset del tag derivato
// deve eguagliare quello che TDerReader ha misurato analizzando l'header
procedure CheckHeaderDerivation;
const
  Lens: array[0..6] of Integer= (127, 128, 255, 256, 1500, 65535, 65536);
var
  W: TDerWriter;
  R: TDerReader;
  Tlv: TDerTlv;
  Content: TBytes;
  I: Integer;
begin
  W:= TDerWriter.Create;
  try
    for I:= Low(Lens) to High(Lens) do
    begin
      SetLength(Content, Lens[I]);
      R.Initialize(W.Wrap($A0, Content));   // A0 7F / A0 81 80 / A0 82 05 DC ...
      W.Clear;
      if not R.PeekTlv(Tlv) then
        raise Exception.CreateFmt('unreadable TLV for %d bytes', [Lens[I]]);
      if DerHeaderStart(Tlv.ContentOffset, Tlv.ContentLength)<> Tlv.Offset then
        raise Exception.CreateFmt('header start wrong for %d bytes', [Lens[I]]);
    end;
  finally
    W.Free;
  end;
end;
Lo stesso confine è raggiungibile da cima a fondo attraverso le funzioni esportate. Consegnate a BuildSignedData certificati di catena la cui dimensione combinata mette l'insieme dei certificati appena sotto e appena sopra 128 e 256 byte, eseguite AddSignatureTimestampToCms su ogni risultato, poi percorrete l'output con SignedDataChildren e confrontate l'elemento dell'insieme dei certificati byte per byte con quello nel CMS prima che il timestamp fosse aggiunto
Ciò che AddSignatureTimestampToCms accetta
AddSignatureTimestampToCms è scritto per il CMS che BuildSignedData emette: un SignerInfo, un insieme opzionale certificates [0], niente crls [1] e ancora niente unsignedAttrs. Consegnateli un SET signerInfos con più di un SignerInfo e solleva un'eccezione invece di tenere il primo firmatario e buttare gli altri. Un CMS che porta un insieme crls [1] si ferma all'eccezione CMS: signerInfos SET expected, perché l'elemento dopo i certificati non è il SET che il percorso cerca. Entrambi i rifiuti avvengono prima che qualcosa venga scritto indietro in CmsDer
I nuovi unsignedAttrs contengono esattamente un attributo, così la regola di ordinamento SET OF della clausola 11.6 di X.690 è soddisfatta senza sort. La parte firmata del SignerInfo, dalla sua versione fino all'OCTET STRING della firma, viene copiata come un blocco, il che significa che un validatore che ricalcola il digest dei signedAttrs vede gli stessi byte prima e dopo l'aggiunta del token. Quando un validatore rifiuta comunque il documento, le cause di solito stanno altrove e sono trattate in questa checklist dei motivi di rifiuto PAdES. Cosa vi compra il token nel tempo, e come B-LT e B-LTA ci si costruiscono sopra, sta nel percorso sui timestamp RFC 3161 e il DSS
Il reader e il writer DER in FPdfAsn1.pas, il costruttore CMS e il passo del timestamp in FPdfCms.pas sono tutti sorgente Pascal che arriva con il PDFium Component per Delphi. Quando un SignedData ricostruito rifiuta di validarsi in un validatore, potete fare step nel codice che ha ritagliato ogni elemento e controllarlo contro la clausola di X.690 che cita