Una sessione di scansione a fogli ti lascia una cartella di JPEG, uno per pagina, nominati 0001.jpg, 0002.jpg e così via. Nessuno vuole rileggere un fascicolo cliccando tra centinaia di miniature d'immagine; ciò che serve all'archivio è un PDF per fascicolo con le pagine in ordine. Quell'ultimo passaggio, trasformare una pila numerata di scansioni in un singolo PDF ordinato, è il lavoro di questo articolo
PDFium Component lo gestisce direttamente. Oltre al rendering e all'estrazione del testo, il componente può creare un PDF da zero: creare un documento vuoto, aggiungere una pagina vuota delle dimensioni desiderate, rilasciare un'immagine su quella pagina nelle coordinate dello spazio utente, quindi salvare. L'intera pipeline vive sul componente TPdf, quindi un convertitore batch è un ciclo sui nomi dei file più una manciata di chiamate
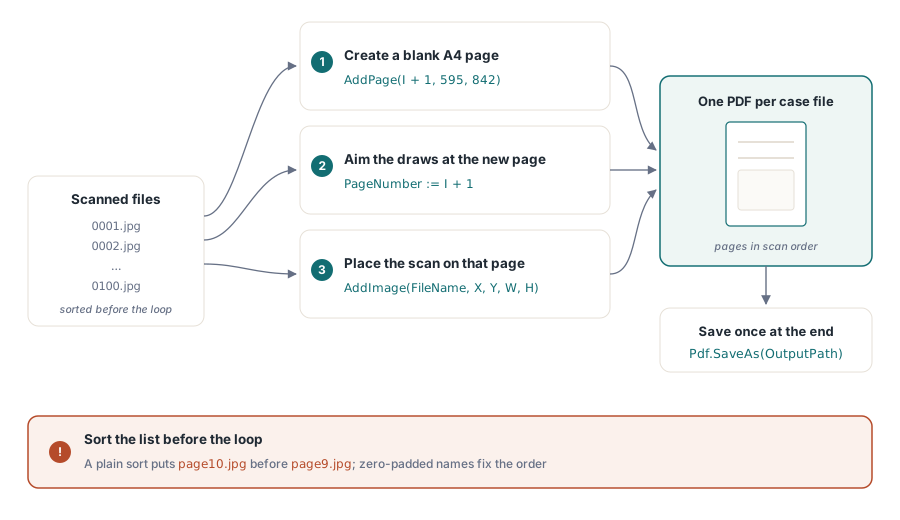
La forma della conversione
Per ogni scansione devono accadere tre cose. Decidi le dimensioni della pagina, posizioni l'immagine all'interno della pagina lasciando un margine e avanzi alla pagina successiva. PDFium Component ti offre un metodo per ciascuna: AddPage crea una pagina vuota di una determinata dimensione, AddImage (o AddPicture se possiedi già un TPicture) disegna la bitmap nella pagina corrente e PageNumber dice al componente a quale pagina mirano le successive chiamate di disegno
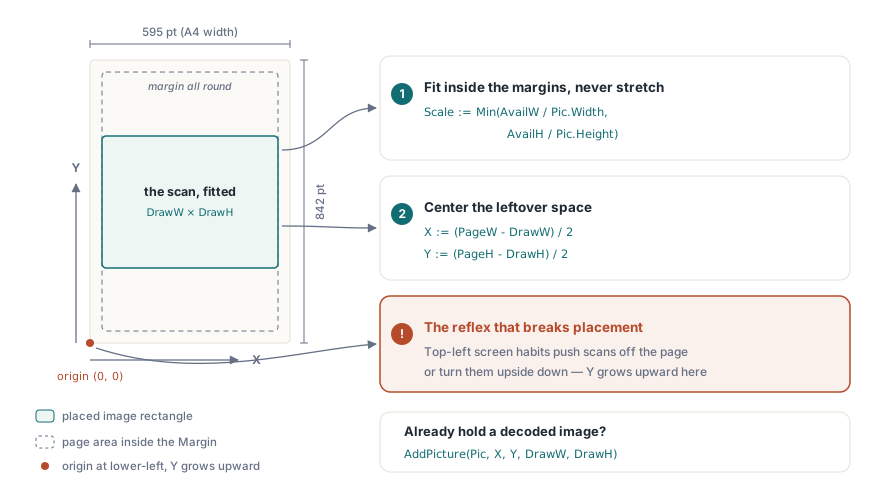
L'unico dettaglio che fa inciampare le persone è il sistema di coordinate. Lo spazio utente del PDF posiziona l'origine nell'angolo in basso a sinistra della pagina, con la Y che aumenta verso l'alto, l'opposto delle coordinate dello schermo a cui gli sviluppatori Delphi ricorrono per riflesso. La X, Y che passi a AddImage è l'angolo in basso a sinistra del rettangolo dell'immagine e Width, Height sono le dimensioni di posizionamento in punti, non la dimensione in pixel del file di origine. Sbaglia e le tue scansioni finiranno fuori dalla pagina o capovolte rispetto a dove ti aspettavi
Creazione del documento e di una pagina per scansione
Inizia con un documento vuoto. CreateDocument alloca un nuovo PDF e lascia il componente attivo, quindi non c'è nessun passaggio di apertura separato. Da lì percorri l'elenco dei file scansionati e per ognuno aggiungi una pagina, la rendi corrente e posizioni l'immagine. Le dimensioni della pagina qui sono A4 in punti (595 × 842 verticale), il formato foglio standard per la corrispondenza archiviata:
procedure TArchiveForm.ScansToPdf(const Files: TStrings; const OutputPath: string);
const
  PageW = 595.0;   // larghezza A4 in punti
  PageH = 842.0;   // altezza A4 in punti
  Margin = 36.0;   // bordo di mezzo pollice attorno a ogni scansione
var
  I: Integer;
  Pdf: TPdf;
begin
  Pdf := TPdf.Create(nil);
  try
    Pdf.CreateDocument;                       // nuovo, vuoto, già attivo
    for I := 0 to Files.Count - 1 do
    begin
      Pdf.AddPage(I + 1, PageW, PageH);       // indice di pagina basato su 1
      Pdf.PageNumber := I + 1;                // rende corrente la nuova pagina
      PlaceScan(Pdf, Files[I], PageW, PageH, Margin);
    end;
    Pdf.SaveAs(OutputPath);
  finally
    Pdf.Free;
  end;
end;
Ogni iterazione crea una pagina e ne imposta immediatamente il PageNumber. Quella seconda riga è importante: AddPage inserisce la pagina ma i metodi di disegno agiscono su qualsiasi pagina sia corrente, quindi l'impostazione di PageNumber è ciò che indirizza AddImage alla pagina che hai appena creato. Saltalo e le tue immagini si impileranno su qualsiasi pagina fosse caricata prima
In quel ciclo si nasconde un presupposto: l'ordine dei Files. Uno scanner nomina le pagine da 0001.jpg a 0100.jpg, ma l'enumerazione di una directory non sempre le restituisce ordinate, e nel momento in cui incontri page9.jpg accanto a page10.jpg, un semplice ordinamento di stringhe (string sort) posiziona la pagina 10 prima della pagina 9. Ordina l'elenco esplicitamente prima del ciclo e preferisci i nomi con zeri riempitivi (zero-padded) al momento della scansione in modo che l'ordine lessicale corrisponda all'ordine delle pagine. La sequenza delle pagine è l'unica cosa che un revisore nota immediatamente ed è l'errore più economico da prevenire
Posizionamento di una scansione e mantenimento del suo rapporto di aspetto (aspect ratio)
Una scansione raramente ha la stessa forma della pagina. Se la allunghi per riempire il foglio distorci il testo; se la posizioni alla dimensione in pixel completa, straborda. La soluzione è scalare in base al minore dei due rapporti, adattamento della larghezza o adattamento dell'altezza, e centrare ciò che rimane. Poiché l'origine si trova in basso a sinistra, centrare significa dividere equamente lo spazio rimanente e aggiungerlo sia a X che a Y
procedure TArchiveForm.PlaceScan(Pdf: TPdf; const FileName: string;
  PageW, PageH, Margin: Double);
var
  Pic: TPicture;
  AvailW, AvailH, Scale, DrawW, DrawH, X, Y: Double;
begin
  Pic := TPicture.Create;
  try
    Pic.LoadFromFile(FileName);              // BMP, JPG, PNG, ecc. tramite le unità grafiche della VCL

    AvailW := PageW - 2 * Margin;
    AvailH := PageH - 2 * Margin;

    // Adatta all'interno dei margini senza distorcere la scansione.
    Scale := Min(AvailW / Pic.Width, AvailH / Pic.Height);
    DrawW := Pic.Width * Scale;
    DrawH := Pic.Height * Scale;

    // Centra: spazio rimanente diviso uniformemente. Y misurata dal fondo della pagina.
    X := (PageW - DrawW) / 2;
    Y := (PageH - DrawH) / 2;

    Pdf.AddImage(FileName, X, Y, DrawW, DrawH);
  finally
    Pic.Free;
  end;
end;
Questo carica il file una volta per leggere le sue dimensioni in pixel, calcola una singola scala uniforme e passa il rettangolo di posizionamento ad AddImage. AddImage accetta direttamente il percorso di un file e lo instrada attraverso la stessa pipeline di immagini di AddPicture, quindi qualsiasi formato che le unità grafiche della VCL riconoscono funziona senza casi speciali. Se possiedi già l'immagine decodificata in una TPicture da un riquadro di anteprima, chiama AddPicture(Pic, X, Y, DrawW, DrawH) con lo stesso rettangolo e salta la seconda lettura del file
Saltare la decodifica per le scansioni JPEG
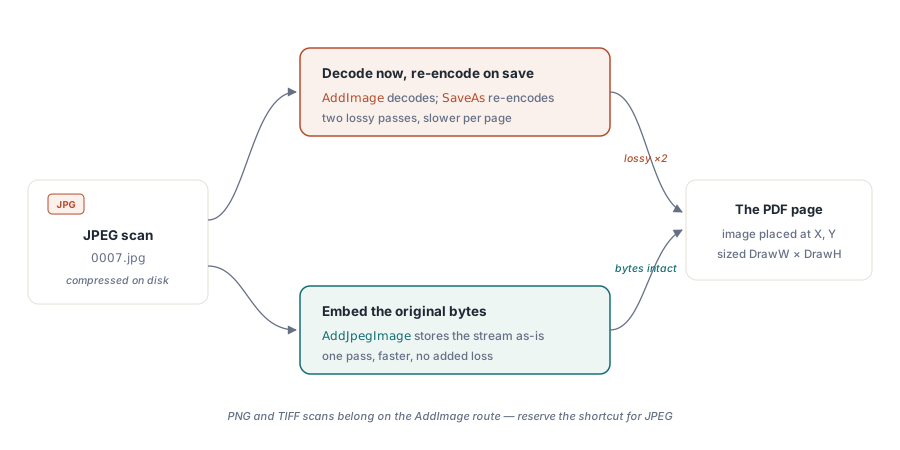
Gli scanner emettono quasi sempre JPEG. Il caricamento di un JPEG in una TPicture lo decodifica in una bitmap completa, ed è quella bitmap a finire nel PDF. La decodifica non costa qualità e PDFium memorizza i pixel senza perdita, quindi la pagina appare identica; ciò che paghi è dimensione e tempo, perché una scansione arrivata come JPEG compatto viene riscritta come pixel grezzi compressi senza perdita, di norma molto più grandi del file di origine. AddJpegImage incorpora i byte originali compressi direttamente nella pagina da uno stream, così l'output resta vicino alla dimensione delle scansioni e il batch salta del tutto il lavoro di decodifica
var
  Stream: TFileStream;
begin
  // ... dopo AddPage + PageNumber per la pagina corrente ...
  Stream := TFileStream.Create(FileName, fmOpenRead);
  try
    // Incorpora i byte JPEG così come sono; nessun ciclo decodifica/ricodifica.
    Pdf.AddJpegImage(Stream, X, Y, DrawW, DrawH);
  finally
    Stream.Free;
  end;
end;
Calcoli ancora X, Y, DrawW e DrawH allo stesso modo, poiché ti servono le dimensioni in pixel per la scalatura. Leggile dal file o con una rapida analisi dell'intestazione, quindi passa lo stream grezzo (raw stream) a AddJpegImage. Per scansioni PNG o TIFF il percorso AddImage è quello corretto; riserva la scorciatoia JPEG per il formato a cui si applica effettivamente
Etichettare ogni pagina
Le scansioni archiviate sono più facili da controllare quando ogni pagina porta il suo nome di file di origine. AddText disegna una stringa a una coordinata nello spazio utente, in modo che una didascalia si trovi appena sotto l'immagine. Ricorda l'asse Y invertito: per mettere un'etichetta sotto la scansione, sottrai dal bordo inferiore dell'immagine piuttosto che aggiungere a esso:
// Didascalia sotto la scansione: Y diminuisce verso il fondo della pagina.
Pdf.AddText('File: ' + ExtractFileName(FileName), 'Helvetica', 9,
  X, Y - 14, clGray);
Un ultimo punto sul salvataggio. SaveAs restituisce un booleano, e False significa che il documento non è stato serializzato, quindi controllane il risultato invece di dare per buona la scrittura. I guai del file system prendono un'altra strada: una cartella di output mancante o un file di destinazione bloccato sollevano un'eccezione dal livello file, quindi un job batch vuole sia il controllo del risultato sia un handler che registri quale fascicolo è fallito. Una volta terminato il ciclo e scritto il file, hai esattamente ciò di cui l'archivio aveva bisogno: un PDF ordinato per fascicolo, pagine ridimensionate per adattarsi, pronto da leggere in qualsiasi visualizzatore
Gli stessi blocchi costitutivi coprono lavori correlati. Scambia la regola di ridimensionamento per pagina e otterrai un fotolibro con un'immagine per foglio; mantieni il ciclo ma leggi da un'origine multipagina TIFF e otterrai un convertitore di archivio fax. Se vuoi un quadro più ampio della creazione di PDF a livello di codice, vedi la creazione di documenti PDF da zero con PDFium Component; per renderizzare nuovamente il risultato su schermo in seguito, vedi la conversione di pagine PDF in immagini JPEG con PDFium Component
PDFium Component da loslab.com raggruppa le API di creazione di documenti, rendering e testo utilizzate in questa serie