Aprite lo stesso PDF di una fattura su Windows e su un telefono, e i ritorni a capo, i font e il logo cadono in punti identici. Un file PDF è un insieme di oggetti numerati più un indice di offset di byte, e un lettore come il motore PDFium dentro PDFium Component lo apre dalla fine: startxref, tabella xref, catalog, page tree, content stream, poi pixel
Che cosa è allora un file PDF, e perché appare uguale ovunque? I documenti Word e RTF conservano testo e stili e lasciano il layout alla macchina che li apre, così un font mancante o un driver di stampa diverso riorganizza le pagine. Il PDF conserva invece il risultato finito. Ogni glifo e ogni riga ha una posizione assoluta in uno spazio di coordinate misurato in punti, i programmi dei font viaggiano dentro il file, e le immagini portano con sé i propri dati di colore e i propri filtri di compressione. Nulla viene impaginato al momento della visualizzazione, ed è per questo che qualsiasi renderer conforme su qualsiasi sistema operativo dipinge la stessa pagina. Il formato è nato come PDF 1.0 con Acrobat nel 1993, costruito sul modello di immagine di PostScript, e ogni revisione ha aggiunto un pezzo della macchinaria descritta qui sotto:
- PDF 1.1 fino a 1.4 ha portato cifratura, form interattivi, firme digitali con struttura logica e trasparenza
- PDF 1.5 ha aggiunto object stream e cross-reference stream; PDF 1.6 ha aggiunto la cifratura AES
- PDF 1.7 è diventato ISO 32000-1:2008, e PDF 2.0 è diventato ISO 32000-2:2017, revisionato nel 2020
- PDF/A (ISO 19005), PDF/X (ISO 15930) e PDF/UA (ISO 14289) restringono quella base per archiviazione, produzione tipografica e accessibilità
Che cosa succede quando un lettore apre un file PDF?
Aprire un PDF è una catena di ricerche che inizia agli ultimi byte del file e finisce con una bitmap. Quasi ogni anello della catena è un dizionario, uno dei tipi di oggetto di base dell'ISO 32000-1 §7.3, e i dizionari si puntano a vicenda con riferimenti indiretti come 7 0 R (oggetto 7, generazione 0). Il file si comporta quindi come un grafo di oggetti anziché come una sequenza di pagine. Header, corpo, tabella dei riferimenti incrociati e trailer sono descritti nella panoramica della struttura di un file PDF, e un PDF minimo annotato riga per riga mostra come appaiono obj, endobj e stream in un editor di testo. Ecco l'ordine che ogni lettore segue
- Andate alla fine del file e leggete l'offset di byte scritto dopo la parola chiave
startxref - Caricate i dati di riferimenti incrociati a quell'offset, che mappa ogni numero di oggetto a una posizione nel file
- Leggete il trailer e seguite
/Rootfino al catalogo del documento - Seguite la voce
/Pagesdel catalogo giù per l'albero delle pagine fino all'oggetto pagina richiesto - Decodificate il content stream della pagina e interpretate i suoi operatori in ordine
- Risolvete i font, le immagini e i form XObject che quegli operatori nomina tramite
/Resources - Rasterizzate tracciati, contorni dei glifi e immagini in pixel alla risoluzione del dispositivo
Passo uno: startxref e la tabella dei riferimenti incrociati
Un lettore non scansiona mai un PDF dall'inizio. Un file ben formato finisce con la parola chiave startxref, un numero decimale come 48211, e %%EOF, e quel numero è l'offset di byte dei dati di riferimenti incrociati. Una ricerca all'indietro ingenua di xref si ferma dentro startxref, quindi cercate la parola chiave completa. La tabella classica usa voci a larghezza fissa (§7.5.4), il che permette a un lettore di saltare alla voce di qualsiasi numero di oggetto senza interpretare le altre; il layout in byte di ogni voce è trattato nella panoramica della struttura. Il trailer dopo la tabella nomina /Size, /Root e, facoltativamente, /Encrypt, /ID e /Prev
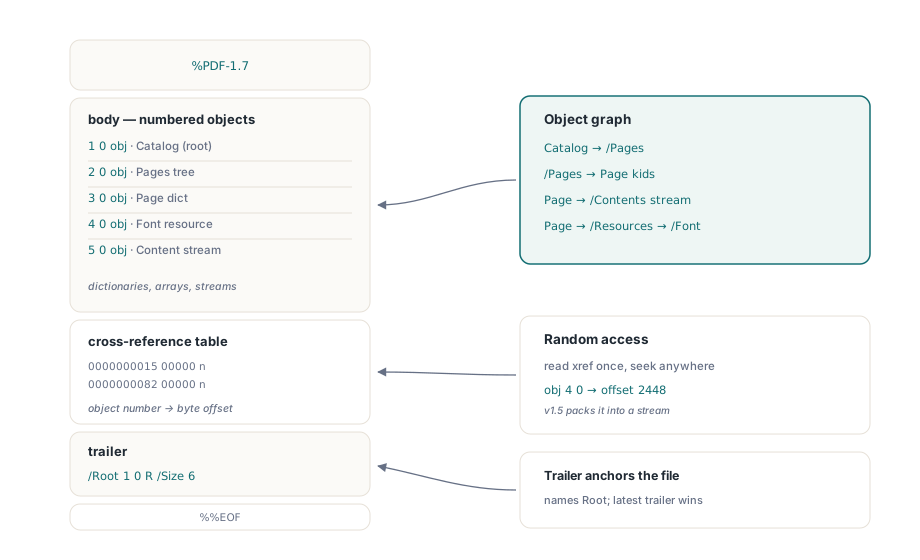
Ogni voce è una posizione di byte assoluta, quindi qualsiasi cosa sposti i byte, come un editor che riscrive i finali di riga, lascia l'indice puntato nei posti sbagliati. I lettori con un passaggio di riparazione lo ricostruiscono scansionando le parole chiave obj; quelli senza lo rifiutano, ed è per questo che un PDF danneggiato può aprirsi in un visualizzatore e fallire in un altro. Ciò che si trova all'offset startxref vi dice in quale caso siete: la parola chiave xref per una tabella classica, una riga N 0 obj per un cross-reference stream di PDF 1.5, e qualsiasi altra cosa per un offset stantio. L'helper qui sotto è codice vostro, costruito su stream RTL semplici
uses
  System.SysUtils, System.Classes;

// Helper di vostra fabbricazione: Offset è il numero scritto dopo startxref.
// Classifica ciò che il lettore troverà a quella posizione
function DescribeXrefAt(const FileName: string; Offset: Int64): string;
var
  FS: TFileStream;
  Buf: TBytes;
  Head: string;
begin
  FS := TFileStream.Create(FileName, fmOpenRead or fmShareDenyWrite);
  try
    if Offset >= FS.Size then
      Exit('offset beyond end of file: the file needs a repair pass');
    FS.Position := Offset;
    SetLength(Buf, 32);
    SetLength(Buf, FS.Read(Buf[0], Length(Buf)));
  finally
    FS.Free;
  end;
  Head := TEncoding.ASCII.GetString(Buf);
  if Head.StartsWith('xref') then
    Result := 'classic cross-reference table'
  else if Head.Contains(' obj') then
    Result := 'cross-reference stream (PDF 1.5 or later)'
  else
    Result := 'stale offset: the file needs a repair pass';
end;
Un cross-reference stream (§7.5.8) è un oggetto compresso con /Type /XRef, un array /W che dà la larghezza in byte di ogni colonna, e righe binarie che puntano o a un offset di byte o dentro un object stream (§7.5.7). Le chiavi del trailer si spostano nel suo dizionario, così il file non ha affatto una parola chiave trailer. HotPDF scrive questa forma quando UseXRefStream è impostato su THotPDF. Per i file che escono dal vostro controllo, come allegati di posta o caricamenti verso tipografie, la tabella classica resta la scelta più sicura, perché i lettori precedenti al PDF 1.5 la sanno ancora interpretare. Il PDF/A-1 chiude la questione per gli archivi: ISO 19005-1 si costruisce sul PDF 1.4, e il suo §6.1.4 dichiara che i cross-reference stream non si devono usare, così HotPDF scrive una tabella classica ogni volta che un profilo PDF/A-1 è attivo
48 0 obj
<< /Type /XRef /Size 49 /Root 1 0 R
   /W [1 3 1] /Index [0 49]
   /Filter /FlateDecode /Length 162 >>
stream
...binary rows: 1 + 3 + 1 bytes each...
endstream
endobj
startxref
48211
%%EOF
Da /Root alla pagina giusta: catalog e page tree
Il /Root del trailer punta al catalogo del documento, e il /Pages del catalogo punta alla radice del page tree. Ogni nodo /Pages intermedio porta un /Count delle pagine foglia sotto di sé, così un lettore in cerca della pagina 5.000 sottrae i conteggi mentre scende e salta interi sottoalberi senza aprirli. L'ISO 32000-1 §7.7.3 non richiede un albero bilanciato; un singolo array /Kids con 10.000 voci è legale, solo più lento da cercare. Il codice che legge solo la foglia cade in una trappola. /Resources, /MediaBox, /CropBox e /Rotate sono ereditabili (§7.7.3.4), così una pagina senza un proprio /MediaBox resta valida perché il valore vive su un antenato
12 0 obj
<< /Type /Page
   /Parent 3 0 R
   /MediaBox [0 0 612 792]
   /Resources << /Font << /F1 7 0 R >> >>
   /Contents 13 0 R
>>
endobj
Il media box stabilisce lo spazio di coordinate per tutto ciò che è disegnato sulla pagina: origine in basso a sinistra, Y che corre verso l'alto, un'unità pari a 1/72 di pollice a meno che un /UserUnit di PDF 1.6 non la scali. PDFium Component compie l'intera discesa quando chiedete una pagina per numero. TPdf.PageMetrics restituisce la dimensione della pagina in punti con i box ereditati già risolti, più la rotazione della pagina, così il listato qui sotto riporta dimensioni corrette anche per i file le cui pagine foglia non portano un box proprio
uses
  System.SysUtils, PDFium;

// Stampa il conteggio delle pagine e la dimensione di ogni pagina in punti
procedure ListPages(const FileName: string);
const
  Degrees: array[TRotation] of Integer = (0, 90, 180, 270);
var
  Pdf: TPdf;
  I: Integer;
  M: TPdfPageMetrics;
begin
  Pdf := TPdf.Create(nil);
  try
    Pdf.FileName := FileName;
    Pdf.Active := True;           // interpreta i dati xref, il trailer e il catalogo
    if not Pdf.Active then        // un caricamento fallito lascia Active = False
      raise Exception.Create('Cannot open ' + FileName);
    Writeln(Pdf.PageCount, ' pages');
    for I := 1 to Pdf.PageCount do
    begin
      M := Pdf.PageMetrics[I];    // base 1; carica la pagina attraverso la gerarchia
      Writeln(Format('Page %d: %.1f x %.1f pt, /Rotate %d',
        [I, M.Width, M.Height, Degrees[M.Rotation]]));
    end;
  finally
    Pdf.Free;
  end;
end;
Come disegna un PDF una pagina su schermo?
Il contenuto visibile di una pagina è un piccolo programma: operatori in notazione postfissa in uno o più content stream, interpretati in ordine dopo che il lettore ha eseguito il decodificatore nominato in /Filter, il più delle volte /FlateDecode. BT apre un oggetto testo, Tf seleziona una risorsa font e una dimensione, Td sposta la posizione del testo, Tj dipinge una stringa, e ET chiude l'oggetto. I tracciati si costruiscono con m, l, c e re, poi si riempiono con f o si tracciano con S. Lo stato grafico (§8.4) conserva ciò che quegli operatori leggono implicitamente, come la matrice di trasformazione, i colori e il tracciato di ritaglio. q impila una copia e Q la spila, così una trasformazione impostata dentro la coppia non può travasare nel contenuto successivo
q
1 0 0 1 72 700 cm     % origine spostata a (72, 700)
BT
  /F1 12 Tf           % risorsa font F1 a 12 punti
  0 0 Td
  (Invoice 2026-0417) Tj
ET
0.2 0.2 0.8 RG        % colore del tratto, delimitato da q/Q
0 -6 m 140 -6 l S
Q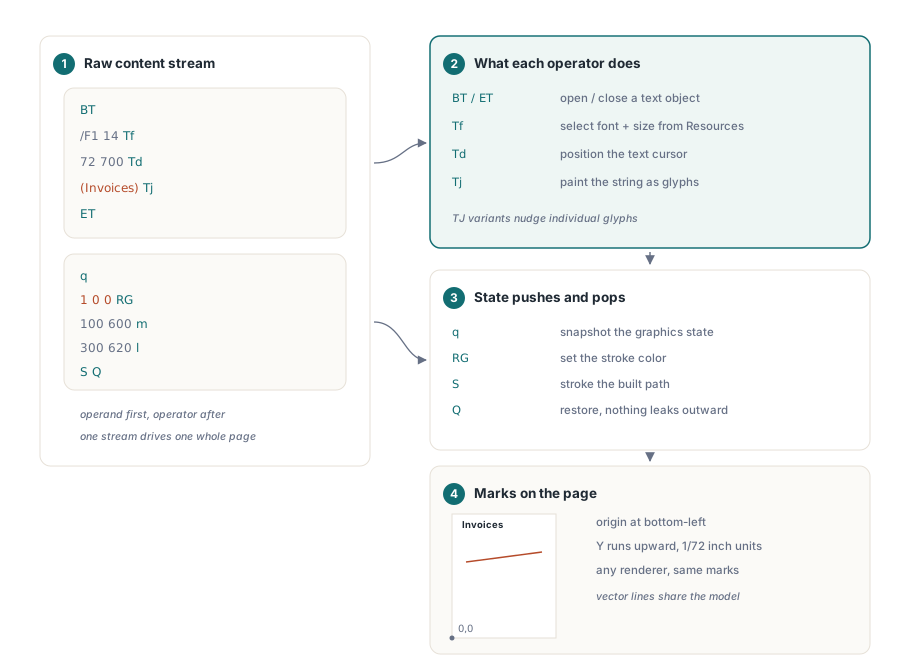
Nomi come /F1 sono chiavi nelle /Resources della pagina. Un dizionario font porta attraverso il suo font descriptor (§9.8) al programma del font incorporato, e un'immagine viene dipinta con un solo Do una volta che i suoi dati JPEG o Flate sono decodificati. La rasterizzazione arriva per ultima. Il renderer applica la matrice di trasformazione a ogni tracciato e a ogni contorno di glifo, mappa i punti in pixel del dispositivo e riempie il risultato con anti-aliasing. Poiché la pagina a quel punto è ancora dati vettoriali, uno zoom al 400 percento riesegue il content stream a una scala maggiore invece di stirare una bitmap. La risoluzione di destinazione la sceglie chi chiama: 96 o 150 pixel per pollice per uno schermo, 300 o più per la stampa. In PDFium Component quella fase è TPdf.RenderPage, che prende la dimensione di output in pixel
uses
  System.SysUtils, Vcl.Graphics, PDFium;

// Rende la pagina 1 di FileName a Dpi pixel per pollice e la salva come BMP
procedure RenderFirstPage(const FileName: string; Dpi: Integer);
var
  Pdf: TPdf;
  Bmp: TBitmap;
  W, H: Integer;
begin
  Pdf := TPdf.Create(nil);
  try
    Pdf.FileName := FileName;
    Pdf.Active := True;
    if not Pdf.Active then
      raise Exception.Create('Cannot open ' + FileName);
    Pdf.PageNumber := 1;        // base 1
    // PageWidth e PageHeight sono in punti (1/72 di pollice)
    W := Round(Pdf.PageWidth * Dpi / 72);
    H := Round(Pdf.PageHeight * Dpi / 72);
    Bmp := Pdf.RenderPage(0, 0, W, H, ro0, [reAnnotations]);
    try
      Bmp.SaveToFile(ChangeFileExt(FileName, '-p1.bmp'));
    finally
      Bmp.Free;                 // la forma funzione restituisce una nuova bitmap
    end;
  finally
    Pdf.Free;
  end;
end;
Perché il copia-incolla restituisce spazzatura quando la pagina sembra a posto?
Il copia-incolla fallisce quando il file registra quale glifo disegnare ma non quale carattere rappresenta. Il rendering ha bisogno solo delle forme dei glifi del programma del font incorporato. L'estrazione ha bisogno di Unicode, che arriva da una codifica standard o da una CMap /ToUnicode sul dizionario del font (§9.10.3). Un font composito con /Encoding /Identity-H scrive ID di glifo grezzi nel content stream, e senza una mappa ToUnicode quegli ID non hanno alcuna relazione definita con qualsiasi carattere. Lo schermo appare perfetto mentre gli appunti si riempiono di simboli. I font subset rendono la cosa più probabile, perché conservano solo i glifi che il documento usa e si riconoscono dal prefisso di sei lettere in nomi come /BaseFont /AAAAAA+ArialMT (§9.6.4). La guida alla gestione dei font nei PDF tratta a fondo i font CJK e l'estrazione che non funziona
Aggiornamenti incrementali e byte range delle firme
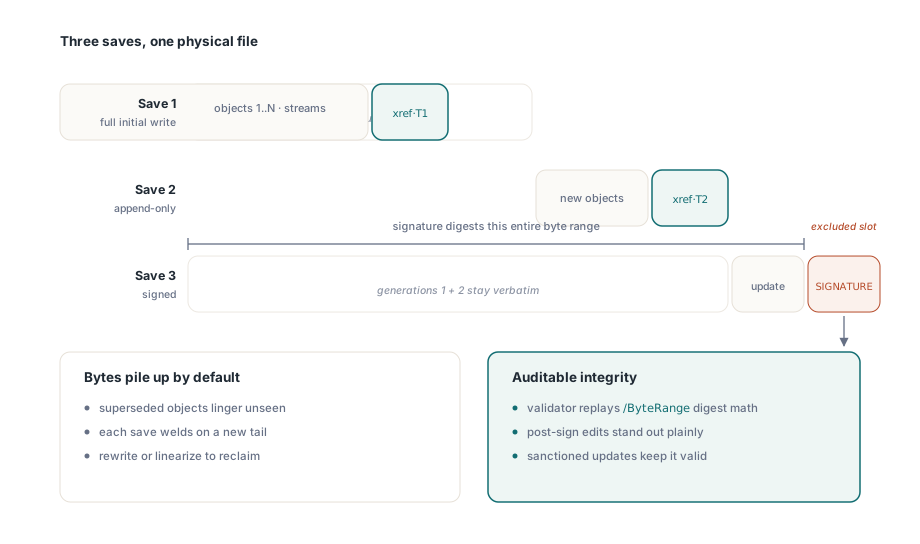
Le firme dipendono dal modo append-only in cui i PDF vengono modificati: un aggiornamento incrementale (§7.5.6) aggiunge oggetti e una nuova sezione di riferimenti incrociati dopo l'ultimo %%EOF, e la panoramica della struttura spiega la catena /Prev e perché il contenuto cancellato sopravvive nelle revisioni precedenti. Il /ByteRange di un dizionario firma, scritto come [0 a b c], calcola l'hash di tutto tranne la stringa esadecimale /Contents che contiene la firma CMS, così la revisione firmata finisce al byte b + c e un validatore la ricostruisce troncando il file lì. Le revisioni successive atterrano dopo quel punto, mentre una riscrittura completa, un linearizzatore o un passaggio di ottimizzazione sposta byte che il firmatario aveva fatto entrare nell'hash e invalida tutte le firme esistenti in una volta
Quando un'applicazione Delphi o Lazarus ha bisogno di tutta questa pipeline, dal parse dei dati di riferimenti incrociati e dalla discesa del page tree fino al rendering e all'estrazione del testo, il PDFium Component per Delphi e Lazarus la incarta nel componente documento TPdf usato nei listati di sopra e nel controllo viewer TPdfView per la visualizzazione su schermo