Un PDF troncato durante il download può rifiutarsi di aprirsi anche quando sono arrivate quasi tutte le pagine, mentre un manuale di 2.000 pagine salta alla pagina 1.500 all'istante. Entrambi i comportamenti discendono dalla struttura di un file PDF, così come la scrive HotPDF Delphi Component: un header, un corpo di oggetti numerati, una tabella dei riferimenti incrociati (xref) di offset di byte e un trailer, con le ultime due parti conservate in coda al file
L'ISO 32000-2 §7.5.1 descrive la stessa anatomia in quattro parti per ogni PDF, da una ricevuta di una pagina a un archivio scansionato. Le parti stanno sempre nello stesso ordine lungo il file e si collegano in una catena fissa: il trailer nomina il catalogo e dice dove inizia la tabella xref, la tabella xref dice dove inizia ogni oggetto, e gli oggetti si puntano a vicenda per numero. Gli estratti qui sotto vengono da un file Hello World di 610 byte i cui offset sono stati verificati byte per byte; il file completo, annotato parola chiave per parola chiave, sta in com'è fatto un PDF dentro, e quello che un visualizzatore fa con queste parti sulla strada verso i pixel sta in come funziona un PDF quando un lettore lo apre
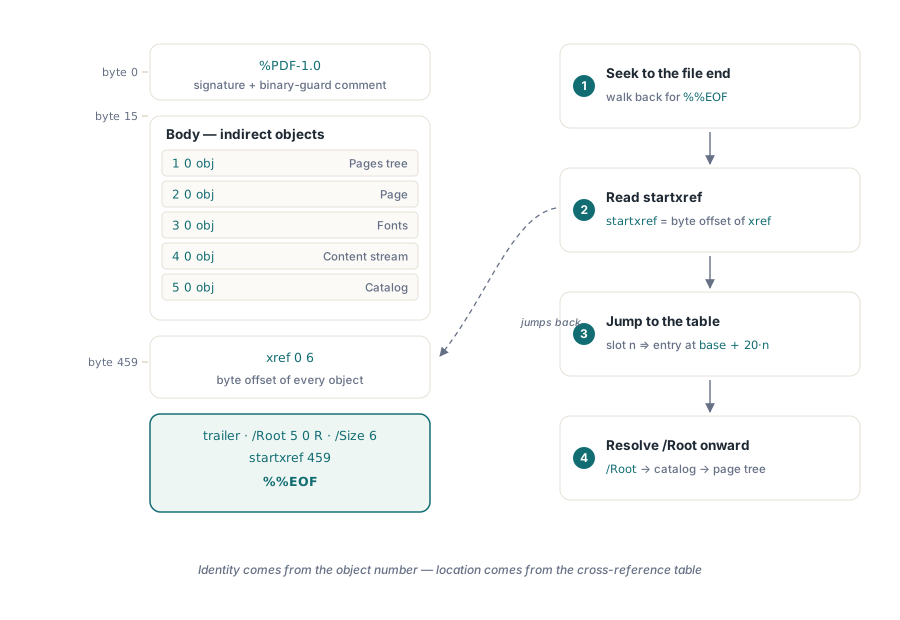
L'header è composto da due righe, e la seconda conta
La prima riga, per esempio %PDF-1.7, è un commento per quanto riguarda la sintassi, ma i lettori la trattano come la firma del file e da lei ricavano la versione; nella pratica la gestione delle versioni è permissiva, quindi trattate il numero come un indizio sulle funzionalità da aspettarvi. La seconda riga è quella che la gente cancella per sbaglio e poi passa un pomeriggio a fare debug. Il suo carico utile sta almeno quattro byte sopra l'ASCII 127 (ISO 32000-1 §7.5.2), e c'è perché chiunque sposti il file in modalità testo lo riconosca come binario e smetta di riscrivere i finali di riga. Gli stream compressi contengono byte che per coincidenza corrispondono a un carriage return o a un line feed; riscriveteli e la lunghezza dello stream registrata nel dizionario non corrisponde più ai byte su disco. Ogni writer serio emette ancora quel commento, perché il guasto che previene è silenzioso e totale
Il corpo: oggetti numerati e gli otto tipi di oggetto del PDF
Il corpo è una sequenza piatta di oggetti indiretti, ognuno incapsulato come N G obj ... endobj con un numero di oggetto e un numero di generazione. Ciò che trasforma quell'elenco piatto nella struttura interna del PDF è il token di riferimento N G R: 2 0 R significa "oggetto 2, generazione 0, ovunque si trovi nel file". Qualunque valore può anche essere scritto al suo posto come oggetto diretto. Nell'estratto il dizionario /Resources della pagina è diretto, mentre il font che nomina è indiretto, così cento pagine possono condividere l'oggetto 4 invece di portarsi dietro cento copie:
1 0 obj
<< /Type /Catalog /Pages 2 0 R >>          % il catalogo punta alla radice della gerarchia di pagine
endobj
...
3 0 obj
<< /Type /Page
   /Parent 2 0 R
   /MediaBox [0 0 612 792]
   /Resources << /Font << /F1 4 0 R >> >>   % dizionario diretto, font indiretto
   /Contents 5 0 R
>>
endobj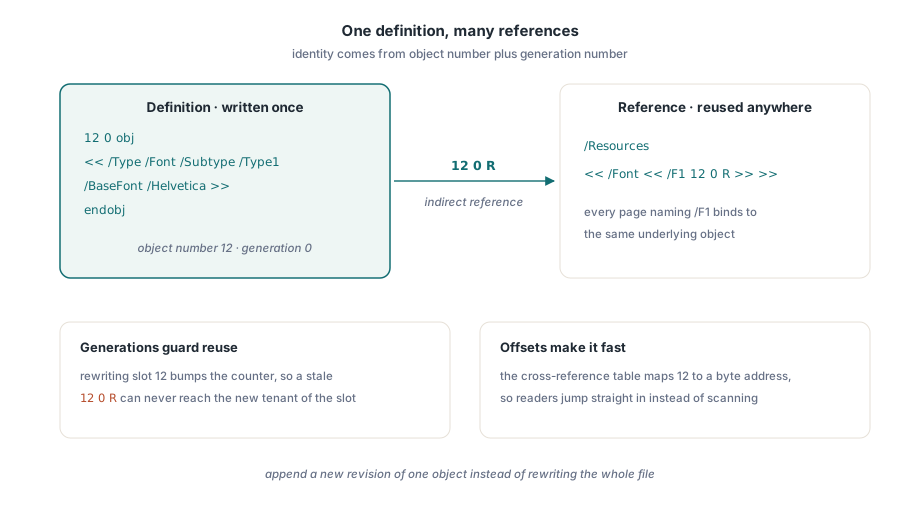
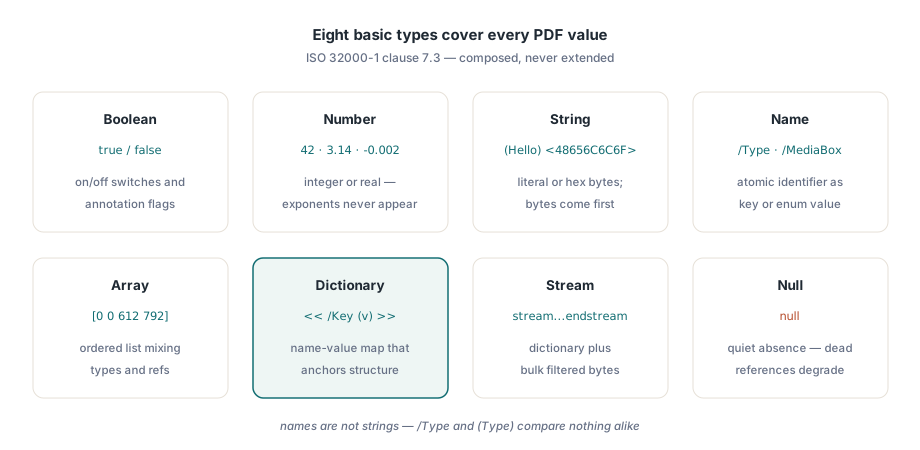
L'ISO 32000-1 §7.3 tiene corto il vocabolario: ogni valore in un PDF è uno degli otto tipi di base. Boolean e numeri sono gli scalari, e il PDF non ha notazione esponenziale, quindi 1e6 non compare mai in un file conforme. Le stringhe contengono byte, scritti come (Hello, World!) o in esadecimale come <48656C6C6F>. I nomi come /Type o /Helvetica sono confrontati byte per byte, quindi scrivere (Helvetica) dove /BaseFont si aspetta un nome è un errore di tipo anche se i caratteri corrispondono. Gli array contengono qualsiasi cosa in ordine, come il MediaBox. I dizionari mappano nomi a valori e portano la maggior parte della struttura. Uno stream è un dizionario più byte grezzi, casa del contenuto di pagina, dei font e delle immagini. L'ottavo tipo è null, e un riferimento a un oggetto che non esiste si risolve a lui invece di sollevare un errore, il che permette a un file danneggiato di degradare invece di fallire del tutto
Il numero di generazione esiste per il riutilizzo. Quando una modifica elimina un oggetto, il suo numero finisce nella free list, e se una modifica successiva riutilizza il numero, la generazione sale di uno, così un 12 0 R obsoleto non può risolversi silenziosamente al nuovo 12 1 obj. Quasi ogni oggetto che incontrate è di generazione 0. La risoluzione parte dal catalogo, l'oggetto 1 nell'estratto, la cui voce /Pages porta nell'albero delle pagine; i nodi interni raccolgono le pagine in /Kids, mantengono un /Count e possono passare attributi come /MediaBox ai loro discendenti. Perché sia quell'albero, e non l'ordine fisico degli oggetti, a decidere l'ordine delle pagine è trattato in alberi di pagine PDF e ordine delle pagine
Come localizza un oggetto la tabella xref?
La tabella xref trasforma un numero di oggetto in un offset di byte per aritmetica, ed è così che un manuale di 2.000 pagine si apre alla pagina 1.500 senza analizzare le pagine che lo precedono. L'ISO 32000-1 §7.5.4 fissa ogni voce a esattamente venti byte: un offset di dieci cifre contato dall'inizio del file, uno spazio, una generazione di cinque cifre, uno spazio, una lettera di tipo e un fine riga di due byte, che con LF è uno spazio più l'avanzamento riga. Poiché le righe sono uniformi, un lettore indicizza direttamente la riga dell'oggetto n. La riga 0 6 è l'intestazione di una sottosezione, e la voce 0 è sempre libera con generazione 65535, in testa alla linked list dei numeri di oggetto liberi. Ogni altro offset deve cadere sulla prima cifra della riga N G obj corrispondente, come nel file da 610 byte:
xref
0 6                  % 6 voci, con inizio a oggetto 0
0000000000 65535 f   % voce 0: testa della free list
0000000019 00000 n   % oggetto 1 (catalog) inizia al byte 19
0000000068 00000 n   % oggetto 2 (page tree) inizia al byte 68
0000000125 00000 n   % oggetto 3 (page) inizia al byte 125
0000000263 00000 n   % oggetto 4 (font) inizia al byte 263
0000000333 00000 n   % oggetto 5 (content stream) inizia al byte 333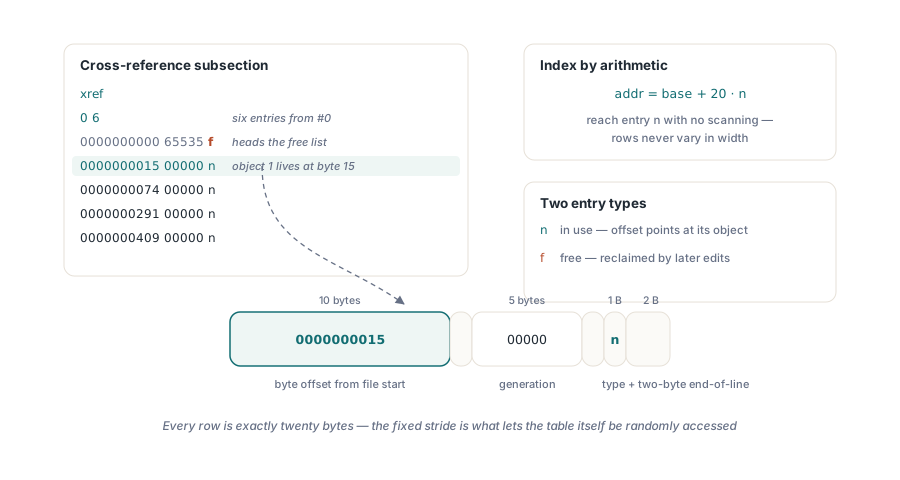
Perché un PDF troncato non si apre?
Un PDF troncato fallisce perché le due parti che legano insieme tutto, la tabella xref e il trailer, sono gli ultimi byte scritti. Il dizionario del trailer porta /Root, il catalogo, e /Size, il numero di voci xref, uno in più rispetto al numero di oggetto più alto perché lo slot zero ospita la voce libera. Sotto, startxref dà l'offset di byte della parola chiave xref e %%EOF chiude il file:
trailer
<< /Size 6 /Root 1 0 R >>   % numero di voci, catalogo del documento
startxref
427                          % offset di byte della parola chiave xref
%%EOF
Perdete gli ultimi poche centinaia di byte e il file ha gli oggetti ma nessuna mappa per raggiungerli. I lettori rigorosi si fermano lì; quelli tolleranti scansionano l'intero file in cerca di righe N G obj e ricostruiscono la tabella, il percorso lento che la xref esiste proprio per evitare, e una mappa ricostruita può comunque perdere oggetti o scegliere la copia sbagliata di uno modificato. Un trasferimento in modalità testo fa danni più silenziosi, perché riscrivere i finali di riga sposta ogni oggetto. Abbiamo convertito il file da 610 byte a finali CRLF e lanciato qpdf --check (qpdf 12.3.2): ha riportato "file is damaged" e "xref not found" all'offset 427, e ha ricostruito la tabella a forza di scansione prima di verificare qualunque cosa
Tabella xref classica o cross-reference stream?
Dal PDF 1.5 in poi, la xref può anche essere un cross-reference stream (ISO 32000-1 §7.5.8): un oggetto indiretto di /Type /XRef le cui righe binarie sostituiscono la tabella testuale e il cui dizionario di stream assorbe le voci del trailer, così la parola chiave trailer scompare e startxref punta a quell'oggetto. I tipi di riga diventano numeri (0 libero, 1 a un offset di byte, 2 dentro un object stream), /W dà la larghezza in byte di ogni colonna, e HotPDF comprime le righe con Flate e il predittore PNG Up. HotPDF scrive la forma a stream quando Version è pdf15 o superiore, così l'esempio la imposta esplicitamente, e UseObjectStreams si appoggia allo stesso interruttore. Teniamo UseXRefStream spento per i file che devono aprirsi con strumenti dell'era PDF 1.4, che non sanno affatto interpretare un xref stream, e lo accendiamo per i documenti grandi dove un indice compatto si ripaga. Cambia soltanto la coda del file:
uses
  System.SysUtils, HPDFDoc;

procedure SaveWithXRef(const FileName: string; AsStream: Boolean);
var
  PDF: THotPDF;
begin
  PDF := THotPDF.Create(nil);
  try
    PDF.AutoLaunch := False;
    PDF.FileName := FileName;
    PDF.Version := pdf17;            // gli xref stream vogliono PDF 1.5 o superiore
    PDF.UseXRefStream := AsStream;   // predefinito False: tabella testuale più trailer
    PDF.BeginDoc;
    PDF.CurrentPage.TextOut(72, 72, 0, 'Same page, different index');
    PDF.EndDoc;
  finally
    PDF.Free;
  end;
end;

// SaveWithXRef('table.pdf', False);
//   Coda attesa: xref, 0 N, righe da venti byte,
//   trailer << /Size /Root /Info /ID >>, startxref, %%EOF
// SaveWithXRef('stream.pdf', True);
//   Coda attesa: N 0 obj << /Type /XRef /Size /Root /Info /ID /W ...
//   /Filter /FlateDecode >> stream ... endstream endobj, startxref, %%EOF
Gli aggiornamenti incrementali accodano una seconda xref invece di riscrivere
Un PDF può essere modificato senza toccare alcun byte già su disco. Gli oggetti modificati e nuovi vengono accodati, seguiti da una sezione xref che elenca solo loro e da un trailer la cui voce /Prev contiene l'offset della tabella precedente. Un lettore segue startxref fino alla sezione più recente, percorre al contrario la catena di /Prev e lascia che vinca la voce più recente per ogni numero di oggetto. La modifica qui sotto aggiunge un'annotazione di tipo nota al file da 610 byte: l'oggetto pagina 3 viene riscritto con un array /Annots sotto lo stesso numero, e l'oggetto 6 è nuovo. Con i commenti tolti e finali LF gli offset sono esatti, e qpdf --check è passato sul risultato senza errori:
% ... i 610 byte originali, invariati ...
3 0 obj                          % sostituisce la pagina 3, stesso numero di oggetto
<< /Type /Page /Parent 2 0 R /MediaBox [0 0 612 792] /Resources << /Font << /F1 4 0 R >> >> /Contents 5 0 R /Annots [6 0 R] >>
endobj
6 0 obj                          % la nuova annotazione
<< /Type /Annot /Subtype /Text /Rect [72 650 92 670] /Contents (Checked) >>
endobj
xref                             % due sottosezioni da una voce
3 1
0000000610 00000 n
6 1
0000000752 00000 n
trailer
<< /Size 7 /Root 1 0 R /Prev 427 >>
startxref
843
%%EOF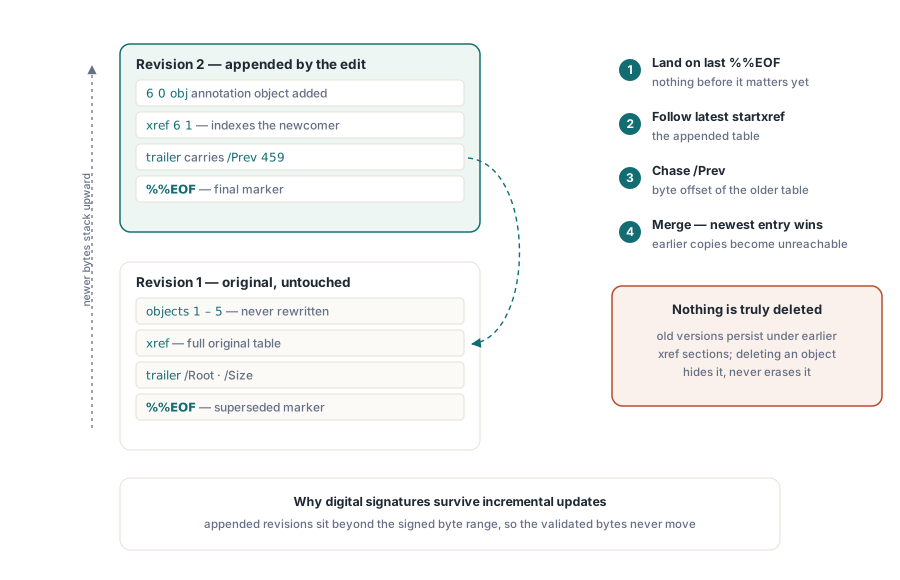
L'accodamento è ciò che tiene verificabili i PDF firmati: una firma copre un intervallo di byte, e un aggiornamento incrementale non sposta mai quei byte. È anche il motivo per cui un PDF porta con sé una cronologia recuperabile, dato che la vecchia pagina 3 sta ancora al byte 125, irraggiungibile ma presente. I file revisionati molte volte si fanno una lunga catena di /Prev; qpdf revised.pdf flat.pdf riserializza gli oggetti raggiungibili sotto una xref singola e butta via le revisioni vecchie, cosa che sul file di sopra ha lasciato una sola tabella xref e nessun /Prev, al prezzo di ogni firma sui byte originali. In HotPDF una revisione incrementale sta così:
procedure ReviseInPlace(const Original, Revised: string);
var
  PDF: THotPDF;
begin
  PDF := THotPDF.Create(nil);
  try
    PDF.AutoLaunch := False;
    PDF.BeginIncrementalUpdate(Original);   // tiene i byte originali tali e quali
    PDF.SetLoadedTitle('Quarterly report, revised');
    PDF.SetLoadedAuthor('Finance');
    PDF.SaveIncrementalUpdate(Revised);      // oggetti modificati, nuova xref, trailer con /Prev
  finally
    PDF.Free;
  end;
end;
Il layout in quattro parti dà anche un ordine di triage rapido per un PDF che si comporta male: controllate che il file finisca con %%EOF e uno startxref plausibile, verificate che uno o due offset xref cadano su una riga N G obj, poi seguite /Root dentro il catalogo e l'albero delle pagine. HotPDF Delphi Component per Delphi e C++Builder scrive tabelle xref classiche o cross-reference stream su richiesta e accoda revisioni incrementali che lasciano i byte precedenti, e le firme sopra di loro, intatti