Le dimensioni delle pagine PDF sono fisse al momento della creazione della pagina, quindi non è possibile ridimensionare semplicemente il contenuto sul posto nello stesso modo in cui si ridimensiona un'immagine. Il modello della libreria che rende pratica la riduzione è il meccanismo di cattura e ridisegno (capture-and-redraw): si estrae il contenuto di ciascuna pagina dal documento in un handle, si crea una nuova pagina vuota con le dimensioni multimediali originali e poi si ridisegna il contenuto catturato all'interno di un riquadro di delimitazione (bounding box) ridotto. Lo spazio bianco circostante diventa il margine. Con una scala al 70% su una pagina A4, ad esempio, il 15% della larghezza ricade su ciascun lato e la stessa frazione in alto e in basso, che è esattamente ciò che produce l'aritmetica dei bordi descritta di seguito
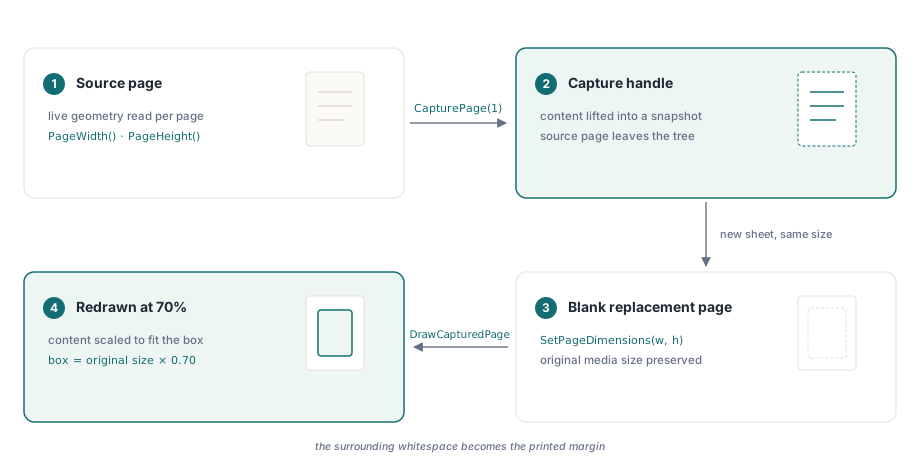
Come funziona CapturePage
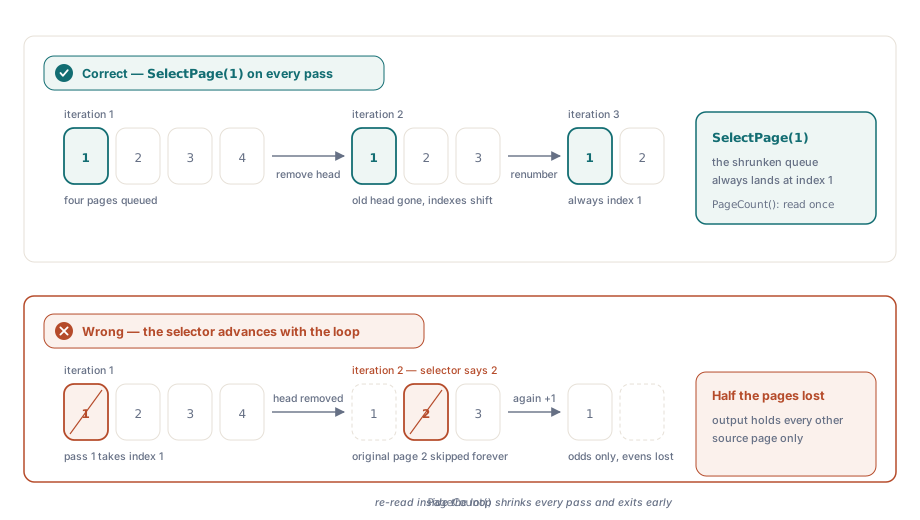
CapturePage accetta il numero di una pagina, promuove il contenuto di quella pagina in un oggetto di cattura in memoria e rimuove la pagina dall'albero delle pagine del documento. Questa rimozione è intenzionale ed è il motivo per cui il ciclo seleziona sempre la pagina 1, indipendentemente dall'indice di iterazione: una volta che la pagina 1 viene catturata ed eliminata, quella che era la pagina 2 diventa la nuova pagina 1, e così via. Se si incrementa il selettore di pagina insieme al contatore del ciclo, si salterà una pagina sì e una no, ottenendo la metà dell'output previsto
L'handle di cattura restituito da CapturePage non è un riferimento alla pagina; è più simile a uno snapshot del contenuto. Resta valido dopo il disegno, quindi la stessa cattura può essere piazzata più di una volta, finché non la liberi con ReleaseCapturedPage o il documento non va via. DrawCapturedPage prende quell'handle più un rettangolo di destinazione dato come bordo sinistro, bordo superiore, larghezza e altezza, tutto in punti per impostazione predefinita. La libreria scala il contenuto catturato per entrare esattamente in quel rettangolo, preservando le proporzioni solo se il tuo rettangolo per caso corrisponde alle proporzioni originali. Per una scala uniforme vuoi il rettangolo della dimensione originale moltiplicata per il fattore di scala, centrato sulla pagina
I calcoli per il centraggio
Con un fattore di scala del 70%, il restante 30% di ogni dimensione viene diviso equamente tra i due lati. Quindi il rientro orizzontale é pageWidth * (1.0 - 0.70) / 2, che corrisponde al 15% della larghezza, e il rientro verticale segue la stessa formula utilizzando l'altezza della pagina. Il rettangolo di destinazione per DrawCapturedPage inizia quindi a (horizBorder, vertBorder) ed ha un'estensione di pageWidth - 2 * horizBorder per pageHeight - 2 * vertBorder. Questa aritmetica non è specifica della libreria; si tratta semplicemente della geometria necessaria per inserire simmetricamente un rettangolo più piccolo all'interno di uno più grande
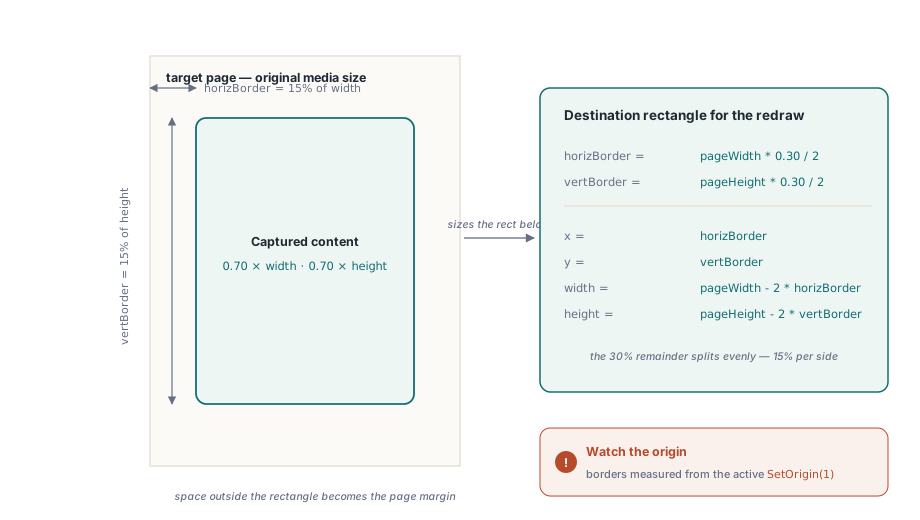
Una cosa da notare: SetOrigin(1) mette l'origine delle coordinate in alto a sinistra anziché in basso a sinistra. Il secondo valore che passi a DrawCapturedPage è il bordo superiore del rettangolo, misurato da quale origine hai impostato. Ecco perché gli esempi chiamano SetOrigin(1) prima: con l'origine predefinita in basso a sinistra lo stesso vertBorder metterebbe il bordo superiore vicino al fondo della pagina e spingerebbe gran parte del contenuto fuori
Esempio in C#
Il codice seguente elabora ogni pagina di Pages.pdf attraverso il ciclo cattura-e-ridisegno e scrive il risultato su newpages.pdf. PDFL è una istanza della classe di import PDFlibrary che fa parte dell'edizione DLL, creata con new PDFlibrary("PDFlibDLL64.dll"); l'edizione ActiveX espone gli stessi metodi attraverso PDFlibAX.PDFlibrary
private void ScalePages_Click(object sender, EventArgs e)
{
    File.Delete("newpages.pdf");

    double pageWidth, pageHeight, horizBorder, vertBorder;
    double scaleFactor = 0.70;
    int capturedPageId, ret;

    PDFL.LoadFromFile("Pages.pdf", "");
    PDFL.SetOrigin(1);

    int numPages = PDFL.PageCount();

    for (int i = 1; i <= numPages; i++)
    {
        // Seleziona sempre la pagina 1: CapturePage rimuove la pagina, così la pagina 2
        // diventa pagina 1 alla iterazione successiva.
        PDFL.SelectPage(1);

        pageWidth  = PDFL.PageWidth();
        pageHeight = PDFL.PageHeight();

        horizBorder = pageWidth  * (1.0 - scaleFactor) / 2;
        vertBorder  = pageHeight * (1.0 - scaleFactor) / 2;

        capturedPageId = PDFL.CapturePage(1);
        // 0 = niente catturato, per esempio una sorgente di una pagina: l'unica pagina non può essere rimossa
        if (capturedPageId == 0)
            throw new InvalidOperationException("CapturePage failed on source page " + i);

        PDFL.NewPage();
        PDFL.SetPageDimensions(pageWidth, pageHeight);

        ret = PDFL.DrawCapturedPage(
            capturedPageId,
            horizBorder, vertBorder,
            pageWidth  - 2 * horizBorder,
            pageHeight - 2 * vertBorder);
        if (ret != 1)
            throw new InvalidOperationException("DrawCapturedPage failed on source page " + i);
    }

    PDFL.SaveToFile("newpages.pdf");
}
Esempio in Delphi
La versione Delphi usa TPDFlib direttamente anziché attraverso la classe di import della DLL, ma la sequenza di chiamate è identica. Una differenza pratica è la guardia sul file di output: FileExists più DeleteFile invece di File.Delete, perché SaveToFile fallisce se la destinazione è bloccata da una esecuzione precedente ancora aperta in un viewer
procedure TForm1.ScalePagesClick(Sender: TObject);
var
  PDFLib: TPDFlib;
  pageWidth, pageHeight, horizBorder, vertBorder: Double;
  scaleFactor: Double;
  capturedPageId, ret, numPages, i: Integer;
begin
  if FileExists('newpages.pdf') then
    DeleteFile('newpages.pdf');

  scaleFactor := 0.70;

  PDFLib := TPDFlib.Create;
  try
    PDFLib.LoadFromFile('Pages.pdf', '');
    PDFLib.SetOrigin(1);

    numPages := PDFLib.PageCount();

    for i := 1 to numPages do
    begin
      PDFLib.SelectPage(1);

      pageWidth  := PDFLib.PageWidth();
      pageHeight := PDFLib.PageHeight();

      horizBorder := pageWidth  * (1.0 - scaleFactor) / 2;
      vertBorder  := pageHeight * (1.0 - scaleFactor) / 2;

      capturedPageId := PDFLib.CapturePage(1);
      // 0 = niente catturato, per esempio una sorgente di una pagina: l'unica pagina non può essere rimossa
      if capturedPageId = 0 then
        raise Exception.CreateFmt('CapturePage failed on source page %d', [i]);

      PDFLib.NewPage();
      PDFLib.SetPageDimensions(pageWidth, pageHeight);

      ret := PDFLib.DrawCapturedPage(
        capturedPageId,
        horizBorder, vertBorder,
        pageWidth  - 2 * horizBorder,
        pageHeight - 2 * vertBorder);
      if ret <> 1 then
        raise Exception.CreateFmt('DrawCapturedPage failed on source page %d', [i]);
    end;

    PDFLib.SaveToFile('newpages.pdf');
  finally
    PDFLib.Free;
  end;
end;
Cosa controlla effettivamente il fattore di scala
Il valore 0.70 qui significa che il contenuto renderizzato occupa il 70% di ogni dimensione della pagina, non che il file è il 70% della sua dimensione in byte originale. La dimensione del file dopo questa operazione dipende dalla complessità del contenuto originale; una pagina con immagini grandi non si ridurrà proporzionalmente perché i dati pixel vengono ridisegnati alla stessa risoluzione in un'area più piccola. Se l'obiettivo è un file più piccolo, guarda a CompressContent per gli stream di contenuto pagina usciti non compressi e alla ricompressione delle immagini (OptimizeImages nell'edizione Delphi), non alla scala geometrica. LinearizeFile è un altro strumento: riordina il file per il caricamento una pagina alla volta (Fast Web View), aiuta i viewer ad aprire file grandi in rete ma non li riduce
La cifra del 70% non è inoltre un limite rigido. Qualsiasi valore compreso tra 0.0 e 1.0 funziona, e valori superiori a 1.0 ingrandiscono il contenuto oltre il bordo originale della pagina, il quale viene ritagliato in corrispondenza del bordo del media box, a meno che non si aumentino anche le dimensioni della pagina. I documenti con dimensioni di pagina miste vengono gestiti in modo naturale, poiché PageWidth e PageHeight vengono rilevati per ogni pagina prima del calcolo del bordo. Pertanto, un documento in cui le pagine dispari sono in formato A4 e quelle pari sono A3 produrrà un output correttamente centrato per ciascuna dimensione di pagina, senza necessità di casi speciali
Dove le cose possono andare storte
Nella pratica si riscontrano due modalità di errore principali. La prima riguarda un file di output che è rimasto aperto in un visualizzatore PDF da un'esecuzione precedente: in questo caso, SaveToFile fallirà o scriverà zero byte a seconda della piattaforma, impedendo la corretta creazione del nuovo output. La protezione tramite eliminazione del file all'inizio della funzione gestisce questa situazione in fase di sviluppo, ma in una pipeline di produzione è più sicuro scrivere su un percorso temporaneo e rinominare il file solo in caso di successo
La seconda è la discrepanza nel conteggio delle pagine. Siccome CapturePage rimuove le pagine dal documento mentre le elabora, il conteggio che leggi da PageCount() prima del ciclo è il limite corretto contro cui iterare. Chiamare PageCount() dentro il ciclo non aiuta neanche lì: ogni passata rimuove una pagina e ne aggiunge una, quindi il conteggio resta piatto e non dice nulla su quante pagine sorgente restano. La variabile del ciclo negli esempi serve solo da contatore di iterazioni rimanenti; non viene mai usata per selezionare una pagina, perché la pagina da selezionare è sempre la 1 per il motivo spiegato prima
Le chiamate di manipolazione delle pagine mostrate qui, tra cui CapturePage, DrawCapturedPage e SetPageDimensions, fanno parte della losLab PDF Library per Delphi, C#, VB.NET e C++