Inserendo =NORM.DIST(115,100,15,TRUE) in una cella, Excel restituisce 0.8413447. La chiamata appare come una semplice ricerca. Ma non è così. Dietro quel singolo numero risiede la distribuzione normale cumulativa, un integrale privo di forma chiusa, e dietro CHISQ.INV.RT e BETA.DIST si trovano funzioni speciali che una libreria accurata deve calcolare effettivamente, senza ricorrere ad approssimazioni manuali. Un componente per fogli di calcolo che dichiara la compatibilità con Excel deve riprodurre questi valori fino all'ultima cifra mostrata da Excel, il che implica riprodurre i metodi numerici e non solo i nomi delle funzioni
HotXLS implementa più di cinquanta di queste funzioni statistiche, e il lavoro che le rende corrette è quasi del tutto invisibile dalla barra delle formule. Questo è un percorso dentro il modo in cui il motore le calcola: il nucleo comune di funzioni speciali, le scelte di ramo che mantengono stabile l'aritmetica, e una trappola della normale inversa che si nasconde nella coda perché il caso comune non tocca mai quella riga
Una chiamata al foglio di calcolo, cinquanta distribuzioni alla base
Le funzioni coprono le famiglie utilizzate in una cartella di lavoro statistica. Troviamo la famiglia normale, NORM.DIST e NORM.S.DIST con le rispettive inverse; la famiglia gamma e chi-quadrato, GAMMA.DIST, CHISQ.DIST, CHISQ.DIST.RT, CHISQ.INV.RT; la famiglia beta, BETA.DIST e BETA.INV; le distribuzioni campionarie T.DIST, T.DIST.2T, F.DIST e F.INV; la coppia discreta BINOM.DIST e POISSON.DIST; e i supporti di inferenza come CONFIDENCE.T e CONFIDENCE.NORM. Dal punto di vista del chiamante ciascuna rappresenta una singola formula. Si impostano gli input nelle celle, si richiede la valutazione alla cartella di lavoro e si legge il risultato
var
  wb: IXLSWorkbook;
  sh: IXLSWorksheet;
begin
  wb := TXLSWorkbook.Create;
  sh := wb.Sheets.Add;
  sh.Range['A1', 'A1'].Value := 115;   // osservazione
  sh.Range['A2', 'A2'].Value := 100;   // media
  sh.Range['A3', 'A3'].Value := 15;    // deviazione standard

  // Il parser di formule XLS usa ';' come separatore degli argomenti.
  Writeln(wb.Calculate('=NORM.DIST(A1;A2;A3;TRUE())'));   // 0.8413447
  Writeln(wb.Calculate('=CHISQ.INV.RT(0.05;10)'));        // 18.3070381
  Writeln(wb.Calculate('=BETA.DIST(0.5;2;3;TRUE())'));    // 0.6875
end;
Il metodo Calculate della cartella di lavoro compila e valuta una formula ad-hoc rispetto al foglio attivo e restituisce un tipo Variant. Un dettaglio può trarre in inganno al primo tentativo: il parser di formule alla base di Calculate utilizza il punto e virgola come separatore degli argomenti, perciò si scrive =SUM(A1;B1) anziché =SUM(A1,B1). Le formule memorizzate nelle celle conservano la virgola standard di Excel. Lo stesso valutatore gestisce ogni funzione statistica indicata di seguito, perciò il funzionamento di una di esse in Calculate garantisce quello delle altre
Le due funzioni alla base di tutte le altre
La maggior parte delle distribuzioni cumulative di questo insieme non viene calcolata sommando o integrando le rispettive definizioni. Sono calcolate a partire da due funzioni speciali: la funzione gamma incompleta inferiore regolarizzata, indicata con P(a, x), e la funzione beta incompleta regolarizzata, indicata con Ix(a, b). Internamente questi sono gli helper su cui si appoggiano i dispatcher, e la catena è breve. La CDF del chi-quadrato è la CDF gamma con forma df/2 e scala 2. La CDF gamma corrisponde direttamente a P(a, x). Le funzioni cumulative t, F e binomiale sono tutte valori della beta incompleta regolarizzata ai corretti argomenti. La CDF di Poisson corrisponde alla gamma incompleta superiore Q. Implementando con cura le funzioni gamma e beta, una dozzina di distribuzioni ne eredita l'accuratezza gratuitamente
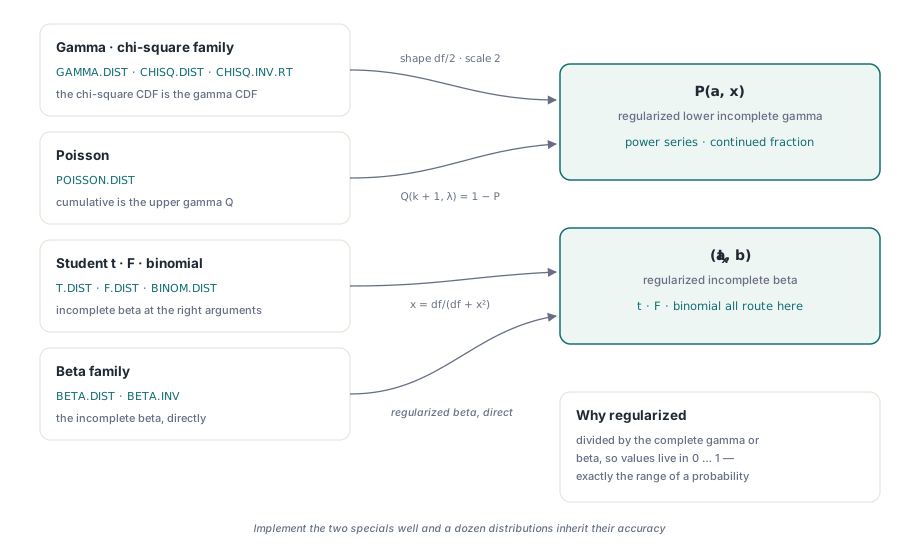
Il termine "regolarizzato" costituisce il punto centrale. La funzione gamma incompleta grezza cresce come un fattoriale e l'integrale beta grezzo può subire underflow o overflow molto prima che avvenga per il risultato. Le forme regolarizzate sono divise per la gamma o beta completa, perciò risiedono interamente nell'intervallo da zero a uno, che corrisponde esattamente all'ambito di una probabilità. Tale normalizzazione è ciò che consente alla stessa routine di gestire un chi-quadrato con due gradi di libertà e uno con duecento senza che i termini intermedi superino i limiti di un double. Spiega inoltre perché non si calcola una CDF sommando una lunga coda di termini di densità: ciascun termine porta con sé il proprio errore di arrotondamento, gli errori si accumulano con il procedere della serie, e la funzione speciale regolarizzata evita del tutto la somma valutando invece una serie rapidamente convergente o una frazione continua
Serie al di sotto della diagonale, frazione continua al di sopra
La routine della gamma incompleta prende una decisione prima di effettuare qualsiasi calcolo: confronta x con a + 1. Tale limite non è arbitrario. Lo sviluppo in serie di potenze di P(a, x) converge rapidamente quando x è piccolo rispetto ad a, e lentamente (fino a diventare inutile) quando x è grande. La frazione continua presenta il comportamento opposto. Pertanto, il motore utilizza lo sviluppo in serie di potenze per x inferiore ad a + 1 e una frazione continua di Lentz per x pari o superiore ad a + 1, assegnando a ciascun ramo solo l'operazione per cui è ottimizzato
La frazione continua richiede un controllo. Il metodo di Lentz opera gestendo un numeratore e un denominatore parziali e invertendo il denominatore a ogni passaggio; se uno dei due si avvicina a zero, l'inversione fallisce. La soluzione consiste in un limite minimo piccolissimo: ogni volta che un termine intermedio scende al di sotto di circa 1e-30 in modulo, viene bloccato a 1e-30, il che mantiene finita la ricorsione senza alterare il valore convergente. Lo stesso blocco appare nella frazione continua della beta incompleta per il medesimo motivo. Si tratta di una piccola costante che svolge un lavoro fondamentale, facendo la differenza tra una valutazione stabile e una divisione per un valore indistinguibile da zero
La coda superiore, Q(a, x), corrisponde semplicemente a 1 meno P(a, x), e questo è il modo in cui viene calcolato il ramo cumulativo di Poisson: la probabilità di al massimo k eventi con media λ è pari a Q(k + 1, λ). Ricorrere alla gamma incompleta superiore anziché sommare k + 1 termini di Poisson rappresenta, ancora una volta, la scelta di valutare un'unica espressione convergente invece di accumulare molti piccoli valori
Masse discrete senza overflow del fattoriale
Le distribuzioni discrete presentano un pericolo diverso. Una massa di probabilità binomiale comporta un coefficiente binomiale, e il coefficiente per 52 su 26 è un intero enorme. Calcolandolo direttamente, il numeratore supera i limiti di un double prima della divisione che lo ricondurrebbe a una probabilità sensata. Il motore non lo calcola mai in questo modo. Calcola i fattoriali nello spazio logaritmico tramite la funzione log-gamma, somma e sottrae i logaritmi, integra il logaritmo delle probabilità di successo e fallimento, ed esegue l'esponenziale una sola volta alla fine
// Massa di probabilità binomiale, valutata interamente in spazio logaritmico.
// LnGammaF(n+1) è ln(n!); i tre log-fattoriali formano ln(C(n,k)),
// e tutto l'esponente viene costruito prima di una singola chiamata Exp.
//   ln P(X=k) = ln(n!) - ln(k!) - ln((n-k)!) + k*ln(p) + (n-k)*ln(1-p)
result := Exp(LnGammaF(nt + 1) - LnGammaF(kk + 1) - LnGammaF(nt - kk + 1)
  + kk * Ln(pp) + (nt - kk) * Ln(1 - pp));
La funzione log-gamma stessa è un'approssimazione di Lanczos, precisa sull'intero asse positivo e rapida da valutare. Poiché ogni valore elevato viene gestito come logaritmo fino all'espressione Exp finale, il valore massimo prodotto dalla routine è la probabilità stessa, che è al massimo pari a uno. La funzione di massa di Poisson segue la stessa logica, con il singolo termine log-gamma a rappresentare il fattoriale al denominatore. Le forme chiuse sono gestite come casi speciali ai limiti, dove p è esattamente zero o uno, in modo che il codice non chiami mai Ln(0). HotXLS restituisce 0.2460938 per BINOM.DIST(5,10,0.5,FALSE) e 0.6766764 per la cumulativa POISSON.DIST(2,2,TRUE), in linea con le cifre mostrate da Excel
Inverse tramite delimitazione (bracketing) della curva diretta
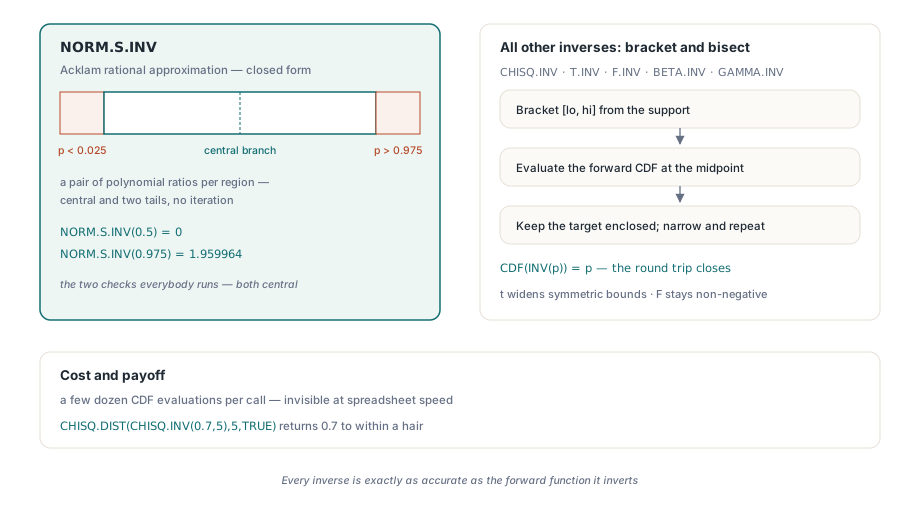
Una funzione di distribuzione inversa pone la domanda opposta: data una probabilità, trovare il valore la cui CDF corrisponde a essa. Una sola inversa in questo insieme dispone di una formula diretta rapida. NORM.S.INV, l'inversa normale standard, utilizza un'approssimazione razionale di Acklam, una coppia di rapporti polinomiali precisi all'incirca quanto un double sull'intero intervallo, suddivisa in una regione centrale e due code. Si tratta di una valutazione in forma chiusa che non richiede iterazioni
Le altre inverse non dispongono di tale formula, perciò il motore le inverte numericamente. Delimita la risposta con un limite inferiore e uno superiore scelti dal supporto della distribuzione, quindi dimezza l'intervallo (bisezione): valuta la CDF diretta nel punto medio, sposta il limite che mantiene racchiusa la probabilità target e ripete l'operazione fino a restringere l'intervallo. Per le inverse gamma e chi-quadrato la delimitazione inizia da zero e da una stima superiore ampia basata su forma e scala, raddoppiando il limite superiore se la probabilità non è ancora racchiusa. L'inversa t delimita limiti simmetrici che si allargano verso l'esterno; l'inversa F esegue la bisezione su un intervallo non negativo. Il costo corrisponde a poche decine di valutazioni della CDF per chiamata, impercettibile alla velocità del foglio di calcolo, e il vantaggio risiede nel fatto che ogni inversa ha esattamente la stessa precisione della funzione diretta che inverte. Questo spiega perché un percorso completo come CHISQ.DIST(CHISQ.INV(0.7,5),5,TRUE) restituisca 0.7 con estrema precisione
La trappola del logaritmo nella coda
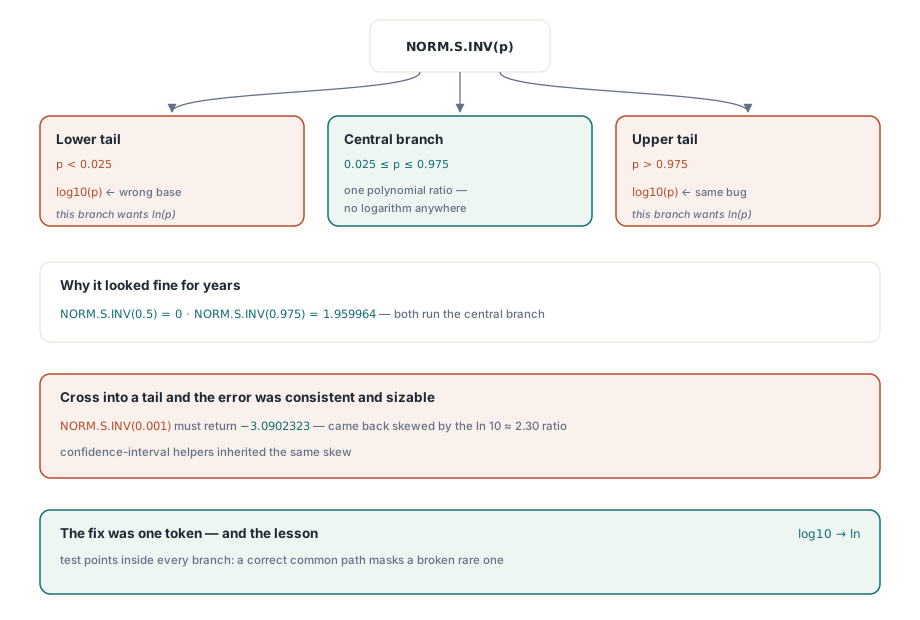
Ecco la trappola che vale la pena raccontare, perché è di quelle che sopravvivono a lungo in qualunque implementazione. La routine di Acklam per la normale inversa ha tre rami. Il ramo centrale ampio, usato ogni volta che la probabilità sta tra circa 0.025 e 0.975, passa l'input attraverso un rapporto polinomiale senza alcun logaritmo. I due rami di coda, per probabilità molto piccole o molto grandi, prendono prima un logaritmo dell'input, perché la coda si comporta come la radice quadrata del negativo del logaritmo naturale di p
Prendi un logaritmo in base 10 in un ramo di coda dove appartiene il logaritmo naturale, e i risultati di coda sono sbagliati di un margine consistente e costante, perché i due differiscono di un fattore costante di circa 2.30. Eppure la funzione sembra a posto in ogni controllo distratto, perché i controlli distratti vivono al centro. NORM.S.INV(0.5) è zero, NORM.S.INV(0.975) è il classico 1.959964, ed entrambi passano per il polinomio centrale che non chiama mai un logaritmo. L'errore compare solo quando una probabilità entra in una coda, diciamo NORM.S.INV(0.001), che deve restituire -3.0902323. Qualsiasi funzione che dipenda dalla normale inversa nella sua coda, compresi gli helper per gli intervalli di confidenza, eredita la stessa distorsione. La lezione è prosaica e costosa: una funzione con una struttura a rami vuole punti di test dentro ogni ramo, perché un percorso comune corretto maschera allegramente un ramo raro rotto. HotXLS prende il logaritmo naturale in entrambi i rami di coda, quindi i valori di coda corrispondono a quelli di Excel
Il segno di x determina la coda della distribuzione t
La funzione cumulativa t di Student presenta una sottigliezza facile da invertire. Il suo valore deriva dalla beta incompleta regolarizzata valutata a df / (df + x²), ma tale valore beta corrisponde alla probabilità nella coda oltre il modulo di x, non alla probabilità cumulativa fino a x. La forma simmetrica della distribuzione t fa sì che la conversione dipenda dal lato dello zero in cui cade x
// CDF t di Student. ib è la beta incompleta regolarizzata a df/(df+x*x),
// che misura la coda simmetrica. Il valore cumulativo dipende da
// il segno di x; restituire ib non convertito dà la coda sbagliata.
ib := BetaIF(df / 2, 0.5, df / (df + x * x));
if x > 0 then
  result := 1 - 0.5 * ib        // sopra la media: uno meno metà della coda
else if x < 0 then
  result := 0.5 * ib            // sotto la media: metà della coda
else
  result := 0.5;                // esattamente alla media
Per x sopra zero la probabilità cumulativa è uno meno la metà della coda simmetrica; per x sotto zero è metà di quella coda; a zero è esattamente un mezzo. Restituire direttamente il valore beta significa riportare il lato sbagliato della distribuzione, fuori dell'intero corpo della curva per ogni x diverso da zero. Le varianti a coda destra e a due code costruiscono sullo stesso ramo, ed è per questo che T.DIST.2T(1,1) torna 0.5 e T.DIST(1,1,TRUE) 0.75, e l'inversa T.INV biseca contro questa CDF così il round trip si chiude
Nulla di tutto questo è visibile dalla cella, ed è questo il risultato desiderato. Scrivi una formula e leggi un numero che concorda con Excel. Se stai estendendo il motore con la tua logica, le procedure per registrare una funzione sono trattate nella nostra guida al motore di formule e alle funzioni personalizzate, e il modo in cui le formule fanno riferimento a diversi fogli e intervalli con nome è descritto nell'articolo sui nomi definiti e le formule tra fogli. Tutto questo è fornito all'interno del componente per fogli di calcolo HotXLS per Delphi e C++Builder, insieme alle API di lettura, scrittura, grafici e formattazione trattate in altre sezioni di questo blog