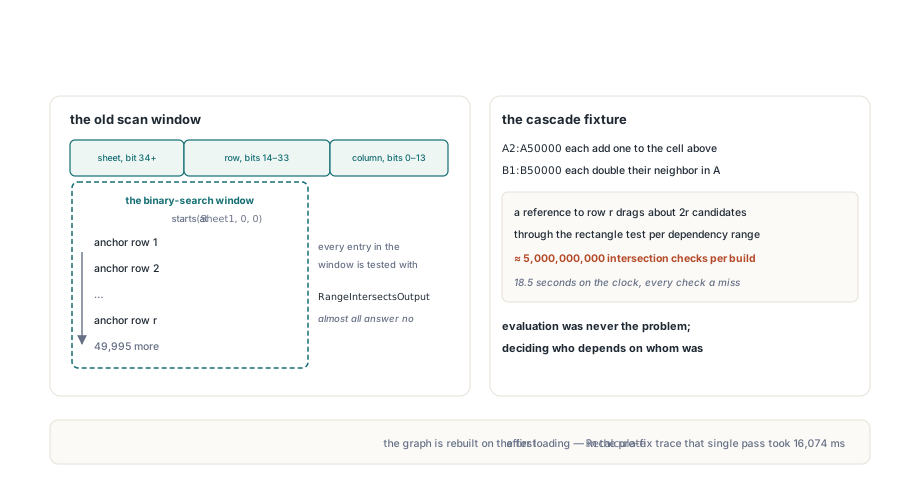
Un foglio con 50.000 formule nella colonna A, ognuna che aggiunge uno alla cella sopra, e altre 50.000 nella colonna B che raddoppiano la propria vicina è più o meno il modello di foglio di calcolo più semplice che esista. Valutarlo costa 100.000 addizioni e moltiplicazioni. Capire l'ordine di valutazione costa molto di più se il costruttore di archi è scritto nel modo ovvio: cercare ogni formula dalla cima del foglio referenziato fino alla riga referenziata, testarle una a una per sovrapposizione e tenere le corrispondenze. Per questo solo foglio vengono fuori circa cinque miliardi di test di rettangoli, e quasi nessuno risponde sì
I cinque miliardi sono aritmetica, non una lettura dal cronometro. Un riferimento alla riga r trascina nella finestra di ricerca circa 2r candidati, uno per colonna per ogni riga sopra di essa, e sommando su 100.000 riferimenti si arriva ai miliardi. La parte interessante è che la finestra deve davvero partire dalla cima del foglio, per un motivo che non ha nulla a che fare con la pigrizia
Dove va a finire il tempo di una ricostruzione del grafo
Il motore di ricalcolo di HotXLS ricostruisce il grafo delle dipendenze delle formule ogni volta che la topologia delle formule cambia: al primo Recalculate dopo che un workbook è stato caricato o generato, e al primo dopo che le formule sono state riscritte, i fogli aggiunti o rimossi, o un blocco di celle clonato. Entrambe le classi workbook, TXLSWorkbook e TXLSXWorkbook, costruiscono a questo scopo un TXLSDepGraph dall'unità lxDepGraph. Ogni cella formula diventa un nodo con un ancoraggio (Row, Col) e un rettangolo di output che arriva fino a (OutRow2, OutCol2). Per una formula ordinaria il rettangolo è la cella di ancoraggio stessa
I nodi sono ordinati per una chiave a 64 bit compressa da XLSDepMakeKey: la colonna sta nei bit 0–13, la riga nei bit 14–33 e l'indice del foglio dal bit 34 in su. Ordinare per quella chiave dà un ordine per foglio e per riga, quindi trovare l'ultima formula che può contare per un riferimento è una singola ricerca dicotomica su (Sheet2, Row2, 16383). La prima è il problema. Il limite inferiore deve essere (Sheet1, 0, 0), la cima stessa del foglio referenziato, e tutto quello che sta tra i due limiti diventa candidato
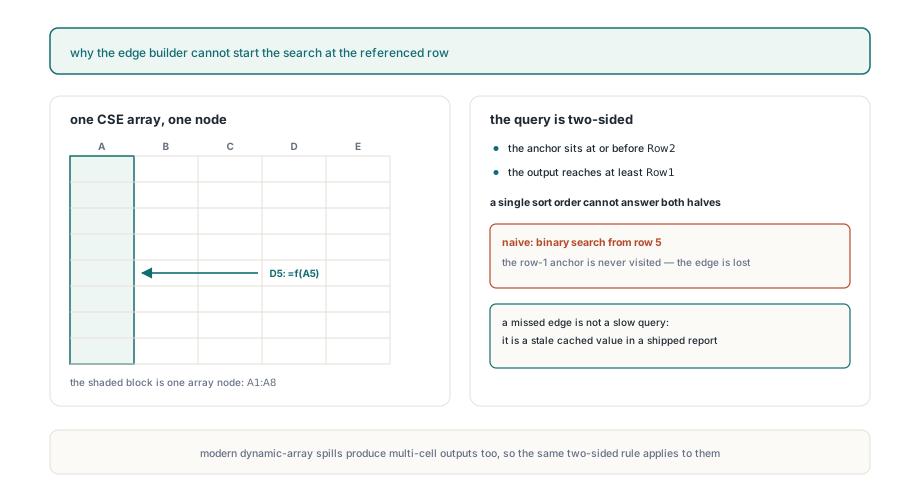
Perché la ricerca non può partire dalla riga referenziata?
Una formula array ancorata sopra un range può possedere celle al suo interno. In un TXLSXWorkbook, un array CSE inserito in A1:A8 è un singolo nodo il cui ancoraggio è A1 e il cui output arriva fino alla riga 8, come descrive l'articolo sul ricalcolo incrementale e il grafo delle dipendenze. Una formula in D5 che legge solo A5 ha comunque bisogno di un arco da quel nodo. Fate partire la ricerca dicotomica dalla riga 5 e l'ancoraggio alla riga 1 non viene mai visitato, l'arco non viene mai registrato, e D5 può essere valutata prima dell'array da cui dipende. Il sintomo è un valore in cache stantio nel workbook salvato, molto più difficile da notare di un ricalcolo lento
Quindi la vera query ha due lati. Un nodo è candidato quando il suo ancoraggio è su o prima di Row2 e il suo output arriva almeno a Row1, su un foglio interno al riferimento e con colonne sovrapposte. Un ordinamento per ancoraggio risponde alla prima metà. Nulla nell'ordine di ancoraggio dice nulla sulla seconda metà, perché una formula sulla riga 3 può produrre una cella o mille righe. Le tabelle what-if hanno la stessa forma: TXLSXWorkbook registra ogni data table come un nodo che copre l'intera area dei risultati. Le formule dynamic-array prendono una strada diversa e sono marcate volatili, quindi vengono ricalcolate a ogni passata; l'articolo sulle formule spill di dynamic array copre come si comportano i range spilled
TXLSDepGraph è una classe pubblica, quindi il caso è facile da riprodurre senza un workbook. Gli indici dei fogli partono da 1 e righe e colonne da 0, in accordo con le coordinate del calcolatore. La sonda qui sotto registra la radice array e il lettore, costruisce gli archi, e fa girare anche una catena di riferimenti puntuali in ordine inverso attraverso lo stesso tipo di grafo per mostrare il contatore su cui contano le sezioni successive
uses
  System.SysUtils, lxDepGraph;

function PointRef(ASheet, ARow, ACol: Integer): TXLSDepRange;
begin
  Result.Sheet1 := ASheet;
  Result.Sheet2 := ASheet;
  Result.Row1 := ARow;
  Result.Row2 := ARow;
  Result.Col1 := ACol;
  Result.Col2 := ACol;
  Result.LookupScan := False;
end;

procedure ProbeOutputIndex;
const
  N = 100000;
var
  G: TXLSDepGraph;
  Deps: TXLSDepRangeList;
  Reader, Row: Integer;
begin
  Deps := TXLSDepRangeList.Create;
  G := TXLSDepGraph.Create;
  try
    // Array CSE: ancoraggio A1 (riga 0, col 0), output fino a A8 (riga 7)
    G.AddNode(1, 0, 0, 7, 0, False, nil);
    // D5 (riga 4, col 3) legge solo A5
    Deps.Add(PointRef(1, 4, 0));
    Reader := G.AddNode(1, 4, 3, 4, 3, False, Deps);
    G.BuildEdges;
    Writeln('D5 precedents: ', G.Nodes[Reader].PrecedentCount);  // 1, la radice A1
    Writeln('rectangles tested: ', G.EdgeCandidateChecks);       // 2: la radice A1 e D5 stessa
  finally
    G.Free;
  end;

  // Catena A1..A100000, ogni cella legge quella sopra, inserita dal basso
  G := TXLSDepGraph.Create;
  try
    for Row := N - 1 downto 0 do
    begin
      Deps.Clear;
      if Row > 0 then
        Deps.Add(PointRef(1, Row - 1, 0));
      G.AddNode(1, Row, 0, Row, 0, False, Deps);
    end;
    G.BuildEdges;
    Writeln('chain checks: ', G.EdgeCandidateChecks);  // N - 1 = 99999
  finally
    G.Free;
    Deps.Free;
  end;
end;
Potare i sottoalberi per la massima riga di output
TXLSDepGraph.BuildEdges conserva l'ordinamento per ancoraggio per il limite superiore e risponde al limite inferiore con un segment tree aumentato col massimo disposto sopra l'ordine ordinato. Ogni voce dell'albero memorizza la massima OutRow2 di tutti i nodi sotto di essa. La query scende solo dentro la finestra di chiavi e abbandona ogni sottoalbero il cui massimo memorizzato sta sopra Row1, perché nessuna formula in quel sottoalbero può raggiungere le righe referenziate. I nodi che sopravvivono ricevono comunque il test completo del rettangolo, quindi span di fogli e colonne vengono verificati esattamente come prima
La tecnica è abbastanza piccola da poter essere mostrata per intero. Lo schema qui sotto è una versione minima scritta per questo articolo, con nomi suoi; nessuno di questi è API di HotXLS, e gli array sono compito del lettore, da riempire a partire da un elenco di righe di output già ordinato per chiave di ancoraggio
uses
  System.Math, System.Generics.Collections;

// Solo uno schema: un segment tree aumentato col massimo sui nodi ordinati per chiave di ancoraggio.
// OutRow2[i] è l'ultima riga di output dell'i-esimo nodo in ordine ordinato.
type
  TOutputIndex = record
    OutRow2: TArray<Integer>;
    MaxRow: TArray<Integer>;   // SetLength(MaxRow, 4 * Length(OutRow2))
  end;

procedure BuildMax(var Ix: TOutputIndex; Node, L, R: Integer);
var
  M: Integer;
begin
  if L = R then
  begin
    Ix.MaxRow[Node] := Ix.OutRow2[L];
    Exit;
  end;
  M := (L + R) shr 1;
  BuildMax(Ix, Node * 2, L, M);
  BuildMax(Ix, Node * 2 + 1, M + 1, R);
  Ix.MaxRow[Node] := Max(Ix.MaxRow[Node * 2], Ix.MaxRow[Node * 2 + 1]);
end;

// Raccoglie, da sinistra a destra, ogni nodo in [Lo, Hi) il cui output raggiunge Row1
procedure Query(const Ix: TOutputIndex; Node, L, R, Lo, Hi, Row1: Integer;
  Hits: TList<Integer>);
var
  M: Integer;
begin
  if (R < Lo) or (L >= Hi) or (Ix.MaxRow[Node] < Row1) then
    Exit;                        // fuori dalla finestra, oppure nulla raggiunge Row1
  if L = R then
  begin
    Hits.Add(L);                 // il chiamante esegue comunque il test completo del rettangolo
    Exit;
  end;
  M := (L + R) shr 1;
  Query(Ix, Node * 2, L, M, Lo, Hi, Row1, Hits);           // prima a sinistra
  Query(Ix, Node * 2 + 1, M + 1, R, Lo, Hi, Row1, Hits);   // conserva l'ordine di scansione
end;

// Costruire una volta con BuildMax(Ix, 1, 0, Count - 1),
// poi per ogni riferimento chiamare Query(Ix, 1, 0, Count - 1, Lo, Hi, Row1, Hits)
Per riferimento, il lavoro scende dalla dimensione della finestra a O((k + 1) log n), dove k è il numero di nodi il cui output raggiunge davvero le righe referenziate. Tornando al modello iniziale, un riferimento da Br a Ar ora testa due rettangoli, Ar e Br stessa, e un riferimento da Ar alla cella sopra testa i due nodi di quella riga. A mano vengono fuori circa 200.000 test per l'intera costruzione invece di cinque miliardi
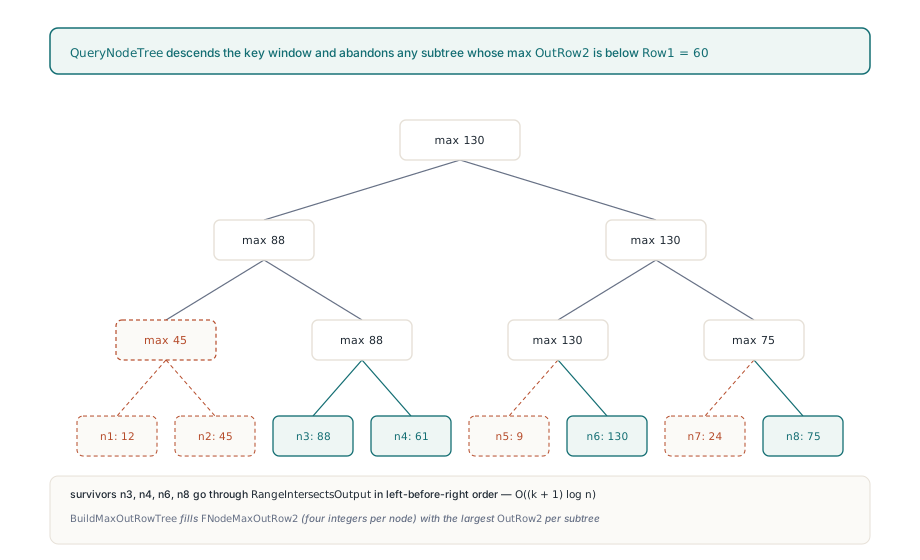
Stessi archi, nello stesso ordine
La ricorsione sinistra-prima-di-destra conta più di quanto sembri. I nodi superstiti vengono visitati nell'esatto ordine in cui li avrebbe visitati un semplice loop sulla finestra, quindi gli array Dependents e Precedents di ogni nodo si riempiono nella stessa sequenza, e l'ordine topologico costruito su di essi esce identico a ogni esecuzione. Quell'ordine non è solo contabilità interna: quando il grafo è aggiornato, il writer XLSX emette xl/calcChain.xml nell'ordine in cui FullTopoOrder lo restituisce, così un ordine di visita non deterministico si vedrebbe come diff rumorosi tra due salvataggi di uno stesso workbook invariato
Anche le specie di archi conservano le loro regole. I riferimenti che stanno nell'argomento lookup-array di VLOOKUP, MATCH, XLOOKUP e funzioni simili producono archi lookup-scan, che propagano la sporcizia ma restano fuori dal rilevamento dei cicli. Quando un nodo ha sia un riferimento hard sia un riferimento lookup verso lo stesso precedente, un arco hard registrato prima sopprime il successivo arco di scan, e un arco di scan registrato prima conserva il suo slot mentre l'arco hard viene comunque aggiunto. Quell'ordinamento è ciò che impedisce ai range di lookup di produrre falsi riferimenti circolari, e vale solo se la passeggiata potata visita i candidati in ordine di scansione
La proprietà EdgeCandidateChecks rende la potatura osservabile. Conta i rettangoli di output che la chiamata BuildEdges più recente ha davvero testato e si azzera all'inizio di ogni costruzione. Nella sonda qui sopra la catena in ordine inverso riporta 99.999, un test per riferimento, anche se i nodi erano stati aggiunti dal basso e l'ordinamento ha dovuto riordinarli tutti. AddNode marca come stanti sia l'ordinamento sia gli archi, così la successiva BuildEdges o NodeIndexOf ricostruisce l'indice invece di rattopparlo
Dove resta il costo residuo
L'albero pota solo sulle righe, e quella scelta plasma ciò che un modello grande paga ancora
- I mancati match di colonna si pagano alle foglie: le 2.626 formule che riempiono
A100:Z200arrivano tutte alla riga 100, così un riferimento aAA100:AA200le testa una per una prima di respingerle sulle colonne - I riferimenti a intera colonna e gli altri riferimenti larghi hanno davvero molti precedenti; l'indice toglie i test sprecati, e costruire gli archi veri resta proporzionale a quanti sono
- Un riferimento che attraversa più fogli apre una finestra che copre l'intero primo foglio, così le formule lì con output profondi arrivano al test delle foglie; gli archi escono gli stessi ed è solo la potatura a essere più debole
- L'albero costa quattro interi per nodo, circa 1,6 MB per 100.000 formule, e qualsiasi cambio di topologia paga un riordino completo O(n log n) più una costruzione dell'albero O(n) alla successiva costruzione degli archi
Le righe sono la giusta dimensione singola da indicizzare. I report generati, i registri e i modelli finanziari crescono verso il basso, quindi la distanza in righe è da dove viene quasi tutta la massa di candidati sprecati, mentre un mancato match di colonna viene respinto dal test dei rettangoli in una manciata di confronti tra interi. Una seconda dimensione nell'albero complicherebbe ogni query per risparmiare test già economici
Sul lato chiamate, il passo costoso è la ricostruzione, e le modifiche ai valori non la innescano. Recalculate costruisce il grafo alla prima chiamata; le chiamate successive rivalutano solo le formule a valle dei valori cambiati, più quelle volatili. Scrivere prima tutte le formule e ricalcolare una volta sola è lo schema a cui puntare. L'harness qui sotto cronometra entrambi i tipi di passata sul motore classico, dove Recalculate restituisce il numero di celle formula che non è riuscito a valutare; eseguitelo sull'hardware che ospiterà il job batch, perché i tempi assoluti dipendono molto dalla macchina
uses
  System.SysUtils, System.Diagnostics, lxHandle;

procedure TimeCascadeRecalc;
var
  Wb: TXLSWorkbook;
  Sh: TXLSWorksheet;
  I, Failed: Integer;
  Watch: TStopwatch;
begin
  Wb := TXLSWorkbook.Create;
  try
    Sh := Wb.Sheets.Add;
    Sh.Cells[1, 1].Value := 1;
    for I := 2 to 50000 do                     // catena di 49.999 anelli nella colonna A
      Sh.Cells[I, 1].Formula := '=A' + IntToStr(I - 1) + '+1';
    for I := 1 to 50000 do                     // 50.000 dipendenti nella colonna B
      Sh.Cells[I, 2].Formula := '=A' + IntToStr(I) + '*2';

    Watch := TStopwatch.StartNew;
    Failed := Wb.Recalculate;                  // costruisce il grafo, valuta tutto
    Writeln(Format('first pass: %d not evaluated, %.1f ms',
      [Failed, Watch.Elapsed.TotalMilliseconds]));

    Sh.Cells[1, 1].Value := 10;                // modifica di valore: il grafo viene riutilizzato
    Watch := TStopwatch.StartNew;
    Failed := Wb.Recalculate;                  // solo il sottografo sporco
    Writeln(Format('value pass: %d not evaluated, %.1f ms',
      [Failed, Watch.Elapsed.TotalMilliseconds]));
  finally
    Wb.Free;
  end;
end;
In questo modello la passata a valle rievaluta comunque tutte le 99.999 formule, dato che tutta la colonna A pende da A1; ciò che salta è la costruzione del grafo. Sovrascrivere una cella formula con un valore semplice è un altro paio di maniche, perché cambia la topologia e il successivo Recalculate ricostruisce il grafo da zero
La stessa forma quadratica nei nomi definiti clonati
I report-band nascondono lo stesso schema in un posto diverso. TXLSXWorksheet.CloneRangeTo copia i nomi definiti che puntano direttamente a un range dentro il blocco clonato, e ogni copia ha bisogno di un nome unico nel proprio scope: Total_2, Total_3, e così via. Una ricerca che riparte da _2 per ogni copia sonda un candidato in più ogni volta, così un foglio costruito da centinaia di band clonate spende un numero quadratico di ricerche di nomi solo per dare i nomi
TXLSXDefinedNames lo evita con un hint di suffisso conservato nel proprio indice dei nomi, uno per nome base e scope. La ricerca successiva parte dal suffisso restituito l'ultima volta e lo riverifica per primo, perché il chiamante è libero di non aggiungere quel nome. Eliminare un nome, rinominarlo tramite Name, spostarlo con SheetIndex o svuotare la raccolta butta l'indice insieme a ogni hint, così il clone successivo torna al primo suffisso libero e riempie qualsiasi buco il cambio ha aperto
Per le applicazioni Delphi e C++Builder che generano o ricalcolano fogli di calcolo grandi, l'HotXLS Excel component per Delphi e C++Builder usa questo grafo delle dipendenze indicizzato nel motore di ricalcolo delle sue classi workbook sia classiche sia XLSX