Nomi di città cinesi esportati in .dbf su un PC occidentale possono tornare come punti interrogativi da un export che aveva riferito successo, perché i file dBASE, SYLK e DIF non hanno dove registrare una codifica. Un writer sicuro usa la code page ANSI della macchina ospite e controlla ogni nome e valore contro di essa prima del primo byte; HotXLS rifiuta ciò che quella pagina non può contenere
La code page della macchina ospite è l'unica codifica che questi file abbiano
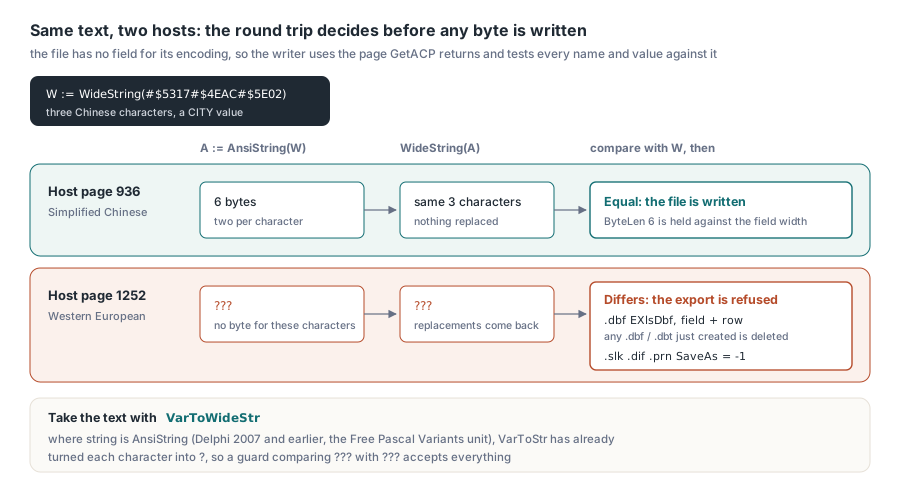
Tutti e tre i formati vengono dai primi anni del PC: dBASE da Ashton-Tate, SYLK dall'era Multiplan di Microsoft, DIF da Software Arts, l'azienda di VisiCalc. Ciascuno conserva il testo come byte singoli e presume che chi legge condivida la code page di chi scrive — una scommessa equa quando ogni macchina dell'ufficio girava con lo stesso setup DOS. Su Windows oggi quella pagina è ciò che restituisce GetACP: 1252 su una installazione dell'Europa occidentale, 936 sul cinese semplificato, 1251 sul cirillico. dBASE IV e FoxPro hanno poi messo un marchio del language driver al byte 29 dell'header della tabella, ma il layout dBASE III che HotXLS scrive lascia quel byte a zero, e SYLK, DIF e il testo .prn allineato con spazi non hanno affatto un campo header per questo. Quindi la code page si concorda fuori dal file. HotXLS usa la code page ANSI della macchina ospite in scrittura e in lettura, e controlla prima di scrivere che ogni carattere abbia un byte in quella pagina
| Formato | Estensione su SaveAs / Open | Codifica dichiarata nel file | Testo che la pagina ospite non può contenere |
|---|---|---|---|
| Tabella dBASE III | .dbf, più un file memo .dbt quando serve | No (il byte 29 resta a zero) | EXlsDbf viene sollevata prima di scrivere, e i .dbf / .dbt appena creati vengono cancellati |
| SYLK | .slk, .sylk | No | SaveAs restituisce -1 e non crea alcun file |
| DIF | .dif | No | SaveAs restituisce -1 e non crea alcun file |
| Testo formattato | .prn | No | SaveAs restituisce -1 e non crea alcun file |
Dieci byte per un nome di campo dBASE, contati nella code page
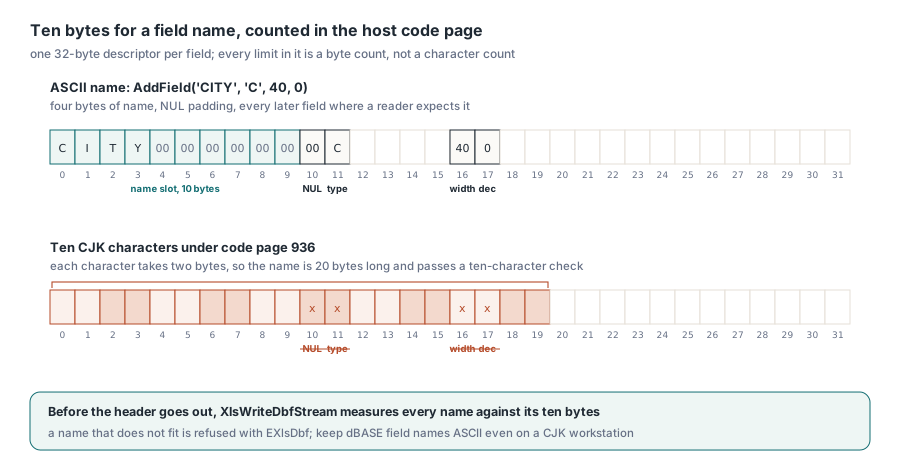
Ogni limite di dimensione in una tabella dBASE è un conteggio di byte, ed è lì che le code page multibyte fanno male. Un descrittore di campo tiene il nome in undici byte — dieci per il nome, uno per il NUL di terminazione — e mette la lettera del tipo subito dietro, all'offset 11, la larghezza a 16 e il conteggio dei decimali a 17. Con la code page 936 un carattere cinese è due byte, quindi un nome cinese di dieci caratteri ne fa venti. Copiate quei byte dentro senza misurarli e attraversano dritti il NUL, la lettera del tipo e la larghezza; nessun reader può recuperare quel descrittore dopo, anche se il nome aveva passato un controllo a dieci caratteri. Tenete i nomi di campo dBASE ASCII anche su una workstation CJK. Gli strumenti xBase, i driver ODBC e il software GIS che legge le tabelle di attributi degli shapefile puntano tutti su quei nomi, e un nome che si decodifica solo sotto 936 diventa byte diversi su ogni macchina che gira con un'altra pagina
| Byte | Contenuto dBASE III |
|---|---|
| 0 | Versione: 0x03, o 0x83 quando un file memo .dbt accompagna la tabella |
| 1–3 | Ultimo aggiornamento: anno dal 1900, mese, giorno |
| 4–7 | Conteggio record, little-endian a 32 bit |
| 8–11 | Lunghezza header e lunghezza record, parole a 16 bit |
| dal 32 in poi | Un descrittore da 32 byte per campo, poi 0x0D; seguono i record, ciascuno dopo una flag di cancellazione |
Anche le larghezze sono byte. Un campo carattere (C) si ferma a 254 byte, i valori N sono testo allineato a destra con i decimali dichiarati, i valori D sono otto caratteri in forma YYYYMMDD, e un valore troppo largo per il suo campo diventa una fila di asterischi, la convenzione che usa dBASE stesso. Il testo più lungo va in un campo memo (M) che contiene un numero di blocco nel .dbt compagno: un header da 512 byte, poi blocchi da 512 byte, ogni memo chiuso da 0x1A 0x1A. TXLSXWorkbook.SaveAs con un nome .dbf trasforma la prima riga usata del foglio attivo in nomi di campo, deduce C, N, L o D per colonna, ripiega sul C per le colonne miste e sposta il testo oltre i 254 caratteri in M. Quando le larghezze vanno controllate in byte, costruite la tabella da soli con TXlsDbfTable e dimensionate ogni campo C sulla lunghezza codificata del suo valore più lungo
uses
  Windows, SysUtils, Variants, lxDbf;

procedure WriteCustomerTable(const FileName: string);
var
  Table: TXlsDbfTable;
  Row: Integer;
begin
  Table := TXlsDbfTable.Create;
  try
    // Nomi ASCII di al più dieci byte; le larghezze sono byte nella code page ospite
    Table.AddField('CUSTNO', 'N', 6, 0);
    Table.AddField('CITY', 'C', 40, 0);
    Table.AddField('BALANCE', 'N', 12, 2);
    Table.AddField('OPENED', 'D', 8, 0);

    Row := Table.AddRow;
    Table.SetValue(Row, 0, 1001);
    Table.SetValue(Row, 1, WideString(#$5317#$4EAC#$5E02));  // 北京市, 6 byte in CP936
    Table.SetValue(Row, 2, 1234.5);
    Table.SetValue(Row, 3, EncodeDate(2026, 11, 12));

    try
      XlsWriteDbfFile(FileName, Table);
    except
      on E: EXlsDbf do
        // Atteso su una macchina 1252: il messaggio nomina il campo "CITY" e la riga 1,
        // e nessun .dbf resta su disco
        raise Exception.CreateFmt('DBF export refused under code page %d: %s',
          [GetACP, E.Message]);
    end;
  finally
    Table.Free;
  end;
end;
Atteso: su una macchina 936 la tabella viene scritta e si riapre con tutti e quattro i campi. Su una 1252 XlsWriteDbfFile solleva EXlsDbf nominando il campo e la riga a base uno. XlsWriteDbfStream converte ogni nome di campo e ogni valore C o M nella pagina ospite e indietro, confronta, e misura ogni nome contro i suoi dieci byte prima che l'header esca, quindi una tabella rifiutata lascia lo stream intatto. La forma su file va un passo oltre e cancella il .dbf, e ogni .dbt, che aveva già creato
Come si verifica se una stringa sopravvive alla code page ospite?
Convertitela in AnsiString, riconvertitela in WideString e confrontatela con l'originale. Un carattere che la pagina non ha torna come rimpiazzo, di solito ?, quindi il confronto fallisce esattamente quando l'export perderebbe dati. I writer usano la stessa conversione, così il controllo e il writer non possono essere in disaccordo sulla code page. Tenete anche la lunghezza in byte: è il numero da far stare in uno slot da dieci byte o in una larghezza di campo
uses
  Variants;

// True quando ogni carattere di V sopravvive alla code page ANSI ospite;
// ByteLen è la lunghezza codificata da confrontare con una larghezza di campo
function FitsHostCodePage(const V: Variant; out ByteLen: Integer): Boolean;
var
  W: WideString;
  A: AnsiString;
begin
  W := VarToWideStr(V);   // VarToStr può convertire prima che questo controllo veda il testo
  A := AnsiString(W);
  ByteLen := Length(A);
  Result := WideString(A) = W;
end;
Il commento su VarToWideStr porta con sé la lezione vera. In Delphi 2007 e prima string è AnsiString ovunque, e sotto Free Pascal l'unità Variants è compilata col tipo string della RTL, cioè AnsiString, qualunque modalità usi la vostra unità. Su quei compilatori VarToStr ha già messo un ? dove stava ogni carattere cinese: una guardia costruita su AnsiString(VarToStr(V)) confronta allora punti interrogativi con punti interrogativi e accetta tutto. TStringList ha lì lo stesso tipo di problema: assegnate testo wide alla sua proprietà Text per spezzare le righe e ogni carattere passa per la code page ospite lungo la strada. XlsParseSlk, XlsParseDifText e XlsParsePrnText prendono input WideString e ne conservano ogni carattere su qualsiasi macchina. Se compilate anche con Lazarus, vedete con quale tipo stringa compilano le unità HotXLS sotto Free Pascal
Record SYLK e DIF, riga per riga
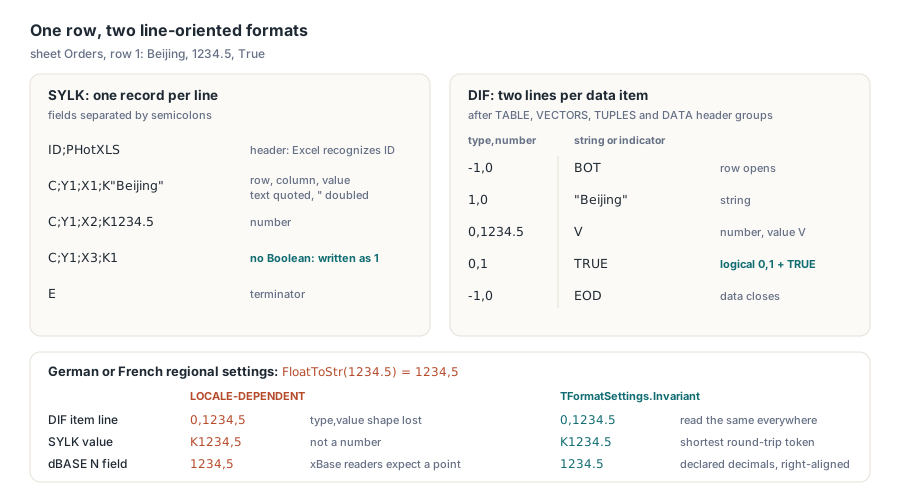
SYLK è un record per riga, con campi separati da punti e virgola. HotXLS scrive un header ID;PHotXLS, un record C;Yriga;Xcolonna;Kvalore per cella e un terminatore E. Il testo va tra virgolette, con le virgolette interne raddoppiate, il che protegge anche un punto e virgola dentro un valore, e il reader accetta l'escape ;; che alcuni producer usano al suo posto. Non c'è un Boolean: i writer del formato stesso mandano 1 e 0, quindi è ciò che scrive SaveAs; gli errori escono come testo tipo #N/A, le date come numeri seriali. Quelle due lettere in cima sono il modo in cui Excel riconosce SYLK — ed è per questo che scambia per un file SYLK un CSV la cui prima cella dice ID. Costruzione e parse lavorano entrambi su WideString, così il round trip in memoria qui sotto dà la stessa risposta su qualsiasi macchina
uses
  SysUtils, lxSlk;

function SylkRoundTripsInMemory: Boolean;
var
  Cells, Back: TXLSSlkCells;
  Text: WideString;
  I: Integer;
begin
  SetLength(Cells, 3);
  Cells[0].Row := 1; Cells[0].Col := 1; Cells[0].Kind := slkText;
  Cells[0].Text := WideString(#$4E0A#$6D77'; Pudong');   // 上海; Pudong
  Cells[1].Row := 1; Cells[1].Col := 2; Cells[1].Kind := slkText;
  Cells[1].Text := 'Pipe 12" steel';
  Cells[2].Row := 2; Cells[2].Col := 1; Cells[2].Kind := slkNumber;
  Cells[2].Number := 1234.5;

  Text := XlsBuildSlk(Cells);           // K"上海; Pudong", K"Pipe 12"" steel", K1234.5
  Result := XlsParseSlk(Text, Back) = Length(Cells);
  for I := 0 to High(Cells) do
    if Result then
      Result := (Back[I].Row = Cells[I].Row) and (Back[I].Col = Cells[I].Col) and
        (Back[I].Kind = Cells[I].Kind) and (Back[I].Text = Cells[I].Text) and
        ((Cells[I].Kind <> slkNumber) or (Back[I].Number = Cells[I].Number));
end;
DIF è più verboso. Quattro gruppi di header, TABLE, VECTORS (numero di colonne), TUPLES (numero di righe) e DATA, occupano tre righe ciascuno; poi ogni elemento di dati ne occupa due, una riga tipo,numero e una riga con la stringa tra virgolette o un indicatore di valore. Una riga si apre con -1,0 e BOT, e -1,0 con EOD chiude i dati. Un numero è 0,valore più V, un logico 0,1 più TRUE oppure 0,0 più FALSE, una stringa 1,0 più il proprio testo tra virgolette. In lettura HotXLS mappa gli indicatori NA e ERROR su #N/A e #VALUE! e tratta NULL come vuoto. Un foglio di nome Orders la cui unica riga contiene Beijing, 1234.5 e True si esporta così:
TABLE
0,1
"Orders"
VECTORS
0,3
""
TUPLES
0,1
""
DATA
0,0
""
-1,0
BOT
1,0
"Beijing"
0,1234.5
V
0,1
TRUE
-1,0
EOD
Una virgola decimale rompe tutti e tre i formati
La code page non è l'unica impostazione della macchina che si infiltra in questi file. Su una workstation con impostazioni regionali tedesche o francesi, FloatToStr trasforma 1234.5 in 1234,5. In DIF la riga dell'elemento diventa 0,1234,5 e perde la sua forma tipo,valore. In SYLK, K1234,5 non è un numero. In un campo N dBASE, i reader xBase si aspettano un punto. HotXLS scrive e legge tutti e tre con TFormatSettings.Invariant: SYLK prende il token più corto che rilegge allo stesso double, DIF un FloatToStr invariante con .0 aggiunto ai numeri interi, i campi numerici dBASE i propri decimali dichiarati, allineati a destra. Anche il parse ignora il locale, quindi un file da una macchina con virgola decimale si legge allo stesso modo ovunque
Leggere tabelle scritte da altri programmi
Aprire la tabella di qualcun altro sposta la domanda sulla code page sulla macchina che legge. XlsReadDbfFile, e TXLSXWorkbook.Open su un nome .dbf, accettano i byte di versione 0x03, 0x83, 0x8B, 0x30, 0x31 e 0x32, coprendo tabelle dBASE III e IV e Visual FoxPro, inclusi i tipi binari di FoxPro I (intero a 32 bit), B (double), Y (currency scalata di 10.000) e T (giorno giuliano più millisecondi). Il testo memo arriva da un .dbt accanto alla tabella, oppure da un .fpt col layout a blocchi di FoxPro quando non esiste un .dbt; decide l'estensione, quindi nessuno dei due compagni viene letto al posto dell'altro. I dati carattere vengono decodificati nella pagina ospite: una tabella dBASE III scritta da un programma DOS sotto la code page 866, col byte 29 lasciato a zero, mostra quindi le lettere sbagliate su una macchina 1252. Quando sapete chi è il producer, fate l'import dove la sua code page è la pagina di sistema. I file SYLK, DIF e .prn seguono la stessa regola, perché Open decodifica i loro byte nella pagina ospite prima che il parser del testo wide li veda
Quale formato dovrebbe portare testo non ASCII fra locale diversi?
Nessuno di questi quattro, se avete la scelta. Usateli quando il sistema ricevente insiste — una schermata di import ERP, un'applicazione xBase, una pipeline GIS — e quando i dati sono ASCII o le due estremità condividono una code page. Tutto il resto dovrebbe viaggiare in un formato che dichiara la propria codifica: XLSX, SpreadsheetML 2003, oppure CSV, che HotXLS scrive come UTF-8 con byte order mark (il export CSV e TSV ha le sue insidie di trasporto). Siccome SaveAs sceglie il formato dall'estensione, il vostro codice deve gestire entrambi gli stili di rifiuto dalla prima tabella: un'eccezione per .dbf, un risultato -1 per i formati testuali
uses
  SysUtils, lxHandleX, lxDbf;

function SaveForLegacyImport(const BaseName: string): string;
var
  Book: TXLSXWorkbook;
  Sheet: TXLSXWorksheet;
begin
  Book := TXLSXWorkbook.Create;
  try
    Sheet := Book.Sheets.Add('Orders');   // il primo foglio aggiunto diventa attivo
    Sheet.Cells[1, 1].Value := 'CUSTNO';
    Sheet.Cells[1, 2].Value := 'CITY';
    Sheet.Cells[2, 1].Value := 1001;
    Sheet.Cells[2, 2].Value := WideString(#$5317#$4EAC);  // 北京

    Result := BaseName + '.slk';
    if Book.SaveAs(Result) <> 1 then
    begin
      // La code page attiva non può contenere il testo: nessun .slk è stato creato
      Result := BaseName + '.xlsx';
      Book.SaveAs(Result);
    end;

    try
      Book.SaveAs(BaseName + '.dbf');
    except
      on E: EXlsDbf do
        Result := Result + ' (no .dbf: ' + E.Message + ')';
    end;
  finally
    Book.Free;
  end;
end;
Su una macchina 936 questa funzione produce un .slk e un .dbf che contengono entrambi 北京; su una 1252 produce un .xlsx e riferisce perché il .dbf è stato rifiutato. I nomi delle voci RTF, HTML e ZIP nel componente fogli di calcolo HotXLS per Delphi seguono regole di codifica proprie