Un PDF che si apre all'istante da un disco locale può mettersi diversi secondi per mostrare la prima pagina quando gli stessi byte arrivano da un server HTTP che risponde a richieste di range, anche se il file è di pochi megabyte e il collegamento è veloce. La banda non è il problema. È il numero di richieste, e la cura è trasformare centinaia di microletture sparse in qualche dozzina di blocchi in cache, poi leggere in anticipo solo finché lo schema di accesso resta sequenziale
Perché lo stesso PDF si carica all'istante da disco e si trascina su HTTP?
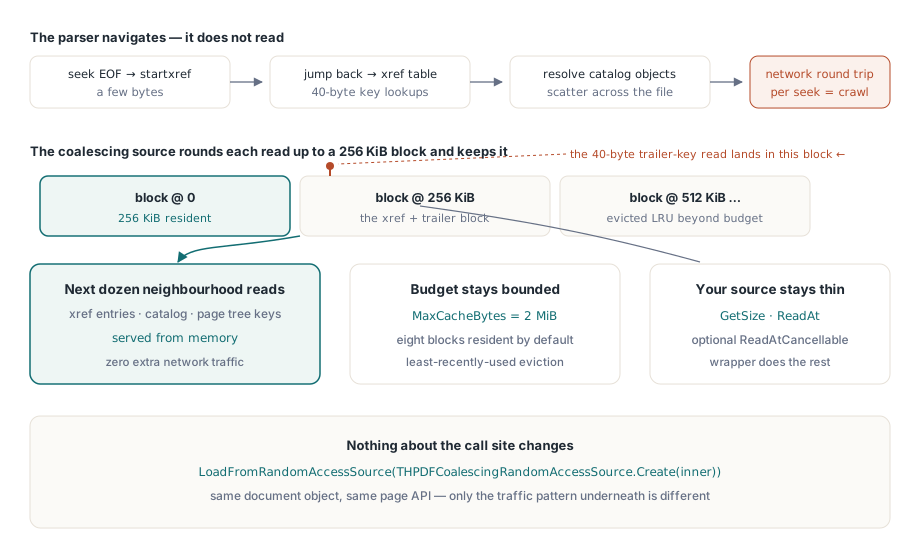
Un parser PDF non legge un file dall'inizio alla fine. Lo naviga. La struttura in ISO 32000-1 §7.5 mette il punto di ingresso alla fine: il parser cerca nell'ultimo kilobyte lo startxref, salta indietro alla cross-reference table, risolve il dizionario trailer, segue un riferimento fino al Catalog, poi alla radice dell'albero di pagine, poi a un nodo pagina, poi al dizionario risorse di quella pagina. Ogni salto legge poche decine di byte da un offset diverso, e un file con incremental update ripete il percorso una volta per revisione attraverso la catena /Prev
Su un file locale questo schema costa quasi niente, perché il sistema operativo tiene già la pagina da 4 KiB circostante nella propria file cache e la seconda lettura costa una copia di memoria. Un trasporto di rete non ha nessuna località simile. Ogni lettura diventa una richiesta con la sua latenza, e l'aritmetica è brutale: a 40 ms per round trip, 300 piccole letture sommano dodici secondi di attesa mentre il filo resta per lo più inattivo. Leggere meno non è un'opzione, dato che il parser vuole esattamente i byte che chiede. Ciò che può cambiare è quanto ogni richiesta fisica riporta indietro
Avvolgere il vostro trasporto in THPDFCoalescingRandomAccessSource
HotPDF carica documenti da qualsiasi classe che discende da THPDFRandomAccessSource, e THPDFCoalescingRandomAccessSource sta in mezzo tra quella classe e il parser. Ogni lettura viene arrotondata a un blocco allineato e il blocco resta in memoria. BlockSize fa default a 262.144 byte e MaxCacheBytes a 2.097.152, quindi otto blocchi restano residenti e quello usato meno di recente esce quando il budget si riempie. La ricerca da 40 byte di una chiave del trailer del parser tira dentro i 256 KiB attorno, e la successiva dozzina di letture in quel quartiere (voci della cross-reference, il Catalog, chiavi dell'albero di pagine) esce dalla memoria
La vostra classe resta sottile. Due metodi sono obbligatori: GetSize e ReadAt. Fate override di ReadAtCancellable quando il vostro client HTTP può abortire una richiesta in volo, e di IsRangeAvailable quando la sorgente è un download ancora in corso. Il wrapper pone quella domanda prima di ogni fetch: se un intero blocco non c'è ancora riprova con soli i byte richiesti, e se mancano anche quelli la lettura torna corta invece di bloccarsi
type
  // TMyHttpClient rappresenta la vostra classe client HTTP
  THttpRangeSource = class(THPDFRandomAccessSource)
  private
    FClient: TMyHttpClient;
    FUrl: string;
    FSize: Int64;
  public
    constructor Create(const AUrl: string);
    function GetSize: Int64; override;
    function ReadAt(Offset: Int64; var Buffer; Count: Longint): Longint; override;
    function ReadAtCancellable(Offset: Int64; var Buffer; Count: Longint;
      CancellationToken: THPDFCancellationToken): Longint; override;
  end;

var
  Raw: THttpRangeSource;
  Cached: THPDFCoalescingRandomAccessSource;
  Pdf: THotPDF;
begin
  Raw := THttpRangeSource.Create('https://files.example.com/contract.pdf');
  // OwnsSource=True: il wrapper libera Raw; blocchi da 256 KiB, budget di 8 MiB
  Cached := THPDFCoalescingRandomAccessSource.Create(Raw, True, 262144, 8388608);
  Cached.MaxReadAheadBlocks := 8;   // intervallo valido 1..32
  Pdf := THotPDF.Create(nil);
  try
    // OwnsSource=True di nuovo: Pdf libera Cached, che libera Raw
    if Pdf.LoadFromRandomAccessSource(Cached, True) > 0 then
      RenderFirstPage(Pdf);   // codice vostro
  finally
    Pdf.Free;
  end;
end;
Prefetch asincrono e read-ahead adattivo sono entrambi attivi appena il wrapper è costruito, quindi l'esempio tocca soltanto il tetto della finestra. Il costruttore valida i propri argomenti in partenza: BlockSize deve stare tra 4.096 e 16.777.216 byte e MaxCacheBytes deve contenere almeno un blocco, altrimenti ricevete un ERangeError prima che un solo byte si muova
Non vi serve rigorosamente il wrapper esplicito. Consegnate a LoadFromRandomAccessSource una sorgente semplice e HotPDF la avvolge per voi, usando la politica di cache raw che potete leggere e cambiare attraverso GetCacheAdmissionPolicy e SetCacheAdmissionPolicy con il layer clkRawCompressed: otto voci, 2 MiB in totale, 256 KiB per voce. Consegnate il vostro THPDFCoalescingRandomAccessSource e viene usato esattamente com'è configurato. Per qualsiasi cosa attraversi una rete, costruite voi il wrapper; avete le manopole del read-ahead e il record completo di statistiche, mentre il percorso automatico riporta solo i conteggi di hit, miss, ammissione ed eviction attraverso GetCacheAdmissionStatistics
Quanto in avanti dovrebbe leggere?
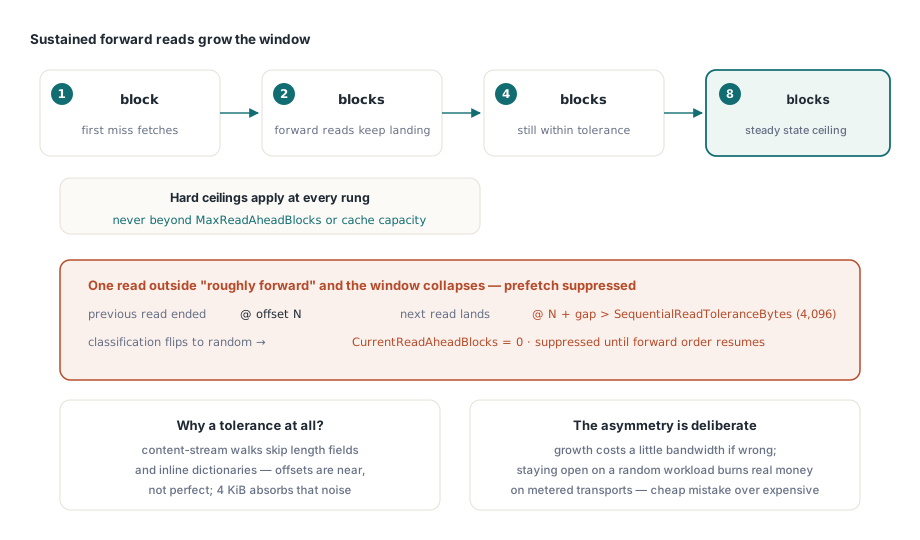
Il read-ahead adattivo decide per documento. Con AdaptiveReadAheadEnabled impostato, ogni lettura che il parser fa attraverso il documento caricato è classificata sequenziale o casuale, e la finestra di prefetch segue un punteggio. Due letture in avanti consecutive aprono la finestra a due blocchi, quattro la aprono a quattro, sei la aprono a otto. La finestra non supera mai MaxReadAheadBlocks, e non supera mai il numero di blocchi che stanno in MaxCacheBytes, così una cache piccola non può essere sommersa dal proprio prefetch
Una lettura che salta indietro, o atterra troppo oltre la fine della lettura precedente, fa scendere il punteggio sotto zero. La finestra si chiude, qualsiasi prefetch diretto altrove viene annullato, e SuppressedPrefetchCount sale. Due letture in avanti dopo la finestra si riapre a un blocco singolo. Quel ritardo è il punto: una lettura contigua fortunata in mezzo a una caccia alla cross-reference non rimette in moto la speculazione
SequentialReadToleranceBytes, 4.096 per default, definisce «troppo oltre». Un parser che cammina su un content stream non produce offset perfettamente contigui; salta un campo di lunghezza qui, un dizionario di immagine inline là. Le letture che atterrano entro la tolleranza dalla fine precedente contano comunque come in avanti. Impostatela troppo bassa e una scansione in avanti normale viene classificata casuale, così il read-ahead non si mette mai in moto. Impostatela troppo alta e un accesso casuale vero sembra sequenziale, e fate arrivare megabyte che nessuno legge. Il setter accetta qualsiasi valore da zero fino a BlockSize e azzera il punteggio quando cambia
La crescita è graduale, il collasso è immediato, e quell'asimmetria è deliberata. Il sovrantemento su un carico casuale brucia banda reale, e su un trasporto a consumo soldi veri; il sotto-prelievo su uno sequenziale costa qualche round trip in più. Lasciate AdaptiveReadAheadEnabled acceso. Spento, il wrapper fa il prefetch di un blocco dopo ogni lettura indipendentemente dallo schema, che è esattamente il comportamento sbagliato mentre il parser salta tra le sezioni della cross-reference
La classificazione è guidata dallo stream da cui HotPDF legge durante un caricamento. Se il vostro codice tira byte attraverso il wrapper anche lui, per esempio per hashare un file o estrarre un allegato, chiamate ObserveReadPattern con offset e lunghezza dopo ogni lettura così la finestra reagisce anche a quel traffico. Quando sapete già quali byte serviranno dopo, PrefetchRange fa partire direttamente un fetch in background; IsPrefetchActive riporta se uno sta ancora girando
Conservare i blocchi caldi quando la cache è piena
L'eviction least-recently-used semplice ha una debolezza nota. Un lungo passaggio in avanti, per esempio dentro una grande immagine incorporata, spinge fuori ogni blocco a cui il parser continua a tornare, inclusi i blocchi della cross-reference e del Catalog che gli serviranno di nuovo alla pagina successiva. THPDFCoalescingRandomAccessSource conta quante volte ogni blocco è stato richiesto, e una volta che il budget è pieno un blocco nuovo entra nella cache solo se è stato richiesto almeno quanto il blocco che sostituirebbe. Altrimenti la lettura va dritta alla vostra sorgente per esattamente i byte richiesti, e RejectionCount e FrequencyRejectionCount lo registrano
Quella regola è attiva per default (l'argomento costruttore AdaptiveAdmission). ConfigureCacheAdmission cambia il budget in byte, il tetto per voce, un limite opzionale di numero di voci e la regola di ammissione su un wrapper vivo; annulla qualsiasi prefetch in corso e riduce la cache ai nuovi limiti sul posto
Un annullamento che ferma davvero il trasferimento
Il prefetch gira su un solo thread in background, e il wrapper lo annulla appena smette di valere la fatica finirlo. Una lettura in primo piano per byte fuori dal range in prefetch lo annulla, così la pagina che l'utente ha chiesto non aspetta mai dietro traffico speculativo. Una lettura casuale lo annulla. Distruggere il wrapper, o chiamare CancelPrefetch o ClearCache, lo annulla e aspetta che il thread esca. Ognuna di queste imposta il THPDFCancellationToken che il thread di prefetch passa al vostro ReadAtCancellable
Se i byte smettano davvero di fluire dipende dal vostro override. Il default ReadAtCancellable su THPDFRandomAccessSource controlla il token prima e dopo un semplice ReadAt, che basta per una condivisione file ma lascia correre fino in fondo una risposta HTTP da 256 KiB mezza fatta. Un client che legge il corpo della risposta a chunk può controllare il token tra i chunk e abortire:
function THttpRangeSource.ReadAt(Offset: Int64; var Buffer;
  Count: Longint): Longint;
begin
  Result := ReadAtCancellable(Offset, Buffer, Count, nil);
end;

function THttpRangeSource.ReadAtCancellable(Offset: Int64; var Buffer;
  Count: Longint; CancellationToken: THPDFCancellationToken): Longint;
var
  Status: Integer;
begin
  if CancellationToken <> nil then
    CancellationToken.ThrowIfCancellationRequested('http range read');
  // GetRange e il suo callback sono l'API del vostro client: invia
  // "Range: bytes=Offset-(Offset+Count-1)" e chiama il callback tra i chunk del corpo
  Result := FClient.GetRange(FUrl, Offset, Count, Buffer, Status,
    function: Boolean
    begin
      Result := (CancellationToken <> nil) and
        CancellationToken.IsCancellationRequested;
    end);
  // 200 invece di 206 significa che il server ha ignorato Range e spedito l'intero file
  if Status <> 206 then
    raise EStreamError.CreateFmt('Range request not honored (HTTP %d)', [Status]);
  if CancellationToken <> nil then
    CancellationToken.ThrowIfCancellationRequested('http range read');
end;
Il controllo dello stato copre la trappola che la maggior parte delle sorgenti HTTP becca per prima. La RFC 9110 §14 lascia che un server ignori un header Range e risponda 200 con la rappresentazione intera, e alcune configurazioni di CDN e proxy fanno esattamente quello per certi file. Una sorgente che copia i primi Count byte di una risposta 200 consegna al parser byte dall'offset zero a prescindere da quale offset abbia chiesto. I valori di ritorno contano pure: il wrapper solleva EStreamError se ReadAt riporta un conteggio negativo o più byte di quelli richiesti, e tratta zero come fine dati
L'unico token non nullo che la vostra sorgente riceve appartiene al thread di prefetch. Le letture del parser durante un caricamento raggiungono il vostro ReadAtCancellable con token nullo, quindi fermare il caricamento stesso è un interruttore separato: assegnate un token a THotPDF.OperationCancellationToken, e il caricamento del documento lo controlla mentre va. Lo stesso modello a token guida la coda descritta in il rendering in background con una coda di richieste, così un viewer può cancellare un caricamento, i suoi render e il suo traffico di rete speculativo da un solo handler di chiusura
Leggere le statistiche della cache dei range
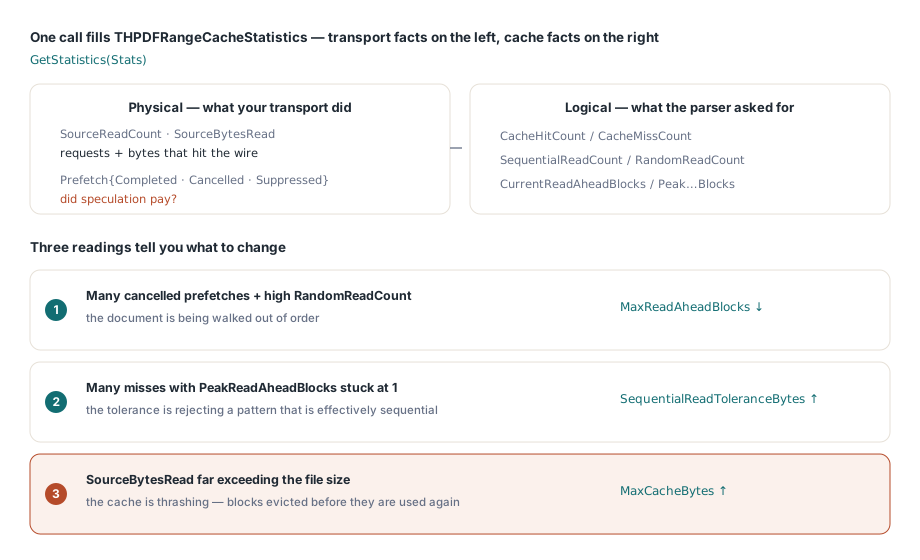
GetStatistics riempie un record THPDFRangeCacheStatistics che conserva ciò che ha fatto il vostro trasporto separato da ciò che ha fatto la cache. SourceReadCount e SourceBytesRead sono traffico fisico. CacheHitCount e CacheMissCount sono traffico logico. SequentialReadCount e RandomReadCount mostrano come è stato classificato lo schema di accesso, CurrentReadAheadBlocks e PeakReadAheadBlocks mostrano quanto si è aperta la finestra, e i quattro contatori di prefetch mostrano se la speculazione ha pagato. CachedRangeCount, CachedBytes, EvictionCount e RejectionCount descrivono la cache stessa
var
  S: THPDFRangeCacheStatistics;
begin
  Cached.GetStatistics(S);
  Log(Format('physical %d reads / %d bytes, hits %d, misses %d',
    [S.SourceReadCount, S.SourceBytesRead, S.CacheHitCount, S.CacheMissCount]));
  Log(Format('pattern: %d sequential, %d random, peak window %d blocks',
    [S.SequentialReadCount, S.RandomReadCount, S.PeakReadAheadBlocks]));
  Log(Format('prefetch: %d issued, %d completed, %d canceled, %d suppressed',
    [S.PrefetchRequestCount, S.PrefetchCompletedCount,
     S.PrefetchCancelledCount, S.SuppressedPrefetchCount]));
  Log(Format('cache: %d blocks / %d bytes, %d evicted, %d rejected',
    [S.CachedRangeCount, S.CachedBytes, S.EvictionCount, S.RejectionCount]));

  // Rifiuti che si accumulano su un documento per lo più sequenziale: dategli più spazio
  if S.RejectionCount > S.CacheHitCount then
    Cached.ConfigureCacheAdmission(16 * 1024 * 1024, Cached.BlockSize, 0);
end;
Tre letture vi dicono cosa cambiare. Molti prefetch annullati accanto a un conteggio alto di letture casuali significano che il documento viene percorso fuori ordine, quindi abbassate MaxReadAheadBlocks e smettete di pagare banda che buttate via. Molti miss con la finestra di picco bloccata a 1 significano che la tolleranza sta rifiutando uno schema in effetti sequenziale, quindi alzate SequentialReadToleranceBytes. SourceBytesRead molto sopra la dimensione del file significa che i blocchi vengono evasi prima di essere riusati; alzate MaxCacheBytes prima di toccare qualsiasi altra cosa. La soglia di rifiuto nell'esempio è la nostra euristica di partenza, quindi taratela sul vostro traffico
I file linearizzati cambiano l'aritmetica
Se controllate il producer, linearizzare il documento cambia il problema invece di tararlo. ISO 32000-1 Allegato F mette gli oggetti della prima pagina e una tabella di hint in testa al file, così un viewer può renderizzare la pagina uno dai byte di apertura senza toccare il resto. HotPDF espone quel percorso attraverso GetProgressiveLinearizedLoadInfo e ReadProgressiveLinearizedFirstPageSection, che prendono entrambe la stessa THPDFRandomAccessSource che avreste avvolta per il coalescing; il lato scrittura è coperto in generare PDF linearizzati con tabelle di hint
Le due tecniche si compongono. Il coalescing rende tollerabile qualsiasi documento su un collegamento lento, compresi file di terze parti che non potete risalvare; la linearizzazione fa arrivare veloce la prima pagina sui documenti che producete voi. I file su disco locale troppo grandi da tenere in memoria sono un problema diverso, senza latenza di round trip da ammortizzare, e i percorsi mapped-file e lazy-stream in il workflow della direct file API stanno meglio a loro
Le classi di sorgente ad accesso casuale, il wrapper di coalescing, le politiche di ammissione in cache e le chiamate di caricamento linearizzato progressivo viaggiano tutte con HotPDF, un componente PDF nativo per Delphi e C++Builder con sorgente completa. Licenze e riferimento API completo sono sulla pagina del componente HotPDF Delphi PDF