Il vostro codice di rilevamento vi dice che un file PDF/UA di un altro produttore non dichiara nulla, e una scansione PDF/R smette di essere PDF/R nel momento in cui un editor aggiunge una sticky note. HotPDF legge queste dichiarazioni da un documento caricato attraverso accessor come IsLoadedPDFUA, GetLoadedPDFR1Version e GetLoadedPDFDeclarations, ognuno dei quali guarda dove il suo standard conserva l'identificatore
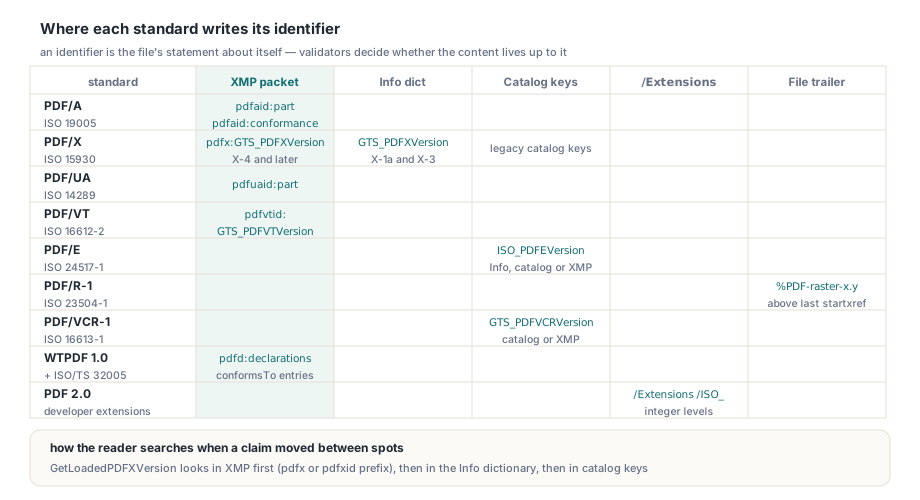
Dove ogni standard PDF scrive il suo identificatore
Gli standard sussidiari non si sono mai accordati su un unico posto per la dichiarazione. La maggior parte usa proprietà XMP nello stream /Metadata del catalogo, qualche standard più vecchio conta ancora su chiavi nel dizionario delle informazioni del documento, PDF/R mette una riga di commento accanto al trailer del file, e la generazione PDF 2.0 aggiunge altri due meccanismi: dizionari di developer extension nel catalogo e PDF Declarations dentro XMP. Un identificatore è la dichiarazione che il file fa su di sé; se il contenuto sta alla sua promessa lo decide un validatore, e produrre output PDF/A, PDF/X e PDF/UA conformi è un tema a sé. Per il routing (coda di stampa per PDF/X, archivio per PDF/A, pipeline di accessibilità per WTPDF) la dichiarazione è ciò che vi serve, letta dal punto giusto:
| Standard | Dove vive la dichiarazione | Accessor HotPDF |
|---|---|---|
| PDF/A (ISO 19005) | XMP pdfaid:part e pdfaid:conformance, più pdfaid:rev in PDF/A-4 | IsLoadedPDFA, GetLoadedPDFAVersion, GetLoadedPDFARevision |
| PDF/X (ISO 15930) | GTS_PDFXVersion nel dizionario Info per PDF/X-1a e PDF/X-3, in XMP per le parti successive | IsLoadedPDFX, GetLoadedPDFXVersion |
| PDF/UA (ISO 14289) | XMP pdfuaid:part | IsLoadedPDFUA, GetLoadedPDFUAVersion |
| PDF/VT (ISO 16612-2) | XMP pdfvtid:GTS_PDFVTVersion | IsLoadedPDFVT, GetLoadedPDFVTVersion |
| PDF/E (ISO 24517-1) | ISO_PDFEVersion, letto dal dizionario Info, dal catalogo o da XMP | IsLoadedPDFE, GetLoadedPDFEVersion |
| PDF/R-1 (ISO 23504-1) | commento %PDF-raster-x.y direttamente sopra l'ultimo startxref | IsLoadedPDFR1, GetLoadedPDFR1Version |
| PDF/VCR-1 (ISO 16613-1) | GTS_PDFVCRVersion nel catalogo o in XMP | IsLoadedPDFVCR, GetLoadedPDFVCRVersion |
| WTPDF 1.0, ISO/TS 32005 | voci pdfd:declarations in XMP | IsLoadedWTPDF, GetLoadedWTPDFVersion, IsLoadedISO32005 |
| Developer extension PDF 2.0 | /Extensions /ISO_ nel catalogo | HasLoadedISODeveloperExtension, GetLoadedISODeveloperExtensionLevels |
uses
  System.SysUtils, HPDFDoc;

procedure ReportClaims(const FileName: string; const Password: AnsiString);
var
  Pdf: THotPDF;
  PDFX, PDFXLevel: AnsiString;
begin
  Pdf := THotPDF.Create(nil);   // istanza dedicata, usata solo per ispezionare
  try
    // La variante con password decifra gli stream, pacchetto XMP incluso;
    // una stringa vuota per i file che aprono senza prompt
    if Pdf.LoadFromFile(FileName, Password) <= 0 then
      raise Exception.CreateFmt('Cannot open %s', [FileName]);

    if Pdf.IsLoadedPDFA then
      Writeln('PDF/A: ', Pdf.GetLoadedPDFAVersion);        // es. PDF/A-2b
    PDFX := Pdf.GetLoadedPDFXVersion;                       // XMP, poi Info
    if PDFX <> '' then
    begin
      PDFXLevel := Pdf.GetLoadedInfoKeyValue('GTS_PDFXConformance');
      if PDFXLevel <> '' then
        Writeln('PDF/X: ', PDFX, ', conformance ', PDFXLevel)
      else
        Writeln('PDF/X: ', PDFX);
    end;
    if Pdf.IsLoadedPDFUA then
      Writeln('PDF/UA: ', Pdf.GetLoadedPDFUAVersion);      // es. PDF/UA-1
    if Pdf.IsLoadedPDFVT then
      Writeln('PDF/VT: ', Pdf.GetLoadedPDFVTVersion);
    if Pdf.IsLoadedPDFE then
      Writeln('PDF/E: ', Pdf.GetLoadedPDFEVersion);
    if Pdf.IsLoadedPDFR1 then
      Writeln('PDF/R: ', Pdf.GetLoadedPDFR1Version);       // es. PDF/R-1.0
    if Pdf.IsLoadedWTPDF then
      Writeln('WTPDF: ', Pdf.GetLoadedWTPDFVersion);
  finally
    Pdf.Free;
  end;
end;
Usate un'istanza THotPDF separata per ispezionare, come fa l'esempio. Le funzioni IsLoaded… rispondono per qualunque documento il componente tenga, incluso uno che sta costruendo: IsLoadedPDFUA è anche True quando PDFUACompliance è stata accesa per l'output, e IsLoadedPDFX concorda con una PDFXCompliance non vuota. Comodo a costruzione in corso, ma su un componente riusato per entrambi i mestieri mescola le vostre impostazioni di output nel verdetto sul file di qualcun altro
PDF/X è l'unica famiglia il cui identificatore si è spostato tra le parti. PDF/X-1a e PDF/X-3 sono profili PDF 1.3 che mettono GTS_PDFXVersion nel dizionario delle informazioni del documento e non richiedono proprio XMP, mentre PDF/X-4 e le parti successive esigono la proprietà XMP pdfx:GTS_PDFXVersion. GetLoadedPDFXVersion guarda prima in XMP, sia con il prefisso pdfx sia con pdfxid, poi nel dizionario Info, poi nelle chiavi di catalogo che qualche produttore d'altri tempi scrive, e restituisce il valore dichiarato immutato. PDF/X-1a ha una piega che vale la pena gestire nel codice: il suo valore di versione è PDF/X-1:2001, e il livello di conformità PDF/X-1a:2001 vive in una chiave tutta sua, /GTS_PDFXConformance, che l'esempio legge con GetLoadedInfoKeyValue quando deve distinguere X-1a dal semplice X-1
Come si presenta una dichiarazione XMP valida?
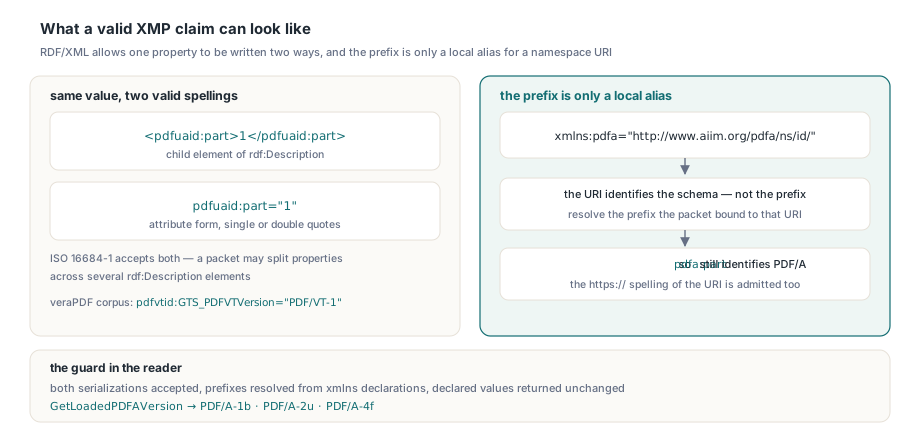
XMP è RDF serializzato come XML, e RDF/XML permette di scrivere una proprietà semplice in due modi dentro un rdf:Description: come elemento figlio, <pdfuaid:part>1</pdfuaid:part>, o come attributo sulla descrizione stessa, pdfuaid:part="1", con apici singoli o doppi. ISO 16684-1 accetta entrambi, e un pacchetto può spartire le sue proprietà su più elementi rdf:Description. La divisione non è ipotetica. HotPDF scrive la forma a elemento figlio per PDF/UA, PDF/VT, PDF/E e PDF/X, mentre il corpus di test di veraPDF e tanti produttori esterni scrivono la forma breve, con descrizioni come pdfuaid:part="1" o pdfvtid:GTS_PDFVTVersion="PDF/VT-1" che portano l'intera dichiarazione negli attributi. Un rilevatore costruito intorno a Pos('<pdfuaid:part>', Xmp) e provato solo su output interno passa ogni verifica locale e poi dichiara non dichiarato il primo campione veraPDF arrivato. Il lettore XMP di HotPDF gestisce entrambe le forme per ogni accessor della tabella. GetLoadedPDFAVersion combina pdfaid:part e pdfaid:conformance in identificatori come PDF/A-1b, PDF/A-2u, PDF/A-4 o PDF/A-4f, e GetLoadedPDFARevision restituisce pdfaid:rev, l'anno di edizione che PDF/A-4 richiede (2020) e che le parti da 1 a 3 non definiscono:
procedure ReportPDFALevel(Pdf: THotPDF);
var
  Level, Revision: AnsiString;
begin
  Level := Pdf.GetLoadedPDFAVersion;      // es. PDF/A-1b, PDF/A-2u, PDF/A-4f
  if Level = '' then
    Exit;
  Revision := Pdf.GetLoadedPDFARevision;  // 2020 per PDF/A-4, vuoto per le parti 1-3
  if Revision <> '' then
    Writeln(Level, ', edition ', Revision)
  else
    Writeln(Level);
  // Atteso: PDF/A-2b sia che il produttore abbia scritto
  // <pdfaid:part>2</pdfaid:part> oppure pdfaid:part="2"
end;
I prefissi sono l'altro pezzo mobile. In XML il prefisso è solo un alias locale; a identificare lo schema PDF/A è l'URI di namespace http://www.aiim.org/pdfa/ns/id/, che gli errata approvati di ISO 19005-4 ammettono anche nella forma https://, e un produttore può legarlo a qualunque prefisso gli piaccia. GetLoadedPDFAVersion risolve il prefisso che il pacchetto dichiara per quell'URI prima di leggere parte e livello, così un pacchetto che scrive pdfa:part invece di pdfaid:part si identifica comunque. Qualunque altra proprietà XMP che leggete voi dal pacchetto decodificato che GetLoadedXMPMetadata restituisce merita la stessa cura: entrambe le serializzazioni, il prefisso risolto dalla sua dichiarazione xmlns, e spazi bianchi ammessi intorno al segno di uguale
I file cifrati nascondono la dichiarazione alle ricerche per byte
Una scansione del file grezzo alla ricerca di pdfaid o ISO_PDFEVersion salta il parsing e si rompe su due casi ordinari. La maggior parte degli stream XMP è compressa Flate, così i nomi delle proprietà non compaiono mai come testo su disco. E in un documento cifrato lo stream dei metadati è ciphertext: ISO 32000-2 §7.6.4.2 definisce EncryptMetadata con valore predefinito true, quindi a meno che il produttore non abbia rinunciato esplicitamente, il pacchetto è cifrato insieme a ogni altro stream. Una ricerca per byte su un file PDF/E-1 cifrato riporta quindi come assente la dichiarazione ISO_PDFEVersion benché ci sia. L'ordine affidabile è caricare, decifrare, decodificare, poi cercare. Aprite il file attraverso l'overload con password, LoadFromFile(FileName, Password), e passate una stringa vuota per i file che portano solo una owner password e aprono in qualunque viewer senza prompt. Il LoadFromFile(FileName) a un solo argomento carica la struttura del documento senza decifrarne gli stream, il che lascia il pacchetto XMP illeggibile; dopo l'overload con password, GetLoadedXMPMetadata e ogni accessor di cui sopra lavorano sul pacchetto decifrato e decompresso
Perché un file PDF/R perde la propria identità dopo una modifica?
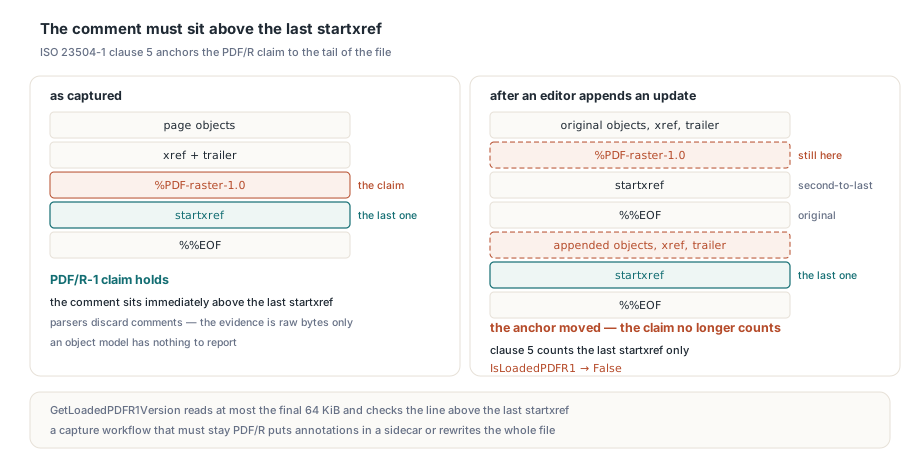
PDF/R-1 si identifica in un modo che nessun altro standard sussidiario usa. La clausola 5 di ISO 23504-1 esige una riga di commento %PDF-raster-1.0 (o la versione che compete) sulla riga immediatamente prima dell'ultima riga che contiene startxref. Un parser PDF butta via i commenti mentre legge i dati di riferimento incrociato, così un modello a oggetti non ha niente da riferire; la prova esiste solo nei byte grezzi in coda al file. GetLoadedPDFR1Version torna alla sorgente da cui il documento è stato caricato, legge al massimo gli ultimi 64 KiB, trova l'ultimo startxref e controlla la riga sopra. Ora seguite un aggiornamento incrementale. Un editor che aggiunge un'annotazione accoda nuovi oggetti, una nuova sezione di riferimento incrociato, un nuovo trailer e un nuovo startxref dopo l'%%EOF originale. La riga %PDF-raster-1.0 è ancora nel file, ma ora siede sopra il penultimo startxref, e lo standard non ha ambiguità su quale conti. Atteso: IsLoadedPDFR1 restituisce False dopo la modifica, a meno che lo strumento di editing non riemetta il commento nel suo aggiornamento. Un rilevatore che scandisce l'intero file in cerca di %PDF-raster- direbbe di sì, e secondo la regola della clausola 5 quella risposta è sbagliata. Un flusso di capture che deve mantenere i suoi file PDF/R mette le annotazioni in un file sidecar o in uno strumento che riscrive l'intero file come PDF/R
Developer extension: livelli interi, nomi e array
I documenti PDF 2.0 annunciano le specifiche tecniche ISO da cui dipendono (hash SHA-3 da ISO/TS 32001, firme ECC da ISO/TS 32002, asset glTF da ISO/TS 32007) attraverso il dizionario /Extensions del catalogo, definito in ISO 32000-2 §7.12. Sotto il prefisso registrato /ISO_, la Tabella 48 ammette un singolo dizionario di developer extension oppure, novità del PDF 2.0, un array di essi, e la Tabella 49 insieme al §7.12.5 fa di /ExtensionLevel un intero. Un lettore che gestisce una sola delle due forme di contenitore perde ogni file scritto nell'altra. HasLoadedISODeveloperExtension e GetLoadedISODeveloperExtensionLevels accettano entrambe, e lungo la strada risolvono i riferimenti indiretti, benché il §7.12.1 dica che questi dizionari debbano essere oggetti diretti:
procedure ReportISOExtensions(Pdf: THotPDF);
var
  Levels: THPDFIntegerArray;
  Revision, URL: AnsiString;
  I: Integer;
begin
  Levels := Pdf.GetLoadedISODeveloperExtensionLevels;
  for I := 0 to High(Levels) do
    Writeln('ISO_ extension level ', Levels[I]);

  if Pdf.HasLoadedISODeveloperExtension(32001, Revision, URL) then
    Writeln('ISO/TS 32001 revision ', Revision, ', documented at ', URL);
  // Atteso per un file scritto con EnsureISO32001Extensions:
  //   ISO/TS 32001 revision :2022, documented at https://www.iso.org/standard/45874.html
  if Pdf.HasLoadedISODeveloperExtension(32007) then
    Writeln('glTF 3D assets per ISO/TS 32007');
end;
La prima edizione di ISO/TS 32007:2024 ha un esempio nel §4.8 che scrive /ExtensionLevel /32007 come nome; il PDF Errata Issue #835 l'ha corretto nell'intero 32007, ma un produttore che ha copiato l'esempio originale scrive ancora il nome. Il lettore di HotPDF quindi ripiega sul parsing di un valore nome o stringa, con o senza la barra iniziale, quando la ricerca dell'intero torna vuota, così HasLoadedISODeveloperExtension(32007) trova entrambe le grafie. L'altro erratum riguarda /URL: la Tabella 49 di ISO 32000-2:2020 elenca /URL come facoltativa, e l'Issue #732 la promuove a obbligatoria. Sul lato scrittura HotPDF emette la forma intera e una /URL in ogni chiamata EnsureISO…Extensions; sul lato lettura un parametro out URL vuoto è normale per i file scritti secondo il testo 2020, quindi tratteggiatelo come informazione e mai come motivo per respingere l'estensione
Quale URI WTPDF ha scritto il produttore?
Le dichiarazioni WTPDF 1.0 e ISO/TS 32005 sono PDF Declarations: voci in un bag pdfd:declarations in XMP, sotto il namespace http://pdfa.org/declarations/ definito dalla nota tecnica PDF Declarations della PDF Association. Ogni voce porta un URI conformsTo e i campi facoltativi claimBy, claimDate, claimCredentials e claimReport, che GetLoadedPDFDeclarations restituisce come array di record THPDFDeclarationEntry; sul lato scrittura, AddPDFDeclaration mette gli stessi cinque campi nel pacchetto XMP, accanto ai namespace di identificazione PDF 2.0, PDF/A-4 e PDF/UA-2. Tagliare il bag in voci con una ricerca di testo semplice ha il suo inciampo: se dividete a ogni occorrenza di conformsTo, il tag di chiusura </pdfd:conformsTo> della forma a elemento figlio conta come inizio di una nuova voce, e la prima dichiarazione viene troncata prima della propria fine. Il lettore di HotPDF salta i tag di chiusura e accetta entrambe le serializzazioni
Gli URI sono la parte più difficile. La stessa dichiarazione vi arriva come http:// o https://, e il WTPDF 1.0 Issue #395 ha cambiato se una / stia prima del #, così i file scritti prima e dopo l'erratum differiscono in quell'unico carattere; un confronto tra stringhe semplice li tratta come standard diversi. HasLoadedPDFDeclaration confronta gli URI senza distinguere le maiuscole, riporta https:// su http:// e butta via una / direttamente prima di # su entrambi i lati, così la query sotto stacca qualunque grafia il produttore abbia scelto. Il frammento resta intatto: #accessibility1.0 e #accessibility1.0-validated sono dichiarazioni diverse, la seconda afferma che un validatore ha controllato il file, e dovete chiedere quella che al vostro flusso interessa. GetLoadedWTPDFVersion collassa entrambe in 'WTPDF 1.0 Accessibility' o 'WTPDF 1.0 Reuse' per il routing
procedure ReportDeclarations(Pdf: THotPDF);
var
  Decls: THPDFDeclarationEntryArray;
  I: Integer;
begin
  Decls := Pdf.GetLoadedPDFDeclarations;
  for I := 0 to High(Decls) do
    Writeln(Decls[I].ConformsTo, ' claimed by ', Decls[I].ClaimBy,
      ' on ', Decls[I].ClaimDate);

  // Stacca http e https, con o senza la barra prima del cancelletto
  if Pdf.HasLoadedPDFDeclaration(
    'https://pdfa.org/declarations/wtpdf#accessibility1.0') then
    Writeln('WTPDF 1.0 Accessibility (unvalidated claim)');

  // Copre le varianti semplice e -validated di Reuse e di Accessibility
  Writeln('WTPDF profile: ', Pdf.GetLoadedWTPDFVersion);
end;
Per un router di capture o di stampa, l'ordine delle operazioni conta più di ogni singolo accessor: provate IsLoadedPDFR1 sul file così com'è arrivato, prima che un passo di annotazione o timbratura accodi il suo aggiornamento, e instradate PDF/X su GetLoadedPDFXVersion, che copre sia il dizionario Info dei lavori PDF/X-1a e PDF/X-3 sia l'XMP dei lavori PDF/X-4, leggendo /GTS_PDFXConformance solo dove X-1a va distinto dal semplice X-1. Entrambi i controlli girano su qualunque documento caricato nel componente PDF HotPDF per Delphi, file cifrati aperti con la loro password inclusi