Un JPEG CMYK che esce da un PDF con colori fangosi, spostati o negativi quasi sempre significa che il decoder si è sbagliato su uno di due fatti: se i campioni erano memorizzati come YCCK e vanno convertiti, o se erano memorizzati invertiti per convenzione Adobe. I decoder di HotPDF rispettano il parametro DCTDecode /ColorTransform per le immagini a tre e quattro canali, rifiutano i valori che la specifica non definisce, e lasciano che un marker Adobe APP14 dentro i dati JPEG prenda il sopravvento su quella voce del dizionario, come richiede ISO 32000-1 Table 13. Due regole vicine appartengono alla stessa famiglia di trappole: gli stream multi-filtro devono portare array /DecodeParms allineati agli stadi, e le immagini JPEG 2000 conservano una mappatura /Decode esplicita
Tutte e tre condividono un tema. Il PDF già dice cosa intende, e la trappola è un renderer che risponde a una domanda leggermente diversa
Perché un JPEG CMYK esce invertito o sbiadito in un PDF?
Un JPEG CMYK va storto in un PDF per uno di due motivi, e i due si vedono diversi sullo schermo. Un'immagine negativa, dove la carta bianca diventa nera e le tinte chiare vanno al buio, punta a una memorizzazione invertita. Un'immagine sbiadita o con tonalità spostate, dove la pelle diventa verde e i neri vanno al grigio mentre il dettaglio del canale K resta nitido, punta a una trasformazione di colore applicata quando non andava applicata, o saltata quando era richiesta
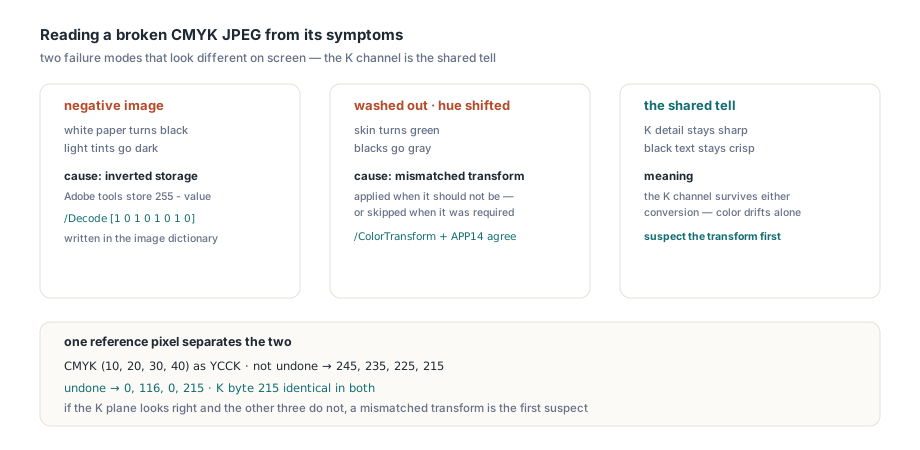
Il problema della trasformazione viene da come il JPEG comprime il colore. Il JPEG baseline comprime al meglio quando la luminanza è separata dalla crominanza, quindi gli encoder di solito convertono RGB in YCbCr prima della compressione, e gli encoder a quattro canali convertono CMY in YCC lasciando passare il K intatto, che è il formato chiamato YCCK. Il decoder deve disfare esattamente la conversione che l'encoder ha applicato. Disfatene una che non è mai avvenuta, o saltatene una che c'è stata, e ogni pixel si muove. Il canale nero sopravvive comunque, ed è per questo che un'immagine CMYK rotta spesso mantiene un testo nero nitido mentre tutto il resto deriva
Il problema dell'inversione è storico. Photoshop e gli altri strumenti Adobe scrivono JPEG CMYK con ogni campione memorizzato come 255 - valore, e contrassegnano il file con un marker Adobe APP14. Nulla nello standard JPEG lo dice; è una convenzione, e ogni consumatore deve saperlo. In un PDF, ci si aspetta che il produttore esprima l'inversione nel dizionario immagine invece di lasciarla all'indovinello
Cosa dice /ColorTransform al decoder?
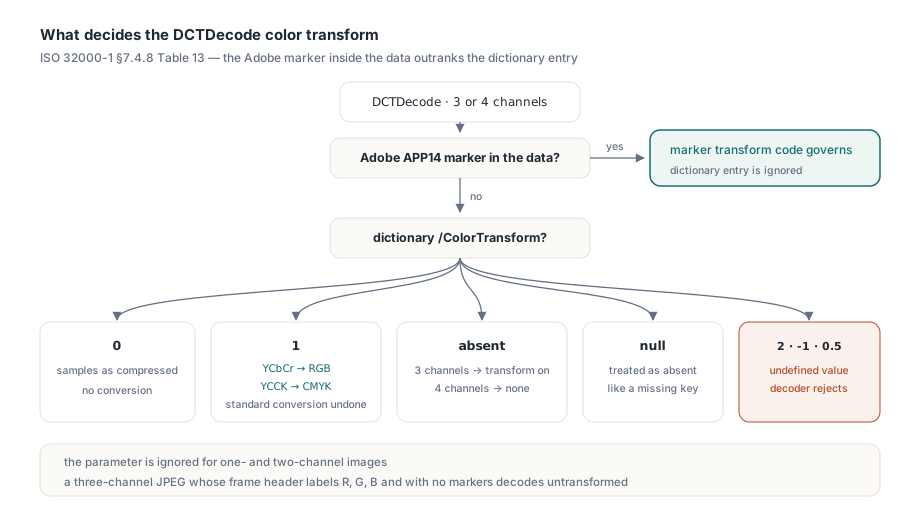
/ColorTransform è l'enunciato a livello PDF di quale conversione il decoder deve disfare. ISO 32000-1 §7.4.8, Table 13, definisce due valori. Zero significa nessuna trasformazione: il decoder restituisce i campioni come compressi. Uno significa che l'encoder ha applicato la conversione standard, quindi un'immagine a tre canali torna da YCbCr a RGB e un'immagine a quattro canali torna da YCCK a CMYK. Il parametro è ignorato per le immagini a uno e due canali. Table 13 fissa anche una regola di precedenza facile da perdere: quando i dati codificati portano un marker Adobe con il suo codice di transform, quel codice comanda e la voce del dizionario è ignorata. Solo un JPEG senza quel marker ripiega sul dizionario, e quando anche la voce manca, un'immagine a tre canali ha per default la trasformazione e una a quattro canali nessuna
L'errore facile è un percorso immagine che accetta il dizionario parametri ma non lo passa mai al decoder JPEG. Un JPEG RGB di un pixel che tiene il colore (128, 63, 31) lo smaschera all'istante: un decoder simile restituisce [128, 63, 31] sia per /ColorTransform 0 sia per /ColorTransform 1, mentre la risposta corretta per zero è la terna YCbCr grezza [79, 101, 163]
HotPDF applica il parametro a livello di byte. HPDFDecodeHeadlessTerminalImage prima percorre la struttura dei segmenti JPEG fino al marker start-of-scan e cerca un segmento Adobe APP14; byte che assomigliano a uno dentro un segmento di commento non contano. Se i dati portano il marker, il suo codice di transform decide e il valore del dizionario è ignorato. Se non lo portano, il decoder costruisce una copia privata del JPEG con un segmento APP14 inserito subito prima del marker start-of-scan, che porta codice di transform 0, 1, o, per un'immagine a quattro canali con valore 1, il codice YCCK 2. Ogni volta che la trasformazione effettiva di un'immagine a tre canali è 0, la copia disarma anche l'header JFIF, perché un header JFIF da solo dice a libjpeg-turbo di assumere YCbCr. Il buffer di chi chiama non viene mai toccato, e quando un segmento viene inserito, i suoi 16 byte extra vengono addebitati sul budget di byte di lavoro prima che il decoder allochi qualsiasi cosa
Inserire solo quando non esiste un marker conta per via di un dettaglio di libjpeg: usa l'ultimo segmento APP14 che vede. Inserite un segmento dopo un marker esistente e un valore esplicito del dizionario scavalca in silenzio un marker conflittuale nei dati, il che è esattamente il contrario di Table 13. HotPDF applica l'ordine di Table 13 sul percorso dell'intero image XObject e su quello dell'immagine inline alla stessa stregua
Potete chiamare direttamente lo stesso decoder terminale quando una singola immagine sembra sbagliata e volete vederne i campioni senza renderizzare la pagina. La funzione vive nell'unità HPDFHeadlessImageCodecs, prende il nome del filtro, i byte codificati, un dizionario parametri opzionale, e la geometria dal dizionario immagine, che deve combaciare con il frame header del JPEG
uses
  SysUtils, HPDFObjs, HPDFHeadlessImageCodecs;

// ColorTransform < 0 significa "voce assente": lasciate decidere ai marker JPEG
function DecodeDCT(const Encoded: TBytes; Width, Height, Channels,
  ColorTransform: Integer): TBytes;
var
  Parms: THPDFDictionaryObject;
begin
  Parms := nil;
  if ColorTransform >= 0 then
  begin
    Parms := THPDFDictionaryObject.Create(nil);
    Parms.AddNumericValue('ColorTransform', ColorTransform);
  end;
  try
    Result := HPDFDecodeHeadlessTerminalImage('DCTDecode', Encoded, nil, Parms,
      Width, Height, Channels, 8, 64 * 1024 * 1024, nil);
  finally
    Parms.Free;
  end;
end;
Il decoder è severo su cosa conta come valore legale. Un -1 esplicito, un 2, o un non intero come 0.5 solleva EHPDFHeadlessImageError invece di ripiegare su un default, perché un valore che la specifica non definisce non dà al decoder niente di affidabile su cui agire. Il controllo resta in piedi anche quando un marker Adobe nei dati rende la voce irrilevante, perché un valore non definito è un errore strutturale del documento stesso. Un budget troppo piccolo per la copia trasformata fallisce allo stesso modo, con un messaggio che nomina il budget di byte di lavoro
Un null esplicito è un caso diverso, perché non è affatto un valore. ISO 32000-1 §7.3.9 dice che una voce di dizionario il cui valore è null equivale a una voce assente, così /ColorTransform null ricade sul marker o sul default del numero di componenti esattamente come se la chiave mancasse. HotPDF lo tratta così su ogni percorso, headless e VCL, stream e inline alla stessa stregua
Un altro default merita una menzione, perché è il punto in cui HotPDF va deliberatamente oltre la lettera di Table 13. Un JPEG a tre componenti senza né header JFIF né marker Adobe, il cui frame header etichetta i suoi componenti R, G e B, dice nei propri byte che contiene RGB. Table 13 lo metterebbe comunque per default alla trasformazione, ma libjpeg e i reader costruiti su di esso lo decodificano senza trasformazione, e HotPDF fa lo stesso. I decoder headless e VCL lo trattano entrambi così, quindi il rosso e il blu restano dove i dati li hanno messi. Un 0 o 1 esplicito nel dizionario scavalca comunque questa inferenza
uses
  System.IOUtils;

var
  Jpeg, Stored, Converted, ByMarkers: TBytes;
begin
  // byte DCTDecode grezzi di un'immagine CMYK 640 x 480, salvati dallo stream del PDF
  Jpeg := TFile.ReadAllBytes('suspect-image.jpg');
  try
    // Con un marker Adobe APP14 nei dati, tutte e tre le chiamate concordano:
    // il marker decide e il valore del dizionario è ignorato
    Stored    := DecodeDCT(Jpeg, 640, 480, 4, 0);   // senza marker: campioni come compressi
    Converted := DecodeDCT(Jpeg, 640, 480, 4, 1);   // senza marker: YCCK disfatto in CMYK
    ByMarkers := DecodeDCT(Jpeg, 640, 480, 4, -1);  // senza marker: default quattro canali, nessuno
    Writeln(Format('pixel 0: stored %d,%d,%d,%d  converted %d,%d,%d,%d',
      [Stored[0], Stored[1], Stored[2], Stored[3],
       Converted[0], Converted[1], Converted[2], Converted[3]]));
  except
    on E: EHPDFHeadlessImageError do
      Writeln('Decoder refused the image: ', E.Message);
  end;
end;
Un pixel di riferimento a quattro canali mostra cosa cercare. Un pixel CMYK di (10, 20, 30, 40) memorizzato come YCCK torna come [245, 235, 225, 215] quando la conversione YCCK non viene disfatta e come [0, 116, 0, 215] quando viene disfatta. Il byte K, 215, è identico in entrambi. Se il piano K sembra giusto e gli altri tre no, una trasformazione disallineata è il primo sospetto
La convenzione CMYK invertita appartiene a /Decode
Il decoder terminale HotPDF restituisce i campioni CMYK esattamente come li produce libjpeg-turbo e non li ribalta sulla forza di un marker Adobe. I numeri di sopra rendono visibile la convenzione: 245, 235, 225, 215 sono semplicemente 255 meno 10, 20, 30, 40, la forma invertita che gli encoder in stile Adobe memorizzano. Riportarla a quantità di inchiostro è compito del dizionario immagine, dove un produttore che incorpora un JPEG simile dovrebbe scrivere /Decode [1 0 1 0 1 0 1 0]. Il renderer applica l'array /Decode a ogni componente, così un file scritto correttamente stampa correttamente
Il rovescio della medaglia merita di essere detto chiaro. Un PDF che incorpora un JPEG CMYK invertito alla Adobe senza l'array /Decode corrispondente uscirà come negativo in HotPDF, perché il file stesso descrive l'immagine in quel modo. Alcuni viewer rilevano il marker APP14 e compensano in silenzio. HotPDF non aggiunge quell'euristica, quindi la sistemazione per un file simile appartiene al software che l'ha scritto
Perché un solo dizionario DecodeParms per due filtri è un errore?
Uno stream il cui /Filter è un array di più stadi deve fornire /DecodeParms come array della stessa lunghezza, un dizionario parametri o null per stadio. ISO 32000-1 §7.3.8.2, Table 5, enuncia quella regola, e HotPDF la impone: uno stream multi-filtro che fornisce un solo dizionario condiviso viene riportato come documento non valido invece di essere decodificato
L'alternativa permissiva è peggiore di quel che sembra. Un decoder che controlla la lunghezza solo quando /DecodeParms è già un array, dato un dizionario singolo e due filtri, riusa quel dizionario a ogni stadio in silenzio. È innocuo quando il dizionario è vuoto e distruttivo quando non lo è: un /Predictor 12 pensato per lo stadio Flate interno verrebbe applicato anche a quello esterno, e l'output diventa spazzatura dall'aspetto plausibile invece di un errore pulito. Poiché l'intento di un file simile non è recuperabile, HotPDF lo rifiuta, anche nel caso vuoto, come uno stream di contenuto pagina con /Filter [/FlateDecode /FlateDecode] e /DecodeParms << >>
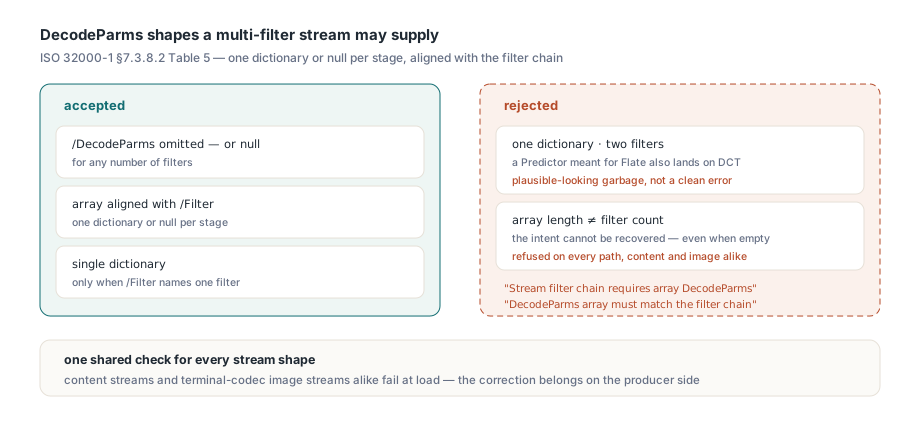
Le forme accettate e rifiutate sono facili da elencare:
- Accettato:
/DecodeParmsomesso, onull, per qualunque numero di filtri - Accettato: un array la cui lunghezza eguaglia il numero di filtri, ogni voce un dizionario o
null - Accettato: un dizionario singolo quando
/Filternomina esattamente un filtro - Rifiutato: un dizionario singolo condiviso da due o più filtri, con la diagnostica "Stream filter chain requires array DecodeParms"
- Rifiutato: un array la cui lunghezza differisce dal numero di filtri, con "DecodeParms array must match the filter chain"
Lo stesso controllo gira per gli stream di contenuto ordinari e per gli stream immagine il cui ultimo filtro è un codec terminale come DCTDecode, così una catena malformata fallisce nello stesso punto qualunque cosa lo stream porti. L'interazione con i limiti di decompressione è trattata in articolo su budget delle catene di filtri e decode bomb PDF. Dal codice applicativo, l'errore affiora quando la pagina viene renderizzata
uses
  SysUtils, HPDFHeadlessDocument, HPDFHeadlessCairoDevice;

var
  Document: THPDFHeadlessDocument;
  Options: THPDFHeadlessRenderOptions;
  Info: THPDFHeadlessRenderResult;
begin
  Document := THPDFHeadlessDocument.Create;
  try
    try
      Document.LoadFromFile('catalog-cmyk.pdf');
      Options := THPDFHeadlessRenderOptions.Default;
      Info := HPDFRenderHeadlessPagePNGFile(Document.GetRenderAccess(0),
        'page1.png', Options);
      Writeln('images=', Info.Images, ' decoded bytes=', Info.DecodedBytes);
    except
      on E: Exception do
        Writeln('Rejected: ', E.ClassName, ': ', E.Message);
    end;
  finally
    Document.Free;
  end;
end;
Le immagini JPEG 2000 conservano il loro /Decode esplicito
Un'immagine JPEG 2000 ignora /Decode solo quando il suo dizionario non ha /ColorSpace e non è una image mask. ISO 32000-1 §8.9.5 rende quello condizionale, e HotPDF lo segue. Buttare via /Decode per ogni immagine JPX non stencil è la scorciatoia facile, e fa semplicemente sparire un'inversione esplicita: un campione JPX DeviceGray di 64 sotto /Decode [1 0] deve uscire come 191, non 64
Azzeccare quella sola condizione non basta da sola. I rami di color space come Lab e ICCBased che impostano intervalli di componenti predefiniti ogni volta che l'immagine è JPX riscriverebbero una seconda volta un array applicato legittimamente, quindi il renderer registra se un array /Decode valido è stato davvero applicato, e riempie gli intervalli predefiniti solo quando non ne è stato applicato nessuno. Gli intervalli espliciti Lab e ICCBased sopravvivono quindi, e la dichiarazione di colore del codestream comanda comunque quando il dizionario tace. Il lato decoder del formato è descritto in articolo su JPEG 2000 e JPXDecode
Quali percorsi di decodifica seguono queste regole?
Entrambe le pipeline le seguono. Sul lato headless significa caricamento THPDFHeadlessDocument, il decoder stream condiviso, e il renderer di pagine basato su Cairo dietro HPDFRenderHeadlessPagePNGFile. Sul lato VCL significa estrazione delle immagini caricate in un TBitmap e renderizzazione di pagine VCL, che applicano lo stesso ordine di Table 13 nella decodifica a immagine intera e a regione ridotta allo stesso modo, così un header JFIF non può forzare YCbCr contro una transform Adobe di 0, e un valore illegale rende l'immagine indecifrabile anche lì. Le immagini DCT inline seguono le stesse regole di marker, null, default e rifiuto degli image XObject, con nomi chiave abbreviati e completi alla pari, incluso un dizionario /DP << … >> e array di filtri abbreviati come /F [/AHx /DCT], e un'immagine inline con parametri illegali viene saltata mentre il resto della pagina esce. La guida all'estrazione di immagini da un PDF caricato copre il resto della gestione filtri di quella API
Alcune note pratiche prima di fare affidamento su questo comportamento:
- la decodifica JPEG richiede una libreria TurboJPEG compatibile a runtime;
HOTPDF_TURBOJPEG_LIBRARYsostituisce il defaultturbojpeg.dllolibturbojpeg.so.0 - i controlli strutturali severi rifiutano file che reader permissivi aprono, in particolare il dizionario
/DecodeParmsvuoto condiviso, e la sistemazione per quei file sta dal lato produttore
Per un flusso di stampa con gestione del colore, la lezione pratica è breve. Scrivete JPEG CMYK con un /ColorTransform esplicito che concordi con qualunque marker Adobe nei dati più l'array /Decode che corrisponde alla loro memorizzazione, date a ogni stream multi-filtro un array /DecodeParms allineato agli stadi, e aspettatevi che HotPDF tenga i file a ciò che dicono davvero
Il loader headless, i decoder stream e il renderer di pagine Cairo mostrati qui viaggiano con l'HotPDF Delphi PDF component per Delphi, C++Builder e Lazarus, accanto al classico motore documenti VCL