Un utente digita Müller in una casella di ricerca, non ottiene nulla, copia lo stesso nome fuori dal PDF, lo incolla di nuovo nella casella, e all'improvviso ottiene risultati. Controllate entrambe le stringhe nel debugger e Length restituisce 6 per quella digitata e 7 per quella incollata. La parola digitata porta U+00FC, un'unica ü precomposta; il documento archivia una u semplice seguita da U+0308 COMBINING DIAERESIS. Entrambe si renderizzano come gli stessi glifi, e un confronto per unità di codice non le chiamerà mai uguali
Perché stringhe dall'aspetto identico si confrontano come diverse?
Unicode permette deliberatamente più di una codifica per lo stesso carattere astratto, e chiama le codifiche canonicamente equivalenti. Unicode Standard Annex #15 definisce due forme normali che contano per la ricerca: NFC, che preferisce i code point precomposti, e NFD, che spezza ogni carattere precomposto in una lettera base più i suoi segni combinanti in un ordine fisso. Le lettere latine con diacritici esistono in entrambe le forme. Così le sillabe Hangul, che possono comparire come una sillaba precomposta o come una sequenza di due o tre jamo congiungenti
Quale forma finisca in un PDF dipende dal software che l'ha prodotto, dalla piattaforma su cui girava, e a volte da come la mappa ToUnicode di un font è stata costruita. Un documento digitato su una macchina e modificato su un'altra può mescolare entrambe le forme sulla stessa pagina. Nulla di tutto questo è visibile alla persona che cerca. La sua tastiera e il suo metodo di input di solito producono NFC, quindi qualsiasi contenuto decomposto nel file diventa non ricercabile dal suo lato
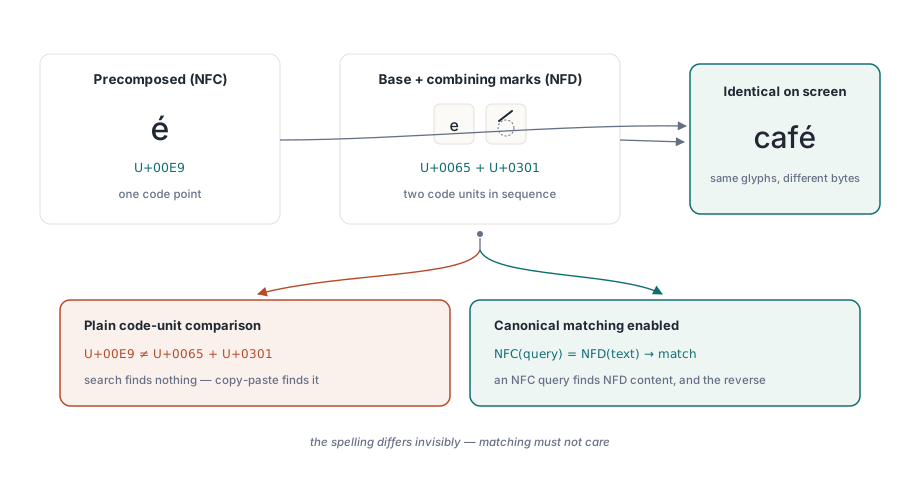
La soluzione ovvia è buttare il problema nello stesso secchio del case folding: minuscole su entrambi i lati, togliete gli accenti, confrontate. Si rompe per una ragione strutturale. Case folding e rimozione degli accenti sono uno a uno a livello di unità di codice, quindi il testo foldato ha esattamente la stessa lunghezza dell'originale e una corrispondenza alla posizione 17 nella copia foldata è una corrispondenza alla posizione 17 nel testo estratto. La normalizzazione cambia le lunghezze. Una lettera precomposta diventa due o tre unità di codice, una sequenza decomposta collassa di nuovo in una, le sillabe Hangul si espandono in jamo, e dopo quella trasformazione le posizioni che tornano indietro non puntano più al testo che avete estratto
Cercare con soCanonicalEquivalent in PDF Library for Delphi
In PDF Library for Delphi, il membro soCanonicalEquivalent di TPDFlibSearchOptions fa sì che SearchText confronti le decomposizioni canoniche della query e del testo di pagina, così una query NFC trova contenuto NFD e una query NFD trova contenuto NFC. L'opzione fa parte di un insieme, il che significa che si combina con soWholeWord, soCaseSensitive, soWildcards e soDiacriticInsensitive senza alcuna API separata:
uses
  SysUtils, Math, PDFlibrary;

var
  Lib: TPDFlib;
  Hits: array of TPDFlibSearchHit;
  Found, Stored, I: Integer;
  Slice: WideString;
begin
  Lib := TPDFlib.Create;
  try
    Lib.LoadFromFile('contracts.pdf', '');
    Lib.SearchContextChars := 24;      // riempie ContextBefore / ContextAfter
    SetLength(Hits, 500);

    Found := Lib.SearchText('Bäcker',
      [soCanonicalEquivalent, soWholeWord, soGraphemeClusters],
      '', Hits);                       // intervallo pagine vuoto = ogni pagina

    // Found conta ogni hit; solo i primi Length(Hits) sono stati copiati
    Stored := Min(Found, Length(Hits));
    for I := 0 to Stored - 1 do
    begin
      Slice := Copy(Hits[I].MatchText, Hits[I].MatchStart,
        Hits[I].MatchLength);
      Writeln(Format('page %d: [%s] %d code units, ...%s|%s|%s...',
        [Hits[I].Page, Slice, Hits[I].MatchLength,
         Hits[I].ContextBefore, Slice, Hits[I].ContextAfter]));
    end;
  finally
    Lib.Free;
  end;
end;
Due dettagli in quel ciclo fanno inciampare la gente. SearchText restituisce il numero totale di hit anche quando il buffer è più piccolo, quindi iterare fino a Found - 1 su un documento grande esce dal fondo di un array da 500 elementi; limitate con Min o passate a SearchTextEach, che consegna ogni hit a una callback e non ha bisogno di alcun buffer. E MatchText è l'intero blocco di testo che conteneva la corrispondenza, con MatchStart come indice a base 1 dentro di esso, quindi la parola trovata stessa è la Copy mostrata sopra
Eseguitelo contro un file che archivia Bäcker decomposto e la lunghezza stampata è 7, contro un file NFC è 6. Stessa query, stesso insieme di opzioni. La slice è sempre il testo così come sta nel documento
Dove atterra la corrispondenza nel testo originale
Quell'ultima proprietà è ciò che rende la ricerca normalizzata utilizzabile per qualsiasi cosa oltre a una risposta sì/no. PDF Library for Delphi registra, per ogni unità di codice che il normalizzatore produce, l'inizio e la fine dell'intervallo UTF-16 originale da cui proviene. Una decomposizione ricorsiva eredita l'intervallo del suo genitore, una composizione unisce gli intervalli dei suoi input, e quando una corrispondenza viene trovata la ricerca scandisce l'intervallo mappato per l'inizio più piccolo e la fine più grande
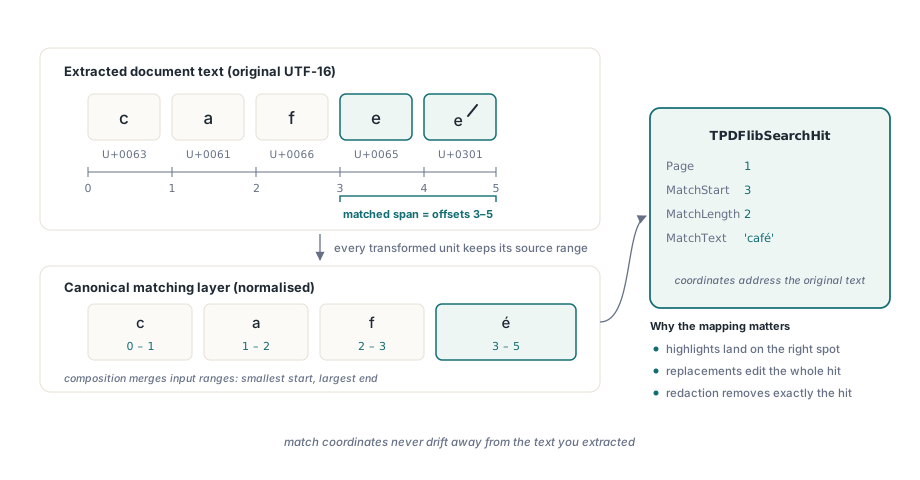
Di conseguenza, MatchStart, MatchLength, ContextBefore, ContextAfter ed entrambi i punti di ingresso di sostituzione puntano al testo estratto che il chiamante ha già. Una ricerca che potesse dire «c'è una corrispondenza in questo blocco» ma non esattamente dove andrebbe bene per un conteggio dei risultati e sarebbe sbagliata per tutto il resto: le evidenziazioni slitterebbero di un carattere o due per ogni lettera accentata, e una sostituzione riscriverebbe la sequenza di testo sbagliata
Il normalizzatore viaggia dentro la libreria. Porta tabelle compatte per decomposizione canonica, composizione e classe di combinazione canonica da Unicode 15.1, applica le regole algoritmiche per l'Hangul invece delle voci di tabella, e riordina i segni combinanti in modo stabile durante l'NFD. Nessun file di dati esterno viene caricato e nessuna chiamata di normalizzazione del sistema operativo viene fatta, così un servizio Windows, un demone Linux e una build Free Pascal restituiscono hit identici per lo stesso file. La preferiamo così anche se il sistema operativo potrebbe fare il lavoro su Windows: un indice di ricerca costruito su un server e interrogato su un altro non dovrebbe mai essere in disaccordo perché le due macchine giravano versioni Unicode diverse
L'opzione è spenta per impostazione predefinita, e quel predefinito è ragionevole. Costruire il testo NFD e la sua mappa di posizione costa tempo, e una ricerca su fatture solo ASCII non ne ha mai bisogno. Quando soCanonicalEquivalent è impostato, ogni blocco di testo tiene due copie trasformate, una con i segni combinanti e una senza, quindi un lotto di query sullo stesso blocco lo normalizza una volta. Il case folding semplice resta sul percorso più economico uno a uno
Cosa va storto quando una corrispondenza finisce dentro un carattere?
L'equivalenza canonica risponde a «è questo lo stesso testo», ma non dice nulla su dove a una corrispondenza è permesso fermarsi. Cercate un café decomposto per cafe con il solo soCanonicalEquivalent e le prime quattro unità di codice corrispondono; l'accento combinante che segue resta fuori dalla corrispondenza. soWholeWord non lo intercetta, perché i suoi caratteri parola seguono le regole degli identificatori (lettere ASCII, cifre e underscore) e un segno combinante conta come confine. L'evidenziazione copre cafe, e una sostituzione lascia un accento smarrito a galleggiare su ciò che viene dopo
La stessa cosa accade ben oltre gli accenti latini. Un'emoji bandiera è due code point regional indicator. Un'emoji famiglia è diverse persone unite da zero-width joiner. Un connettivo Devanagari è una consonante, un virama e un'altra consonante, e una vocale vietnamita può portare due segni impilati. Qualsiasi cosa fuori dal Basic Multilingual Plane è una coppia surrogata in UTF-16, e tagliarne una a metà produce un surrogato non accoppiato che molte pipeline di testo sostituiscono con U+FFFD
soGraphemeClusters richiede che entrambe le estremità di ogni corrispondenza, letterale o wildcard, cadano su confini di extended grapheme cluster come definiti da Unicode Standard Annex #29. La segmentazione copre l'accoppiamento CR/LF, i caratteri di controllo, i tipi di sillaba Hangul, Extend e SpacingMark, Prepend, le sequenze ZWJ delle emoji, le coppie di regional indicator e le interruzioni connettivo indiche, e non piazza mai un confine dentro una coppia surrogata. Con il flag impostato, cafe non corrisponde più affatto a un café decomposto; aggiungete soDiacriticInsensitive se il matching cieco agli accenti è ciò che volete davvero
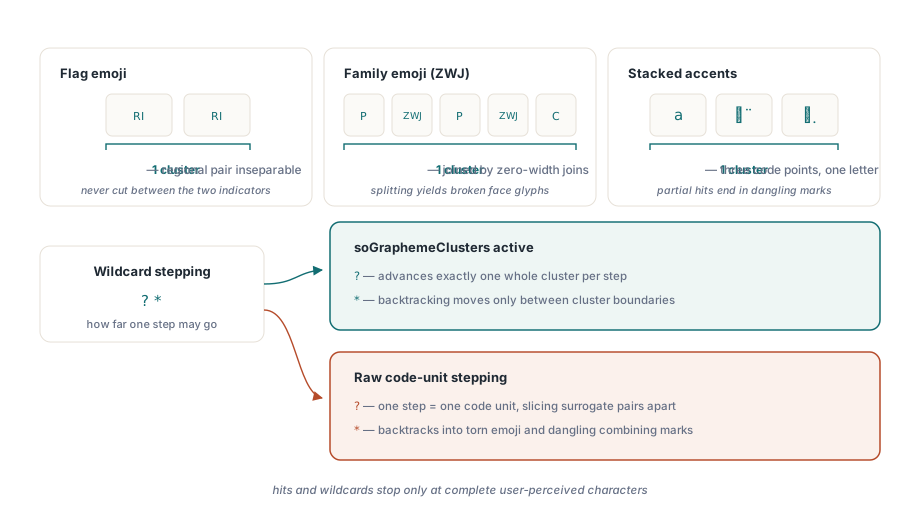
I wildcard sono dove il flag cambia i risultati in modo più visibile. Sotto soCanonicalEquivalent il testo di pagina viene confrontato in NFD, quindi côté diventa c o U+0302 t e U+0301 indipendentemente da come il file l'abbia archiviato. Senza soGraphemeClusters, la ? in c?té consuma esattamente una unità di codice, la o, poi si aspetta una t e trova U+0302. Nessuna corrispondenza. Con il flag, ? avanza di un intero cluster e il backtracking per * si muove pure solo tra confini di cluster:
// "?" avanza di un carattere percepito dall'utente, quindi questo trova côté
// che il PDF l'abbia archiviata precomposta o decomposta
Found := Lib.SearchText('c?té',
  [soWildcards, soCanonicalEquivalent, soGraphemeClusters], '', Hits);

// La sostituzione usa gli stessi intervalli sicuri per cluster, quindi non
// spezza mai un'emoji né lascia dietro un accento orfano
Replaced := Lib.SearchAndReplaceTextInContent('naïve', 'plain',
  [soCanonicalEquivalent, soGraphemeClusters], '1-20');
if Replaced = 0 then
  Writeln(Lib.GetLastUnicodeReplacementDiagnostics)
else
  Lib.SaveToFile('contracts-edited.pdf');
SearchAndReplaceTextInContent riscrive il testo dentro il contenuto della pagina e restituisce il numero di corrispondenze sostituite. Quando restituisce zero, GetLastUnicodeReplacementDiagnostics dice perché, per esempio che una corrispondenza non poteva essere rimappata al contenuto che l'ha disegnata. L'altro punto di ingresso, SearchAndReplaceText, accetta lo stesso insieme di opzioni e disegna la sostituzione sopra il blocco trovato invece
Scegliere un insieme di opzioni per carico di lavoro
Tre combinazioni coprono la maggior parte delle applicazioni. Per una casella di ricerca per utente finale dentro un visualizzatore di documenti, usate soCanonicalEquivalent più soDiacriticInsensitive: entrambe le forme di codifica corrispondono, e così le grafie accentate e non accentate, che è ciò che la gente si aspetta dopo anni di ricerca web. Per la revisione legale o di conformità, dove un falso positivo costa a qualcuno un pomeriggio, usate soCanonicalEquivalent con soCaseSensitive e soWholeWord e lasciate spento il folding degli accenti, così l'equivalenza resta esatta ignorando come il file l'abbia codificata
Per qualsiasi cosa modifichi il documento, aggiungete soGraphemeClusters ogni volta. Questo è l'unico posto che non lasceremmo al gusto. Una ricerca che restituisce un intervallo corto di una unità di codice inganna solo la persona che legge i risultati; una sostituzione o rimozione che usa lo stesso intervallo scrive l'errore nel file, e nessuno se ne accorge finché la pagina non viene stampata o estratta di nuovo. La rimozione che deve distruggere contenuto anziché coprirlo è un discorso a sé, coperto in vera redaction e rimozione del contenuto
Quando più termini girano contro lo stesso documento, preferite SearchTextBatch. Valuta ogni query non vuota mentre i blocchi di testo di una pagina sono residenti, quindi ogni pagina viene estratta una volta e ogni blocco normalizzato una volta, e ogni query porta il proprio insieme di opzioni:
var
  Queries: array[0..2] of TPDFlibSearchQuery;
  BatchHits: array of TPDFlibSearchBatchHit;
  Count, I: Integer;
begin
  Queries[0].Query := 'Müller';
  Queries[0].Options := [soCanonicalEquivalent, soDiacriticInsensitive];
  Queries[1].Query := '서울';                // Hangul: NFC o jamo nel file
  Queries[1].Options := [soCanonicalEquivalent, soGraphemeClusters];
  Queries[2].Query := 'Nguyễn';
  Queries[2].Options := [soCanonicalEquivalent, soCaseSensitive,
    soWholeWord, soGraphemeClusters];

  SetLength(BatchHits, 2000);
  Count := Min(Lib.SearchTextBatch(Queries, '', BatchHits),
    Length(BatchHits));
  for I := 0 to Count - 1 do
    Writeln(Format('query %d -> page %d',
      [BatchHits[I].QueryIndex, BatchHits[I].Hit.Page]));
end;
Gli hit tornano ordinati per pagina, poi blocco, poi query, e QueryIndex è la posizione a base zero nell'array che avete passato. SearchTextBatchEach è la forma a callback per insiemi di risultati che non potete dimensionare in anticipo. Come vengono estratti in primo luogo i blocchi di testo è descritto in ricerca testo ed enumerazione degli elementi di pagina
Scritture dove l'equivalenza canonica non è opzionale
Per il coreano, l'equivalenza canonica decide se un nome viene trovato affatto, perché sillabe precomposte e jamo decomposti compaiono entrambi nei documenti reali. Il vietnamita impila un segno tonale sopra una vocale che può già portare una breve o un circonflesso, quindi la sua forma di composizione dipende interamente dal producer. Per il Devanagari, il bengalese e le altre scritture indiche, le regole dei connettivi decidono se un confine di corrispondenza atterra in un punto che un lettore riconosce. Giapponese e cinese sono relativamente facili sul lato ricerca, anche se il lato layout non lo è, come copre la scrittura verticale per giapponese e cinese
Il nostro consiglio è diretto. Se il corpus contiene una qualsiasi lingua diversa dall'inglese, accendete soCanonicalEquivalent per primo e spegnetelo solo dopo averlo cronometrato sui vostri documenti e aver trovato il costo inaccettabile. Il fallimento che previene atterra esattamente sui nomi che i vostri utenti cercano più spesso
Lo stesso motore consapevole di Unicode muove ricerca, estrazione, sostituzione e redaction da Delphi, C++Builder e Free Pascal; insiemi di opzioni, API batch e il resto del toolkit testo sono elencati sulla pagina prodotto di PDF Library for Delphi