Costruisci un PDF il cui albero dei nomi /Dests abbia una radice con due figli. Il primo figlio dichiara /Limits [(a) (z)], e il suo array /Kids punta dritto indietro alla radice. Il secondo figlio tiene la voce reale per (chapter7), ma i suoi limiti sono scritti al contrario: [(z) (a)]. Chiedete a una ricerca da manuale di name tree chapter7 e o ricorre finché lo stack non si esaurisce o risponde "non trovato" per una destinazione alla quale un viewer può saltare. L'intero file sta in circa due kilobyte, e ogni oggetto al suo interno si parserizza pulito
Quel file impacchetta tre trappole separate in una struttura sola: un ciclo /Kids, un intervallo che rivendica una chiave che non tiene, e un intervallo che non può combaciare con niente. Una quarta trappola richiede un file molto più grande. Appena una singola foglia porta più di 32.768 coppie nome/valore, qualsiasi codice che stipi "quale foglia" e "quale voce" in un solo intero a 32 bit inizia a puntare alla coppia sbagliata. Il resto dell'articolo attraversa ogni trappola, cosa dovrebbe fare un lettore, e come si comportano le chiamate Delphi su file costruiti così
Quattro funzionalità PDF che poggiano su alberi dei nomi e number tree
Gli alberi dei nomi e i number tree sorreggono ogni funzionalità PDF che mappa un grande insieme di chiavi a oggetti, e PDFlibPas, la PDF Library di losLab per Delphi, ne espone quattro attraverso metodi pubblici di TPDFlib. ISO 32000-1 §7.9.6 definisce il name tree (chiavi stringa, Table 36) e §7.9.7 il number tree (chiavi intere, Table 37). Radice e nodi intermedi portano /Kids; le foglie portano coppie chiave/valore ordinate in /Names o /Nums; ogni nodo non radice dovrebbe portare un array /Limits a due elementi con la chiave più piccola e più grande sotto di lui
| Albero | Dove vive | Specificazione | API di lettura PDFlibPas |
|---|---|---|---|
| Named destinations | /Dests nel dizionario dei nomi | §12.3.2.3 | GetNamedDestination, poi GetDestPage / GetDestType |
| Etichette di pagina | /PageLabels nel catalogo (number tree) | §12.4.2 | GetPageLabel |
| Allegati | /EmbeddedFiles nel dizionario dei nomi | §7.7.4, §7.11.4 | EmbeddedFileCount, GetEmbeddedFileStrProperty |
| JavaScript a livello di documento | /JavaScript nel dizionario dei nomi | §7.7.4 | GlobalJavaScriptCount, GlobalJavaScriptPackageName |
Due righe nascondono una piega. Le named destinations esistono anche in una forma più vecchia del PDF 1.1, un semplice dizionario /Dests nel catalogo indicizzato da oggetti nome, e GetNamedDestination controlla prima quel dizionario e solo dopo scende nell'albero dei nomi del PDF 1.2. La riga JavaScript ha un quasi omonimo che legge tutt'altro: GetDocJavaScript restituisce gli script attaccati ai trigger del documento nel dizionario /AA del catalogo (WS, DS, WP, DP, DC), mentre i pacchetti nominati che girano all'apertura di un documento vivono nell'albero dei nomi /JavaScript e vengono elencati da GlobalJavaScriptPackageName
Tutte queste strutture vengono dal file. La specifica dice a chi scrive cosa deve produrre, e un lettore riceve comunque ciò che lo scrittore, un salvataggio incrementale bacato o un fuzzer ci hanno davvero messo. È la stessa lezione di irrobustire un parser PDF Pascal contro file ostili, applicata alla forma dell'albero invece che alle lunghezze dei buffer
Perché un array /Kids ciclico manda in crash un percorritore ricorsivo?
Un percorritore ricorsivo va in crash su un array /Kids ciclico perché nulla nella ricorsione ricorda quali nodi ha già attraversato, così un riferimento figlio a un antenato trasforma un file finito in una discesa infinita. Un albero legittimo può fare lo stesso danno senza alcun ciclo: una catena a 4.096 livelli di nodi a figlio singolo è sintassi valida che costa a un lettore ricorsivo 4.096 frame di stack
La variante più mite non va in crash affatto. Quando due voci /Kids riferiscono la stessa foglia, un'enumerazione ingenua la visita due volte, così un conteggio di allegati torna più alto del numero di file nel documento e una lista di script mostra lo stesso pacchetto due volte
PDFlibPas percorre entrambi i tipi di albero con uno stack esplicito last-in, first-out sull'heap più un insieme dei visitati indicizzato per identità del dizionario. Un nodo viene marcato quando viene estratto. Un riferimento ciclico può stare nello stack per un attimo, ma viene scartato appena riaffiora, e ogni nodo distinto espande i propri figli esattamente una volta. Il lavoro totale è limitato dal numero di dizionari distinti più la lunghezza combinata dei loro array /Kids; una catena a 4.096 livelli diventa 4.096 iterazioni di ciclo e 4.096 voci in un hash set
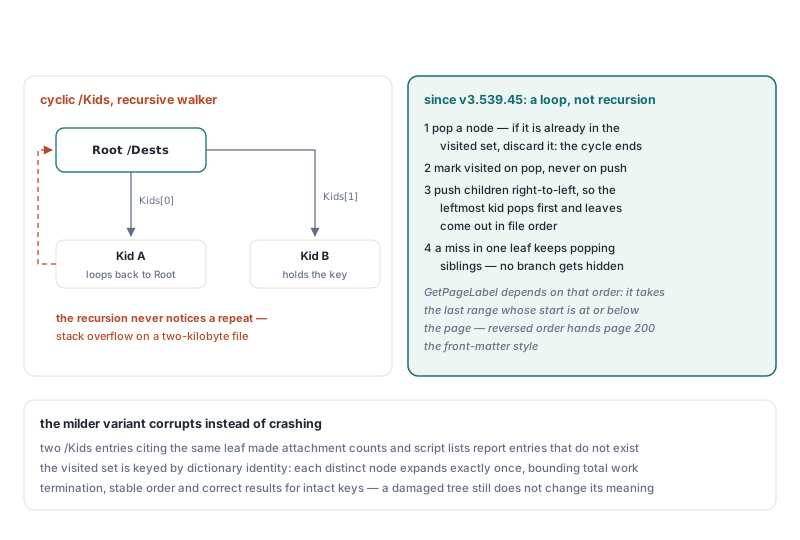
L'ordine è la parte dove la gente sbaglia quando converte la ricorsione in un ciclo. Uno stack capovolge ciò che gli dai, quindi i figli vanno inseriti dall'ultimo indice al primo; poi il figlio più a sinistra esce per primo e le foglie arrivano nell'ordine da sinistra a destra in cui il produttore le ha scritte. Marcare all'estrazione anziché all'inserimento conta per lo stesso motivo. Con marche all'inserimento e inserimenti da destra a sinistra, una foglia condivisa dalle posizioni 0 e 2 verrebbe rivendicata dalla posizione 2, e le sue voci comparirebbero più tardi di quanto il file dice. Le etichette di pagina dipendono da quell'ordine, come mostra l'ultima sezione
Se scrivete codice di alberi vostro contro qualche altro object model, questa è la forma che raccomandiamo. Il tipo nodo qui sotto è deliberatamente astratto, ed entrambe le funzioni sono codice lato lettore, non chiamate di libreria
uses
  System.Generics.Collections;

type
  TTreeNode = class
  public
    Kids: TArray<TTreeNode>;   // vuoto su una foglia
    Keys: TArray<string>;      // chiavi foglia, ordinate da un produttore per bene
    Values: TArray<Integer>;   // parallelo a Keys
    HasLimits: Boolean;
    LoKey, HiKey: string;
  end;

// Helper tuo: /Limits può potare solo quando è una coppia ben formata e ordinata
function LimitsExclude(Node: TTreeNode; const Key: string): Boolean;
begin
  Result := Node.HasLimits and (Node.LoKey <= Node.HiKey) and
    ((Key < Node.LoKey) or (Key > Node.HiKey));
end;

// Ricerca tua: stack esplicito, insieme dei visitati, marcate all'estrazione
function FindValue(Root: TTreeNode; const Key: string;
  out Value: Integer): Boolean;
var
  Pending: TList<TTreeNode>;
  Visited: TDictionary<TTreeNode, Byte>;
  Node: TTreeNode;
  I: Integer;
begin
  Result := False;
  Value := 0;
  if Root = nil then
    Exit;
  Pending := TList<TTreeNode>.Create;
  Visited := TDictionary<TTreeNode, Byte>.Create;
  try
    Pending.Add(Root);
    while Pending.Count > 0 do
    begin
      Node := Pending[Pending.Count - 1];
      Pending.Delete(Pending.Count - 1);
      if Visited.ContainsKey(Node) then
        Continue;                      // ciclo o figlio condiviso: già visto
      Visited.Add(Node, 0);
      if Length(Node.Kids) > 0 then
      begin
        // Inserisci da destra a sinistra così il kid più a sinistra esce per primo
        for I := High(Node.Kids) downto 0 do
          if (Node.Kids[I] <> nil) and not LimitsExclude(Node.Kids[I], Key) then
            Pending.Add(Node.Kids[I]);
      end
      else
        for I := 0 to High(Node.Keys) do
          if (Node.Keys[I] = Key) and (I <= High(Node.Values)) then
          begin
            Value := Node.Values[I];
            Exit(True);
          end;
      // Un mancato ritrovato in questa foglia: continua a pescare i suoi fratelli
    end;
  finally
    Visited.Free;
    Pending.Free;
  end;
end;
Un mancato ritrovato in un ramo non dice niente sull'albero
La scorciatoia di ricerca più comune sceglie il primo figlio i cui /Limits coprono la chiave, scende lì dentro, e non guarda mai più un fratello. Su un albero pulito è corretto e veloce. Sul file del paragrafo d'apertura fallisce: il primo figlio rivendica chapter7, rimanda alla radice, e la ricerca finisce a mani vuote mentre il fratello successivo tiene la voce
PDFlibPas non si ferma al primo ramo plausibile. La ricerca con chiave dietro GetNamedDestination inserisce ogni figlio il cui intervallo non esclude la chiave, e continua a pescare finché non trova una corrispondenza o lo stack si svuota. Su un albero ben formato con intervalli disgiunti, al massimo un figlio sopravvive al controllo di intervallo a ogni livello, quindi il costo extra è nullo. Su uno danneggiato sono poche visite di nodo in più, e la risposta torna giusta
Le foglie ricevono lo stesso trattamento. ISO 32000-1 richiede che le chiavi in un array /Names siano ordinate per valore di byte, quindi la libreria prova prima una ricerca binaria. Quando quella manca, ripiega su una scansione lineare delle coppie, perché una foglia fuori ordine altrimenti renderebbe invisibile una chiave presente. Pagare una scansione lineare a ogni mancato ritrovato genuino è un costo che accettiamo: le ricerche per nomi davvero assenti sono rare, e un falso "non trovato" su un link funzionante costa molto più di un passaggio in più su una foglia
Una contraddizione strutturale viene gestita con il rifiuto. La Table 36 consente a un nodo di portare o /Kids o /Names, mai entrambi. Una ricerca con chiave tratta un nodo che porta entrambi come malformato e lo salta invece di indovinare quale metà intendesse il produttore. L'enumerazione dei number tree, come il percorso dietro GetPageLabel, è più indulgente e segue /Kids quando entrambi sono presenti, dato che buttare via un intervallo intero etichetterebbe male ogni pagina successiva
Di cosa può fidarsi un lettore riguardo a /Limits?
Un lettore può fidarsi di /Limits per saltare lavoro, e solo quando la coppia è ben formata; non può mai usare la voce per concludere che una chiave è assente. La Table 36 dice che i nodi intermedi e foglia devono portarla, eppure in pratica la voce sparisce dopo modifiche a mano, tiene numeri dentro un albero dei nomi, o arriva con i bordi invertiti. PDFlibPas risolve ognuno di questi casi allo stesso modo, tenendo il figlio ricercabile
/Limitsmancanti: un controllo di intervallo che salta un figlio del genere rende il suo intero sottoalbero irraggiungibile ogni volta che un produttore dimentica la voce, quindi il figlio viene cercato- Tipo sbagliato o lunghezza sbagliata, come numeri in un albero dei nomi o un array a un elemento: gestito esattamente come una voce mancante
- Bordi invertiti come
[(Z) (A)]o[9 0]: nessuna chiave soddisfaLo <= Key <= HiquandoLo > Hi, quindi fidarsi della coppia escluderebbe il ramo per ogni ricerca; un intervallo pota solo quando il proprio bordo inferiore non supera il bordo superiore - Ben formata e ordinata: usata per saltare il ramo, che è ciò per cui la voce esiste
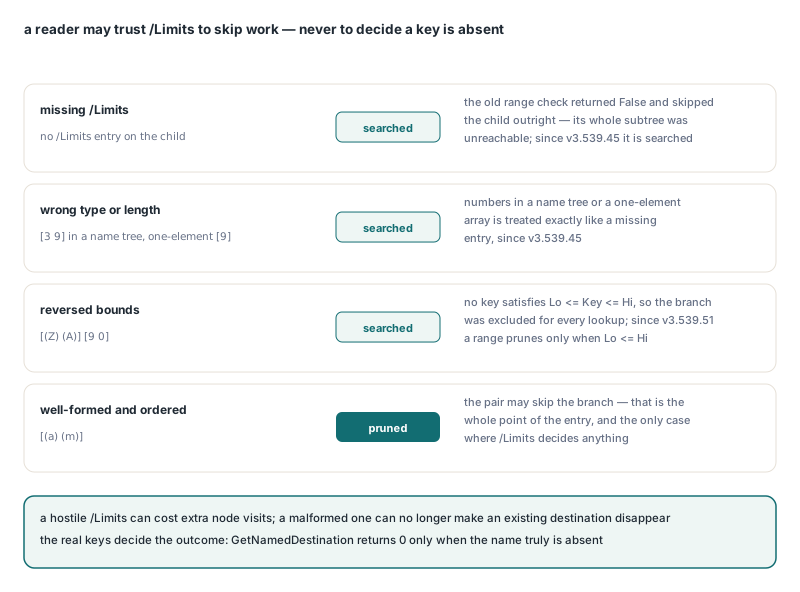
Dal lato del chiamante ci sono due zeri da distinguere. GetNamedDestination restituisce 0 quando il nome è davvero assente e un ID di destinazione altrimenti. Un GetDestPage che restituisce 0 per un ID valido significa che il nome esiste ma il suo bersaglio non si risolve in una pagina di questo documento, il che è una segnalazione di difetto diversa. GetDestType riporta la vista come 1 per XYZ, 2 per Fit e così via fino a 8 per FitBV
uses
  PDFlibrary;

procedure LookUpDestination(const FileName, DestName: string);
var
  Lib: TPDFlib;
  DestID, Page: Integer;
begin
  Lib := TPDFlib.Create;
  try
    if Lib.LoadFromFile(FileName, '') <> 1 then
    begin
      WriteLn('Load failed, error ', Lib.LastErrorCode);
      Exit;
    end;
    // Prima il /Dests del catalogo (PDF 1.1), poi l'albero dei nomi /Dests
    DestID := Lib.GetNamedDestination(DestName);
    if DestID = 0 then
    begin
      WriteLn('No destination named ', DestName);
      Exit;
    end;
    Page := Lib.GetDestPage(DestID);
    if Page = 0 then
      WriteLn(DestName, ' exists but does not resolve to a page')
    else
      WriteLn(DestName, ' -> page ', Page,
        ', view type ', Lib.GetDestType(DestID));  // 1 = XYZ, 2 = Fit ...
  finally
    Lib.Free;
  end;
end;
Questo è un controllo di regressione compatto. Costruite il file a due figli del paragrafo d'apertura, puntate la voce reale chapter7 alla pagina 2 con una vista /Fit, e la procedura dovrebbe stampare pagina 2 con tipo di vista 2. Una ricerca al primo combaciamento stampa "No destination" perché il figlio ciclico vince la corsa; una ricerca che si fida degli intervalli invertiti stampa la stessa cosa per il motivo opposto. Una volta che le destinazioni si risolvono, le voci di outline che puntano a loro sono coperte in leggere le azioni di segnalibri e annotazioni PDF in Delphi
Foglie oltre le 32.768 voci e la trappola dell'indice impacchettato
Quando il codice richiede un handle intero unico per "voce N nella foglia M", la codifica allettante stipa la posizione della foglia nei 16 bit alti di un Integer e l'offset dentro l'array /Names di quella foglia nei 16 bit bassi. Ogni coppia occupa due slot dell'array. L'indice di coppia 32.768, la coppia numero 32.769, parte quindi all'offset 65.536, che è $10000. Quel bit riporta nella metà alta, e il decoder lo rilegge come offset 0 della foglia successiva
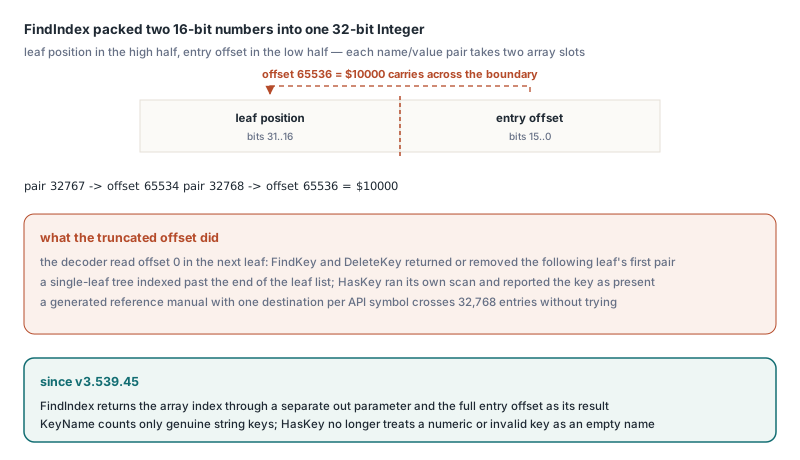
I sintomi dipendono dalla forma dell'albero. Con una foglia singola non c'è foglia successiva, quindi l'handle decodificato indicizza oltre la fine della lista di foglie. Con più foglie, un find o un delete atterra sulla prima coppia della foglia seguente, mentre una semplice scansione per chiave continua a riportare la chiave richiesta come presente. File di questa taglia non sono esotici. Un riferimento API generato con una named destination per simbolo supera le 32.768 voci in fretta, e alcuni produttori scrivono tutte in un'unica foglia piatta invece di bilanciare l'albero
PDFlibPas tiene la posizione della foglia e l'offset della voce in due interi a larghezza piena, quindi nessuno dei due può traboccare nell'altro a qualsiasi dimensione di foglia. Lo stesso lettore conta solo chiavi stringa genuine. Per una foglia come [(Valid) 42 123 456], EmbeddedFileCount riporta 1, la chiave numerica 123 non viene mai scambiata per un nome vuoto, e un indice di 0 o sotto restituisce una stringa vuota da GetEmbeddedFileStrProperty invece di qualsiasi oggetto capiti dopo. Il tag 1 di quella funzione è il nome del file e il tag 2 il sottotipo MIME
procedure AuditTrees(const FileName: string);
var
  Lib: TPDFlib;
  I: Integer;
begin
  Lib := TPDFlib.Create;
  try
    if Lib.LoadFromFile(FileName, '') <> 1 then
      Exit;
    // Number tree /PageLabels; i file senza restituiscono numeri di pagina semplici
    for I := 1 to Lib.PageCount do
      WriteLn('Page ', I, ' label: ', Lib.GetPageLabel(I));
    // Albero dei nomi /EmbeddedFiles; indici a base 1, chiavi non stringa saltate
    for I := 1 to Lib.EmbeddedFileCount do
      WriteLn('Attachment ', I, ': ', Lib.GetEmbeddedFileStrProperty(I, 1),
        ' (', Lib.GetEmbeddedFileStrProperty(I, 2), ')');  // nome, sottotipo MIME
    // Albero dei nomi /JavaScript: elenca i nomi dei pacchetti, non esegue nulla
    for I := 1 to Lib.GlobalJavaScriptCount do
      WriteLn('Script package: ', Lib.GlobalJavaScriptPackageName(I));
  finally
    Lib.Free;
  end;
end;
Un file di test a due pagine mostra bene l'output atteso. Date al suo radice /PageLabels un array /Kids che elenca una foglia due volte e riferisce anche la radice stessa, con intervalli per il romano minuscolo dalla pagina 1 e per il decimale con prefisso A- dalla pagina 2. L'audit dovrebbe stampare i e A-1, ogni intervallo applicato una volta. Scrivere etichette di pagina in un albero simile ha le sue proprie pieghe, coperte in correggere le etichette di pagina PDF conservate in number tree /Kids; AddPageLabels appiattisce un radice /Kids in un'unica foglia /Nums prima di inserire, usando la stessa enumerazione sicura dai cicli
Dove il percorso di attraversamento traccia i propri confini
L'attraversamento garantisce terminazione, ordine stabile e risposte corrette per qualsiasi albero le cui chiavi reali siano intatte. Legge un albero danneggiato così com'è scritto e non prova a ricostruire cosa intendesse l'autore, e da quella scelta seguono cinque conseguenze
- L'identità, non il contenuto, definisce un nodo. Due dizionari distinti con voci identiche sono due nodi, così un produttore che copia una foglia invece di referenziarla prende quelle voci due volte
- Una coppia
/Limitsben formata e ordinata pota anche quando è sbagliata. Un intervallo che mente in modo plausibile, diciamo[(a) (m)]sopra una foglia che tiene anche(q), nascondeq. L'unica difesa sarebbe ignorare/Limitsovunque e scansionare ogni foglia, e su un albero di destinazioni con decine di migliaia di voci questo butta via il motivo per cui la voce esiste. Noi continuiamo a potare - L'enumerazione conserva l'ordine del file.
GetPageLabelpercorre ogni intervallo enumerato e applica l'ultimo il cui indice di partenza è alla pagina o sotto, quindi un produttore che scrive gli intervalli fuori ordine ottiene semantica da ordine di file, e invertire il percorso consegnerebbe alla pagina 200 lo stile del frontespizio - La memoria cresce con i nodi e le voci distinti. L'attraversamento aggiunge una lista e un hash set sopra gli oggetti parserizzati
- Le chiavi duplicate dentro una foglia si risolvono in modo deterministico: la ricerca binaria restituisce la coppia corrispondente su cui atterra per prima, e il ripiego lineare conserva l'ultima corrispondenza che scansiona
Gli strumenti di preflight, gli archiviatori e i viewer di documenti leggono questi alberi prima che una singola pagina venga renderizzata, il che li mette in prima fila per qualsiasi cosa arrivi in una coda di upload. I lettori di alberi descritti qui vengono con PDFlibPas, la PDF Library per Delphi, che si compila sia con Delphi sia con Free Pascal